2.2 堆栈型、累加器型与寄存器型:操作数从哪来
2.2 堆栈型、累加器型与寄存器型:操作数从哪来
本节摘要:本节换一把尺子给指令集分类:不看指令强不强,看操作数要不要写进指令。堆栈型、累加器型、寄存器型三种谱系对应零地址、一地址、三地址三种编码风格。读完你应当能亲手用三种风格算同一个表达式,并解释为什么 Java 虚拟机选了堆栈、而物理芯片几乎全数倒向寄存器。
操作数放在哪决定机器长相
2.1 节按指令复杂度分了阵营,本节的尺子更基础:一条指令里的操作数字段,究竟要写多少。什么都不写,默认操作数在堆栈顶上,叫零地址风格,机器是堆栈型;只写一个,另一个隐含在累加器里,叫一地址风格,机器是累加器型;把两三个操作数全写明,叫三地址风格,机器是寄存器型。三种风格算同一道题 C = A + B,指令长相天差地别:
; 堆栈型(JVM 字节码风格) iload_1 ; 把 A 压栈 iload_2 ; 把 B 压栈 iadd ; 弹出两个数相加,结果压栈 istore_3 ; 弹出结果存入 C ; 累加器型(经典 8 位机风格,示意) lda A ; 累加器 = A add B ; 累加器 = 累加器 + B sta C ; C = 累加器 ; 寄存器型(RISC-V 风格) lw t0, A ; t0 = A lw t1, B ; t1 = B add t2, t0, t1 ; t2 = t0 + t1 sw t2, C ; C = t2
三种风格指令条数相当,但每条指令的字节数、访存次数、中间变量管理方式完全不同。这正是"操作数放哪"这把尺子的威力:它直接决定指令编码的宽度下限。
三种风格的对账单
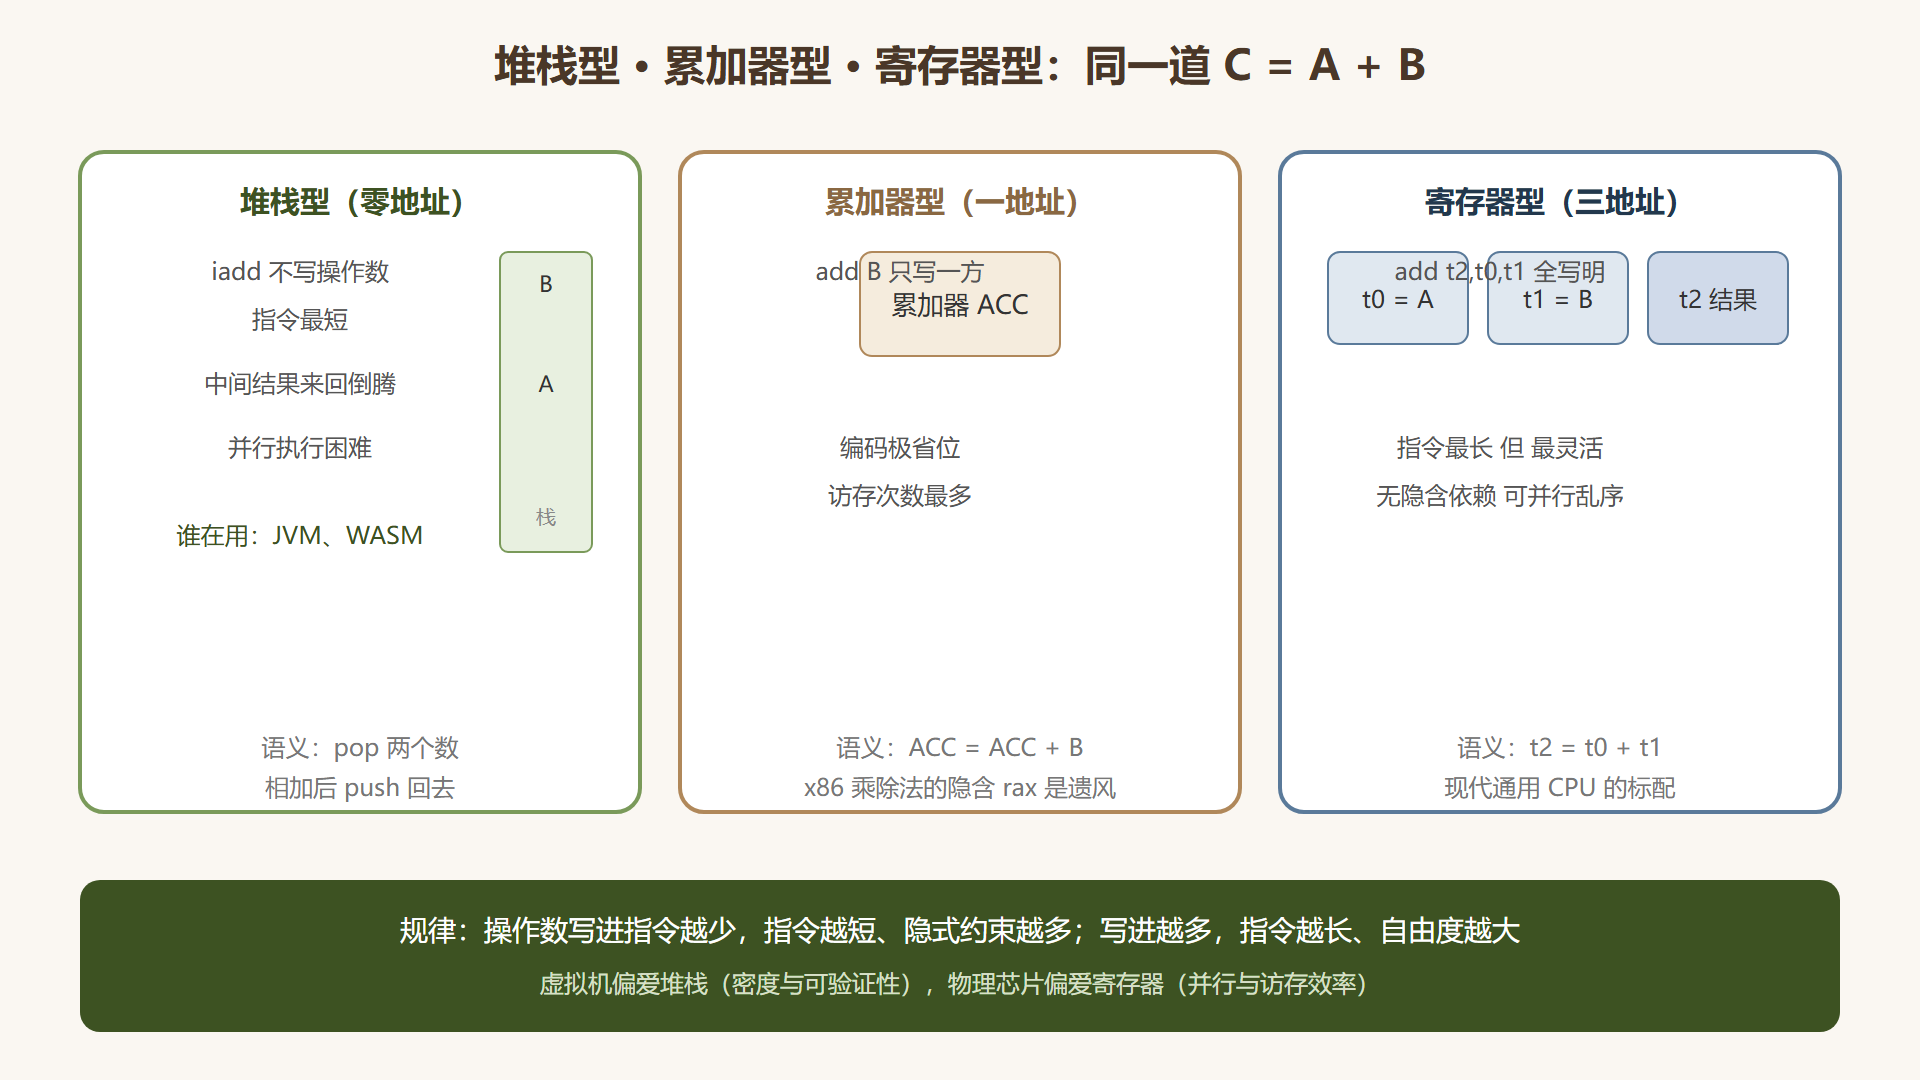
堆栈型指令最短——iadd 连操作数都不用写,一个字节的操作码就完事,因为数据永远隐式地从栈顶进出。代价是真实存在:栈顶是全机唯一的工作窗口,想算 (A+B) * (C+D) 就得来回压弹、倒腾中间结果,编译器要生成大量栈操作;想并行执行多条运算更是难题,因为数据依赖被硬锁在栈顶串行化。这就是为什么堆栈风格在物理芯片上几近绝迹,却在虚拟机指令集里大放异彩——Java 字节码、WebAssembly、早期的 Python 字节码都选了堆栈:代码密度极高、格式与机器无关、验证器容易写(栈深度可静态验证,类型安全好检查)。虚拟机不在乎栈顶串行,反正解释器或 JIT 自会把它变成寄存器操作。
累加器型是历史中间态:芯片上只配一个可见的通用工作寄存器,所有运算默认拿它当一方,编码只需写另一方。6502、8080 那一代机器皆如此。它的编码省位到极致——8 位机里 add B 可以只有一个字节——但累加器成了瓶颈,每步运算前后都要从内存倒腾数据,访存次数是三种风格里最多的。今天它主要活在教学与超低功耗的怪异芯片里,x86 的一些单操作数指令(如乘除法隐含使用 rax)算是祖先留下的尾巴。
寄存器型把操作数全部写明,指令最长,但换来三样东西:编译器有充分的自由度安排数据、减少访存;运算之间没有隐含依赖,硬件可以并行乱序;中间结果可以一直留在寄存器里不碰内存。现代通用处理器清一色寄存器型,不是偶然——当晶体管预算充足时,"指令变长"是三种代价里最便宜的。
图 2-1:三种风格的取数方式与代价对比
混血才是常态
现实中的指令集常在谱系间游走。x86 名义上是寄存器型,却保留着一批单操作数指令:mul rbx 只写一个操作数,另一方隐含在 rax 与 rdx 里——这是累加器血统的显性残留。x87 浮点栈更是完整的堆栈型孤岛:浮点寄存器按栈组织,fadd st(1) 在栈顶与栈内某格之间运算,编译器至今要小心维护它的栈状态。读老代码、写内联汇编时认出这些"祖先的口音",能省掉大量困惑。
反过来,堆栈风格也没死——它只是搬进了软件。Java 字节码在 JIT 编译后照样变成寄存器操作跑在物理核上;WebAssembly 引擎在验证完栈语义后同样降级为机器码。堆栈编码成了"传输格式",寄存器编码成了"执行格式":两种风格从对手变成了流水线上下游。
容易踩的坑
最常见的坑是拿"指令条数"当效率指标。上面对账单里寄存器型指令最多,但访存次数未必最多——真正的成本大头在访存,不在取指。第二条坑是以为 x87 浮点栈已成为历史就可以忽略:32 位程序、古老的数值库、以及某些反汇编输出里它仍然活跃,混用 x87 与 SSE 浮点还会引发精度不一致的诡异缺陷(4.3 节有专门讨论)。第三条坑出现在写虚拟机或解释器的人身上:堆栈编码虽好,别把物理执行也做成逐条解释——栈顶串行化会把性能钉死,务必在验证后降级到寄存器操作。
亲手推演:同一个表达式的新变式
把推演升级一档:算 D = (A + B) * (C + E)。堆栈型机器的指令序列是压 A、压 B、加、压 C、压 E、加、乘、存 D——注意中间结果 A+B 一直躺在栈里等第二个加法,这正是栈顶串行化的现场:两套加法互不依赖,本可以并行,却被迫排队。寄存器型机器三路并行开足:t0 加 t1、t2 加 t3、再乘、再存——依赖图里只有乘法一个汇合点,乱序核心能自由安排。累加器型最惨:算完 A+B 要先把中间值存进临时内存,再取 C、加 E、乘临时值、存 D,访存次数翻倍。这道题建议亲手在纸上把三种序列都写一遍——十分钟的手推,胜过十页论证,你会当场看清"操作数放哪"如何决定并行度上限。
再把视角切到编码宽度:假定操作码 8 位、寄存器号 5 位(32 个寄存器)、地址 16 位。三地址指令需要 8+15=23 位起步;一地址指令 8+16=24 位;零地址指令 8 位封顶。看着差不多?别忘了立即数与偏移字段:真实指令里还要塞数值常量,堆栈型的短指令在代码总量上反而可能吃亏——因为它需要更多的装载与弹压指令来搬运数据。宽度与条数的乘积才是真账本。这个"总字节量"思维会在 3.1 节定长变长之争里再次登场,届时你会带着本节的推演经验去审两条生产线的优劣。
常见疑问
问:为什么现代虚拟机栈式字节码不直接设计成寄存器式?其实有——Dalvik 就是寄存器式字节码,寄存器窗口在指令里显式编号。安卓早期从栈式 JVM 字节码转投寄存器式 Dalvik,理由正是解释执行时省掉栈顶弹压的开销。这说明栈式与寄存器式的选择不是信仰,而是"解释器解释成本"与"代码体积"的工程权衡:字节码小省传输与存储,寄存器式省解释 dispatch。两种风格在虚拟机层都已经交过手,结论各有适用场景。
问:堆栈机的"验证容易"具体指什么?以 WebAssembly 为例:校验器从函数入口起静态模拟栈形态,每条指令的前后栈深与元素类型都能推演,类型错误与栈失配在加载期就拦截,根本不用运行。这种可验证性是沙箱安全的基石——寄存器式字节码同样能做验证(Dalvik 就有),但栈式的验证规则更简洁。
本节要点回顾
- 零地址、一地址、三地址对应堆栈、累加器、寄存器三种风格,尺子是"操作数要不要写进指令"。
- 堆栈型指令最短但栈顶串行化,适合做虚拟机的传输格式;累加器型编码最省但访存最重;寄存器型指令最长但并行性最好。
- x86 的单操作数乘除与 x87 浮点栈是祖先口音,读汇编时要认得。
- 现实是混血:字节码用堆栈编码、物理芯片用寄存器执行,两种风格构成上下游。
- 效率看访存与并行度,别被"指令条数"误导。