3.1 定长与变长:两条编码生产线
3.1 定长与变长:两条编码生产线
本节摘要:进编码车间的第一道工序是选生产线:所有指令一个尺寸,还是长短随语义伸缩。本节拆解定长与变长两条产线的机械结构、各自在取指与解码端造成的后果,以及两条产线近年的相互渗透。读完你应当能画出 RISC-V 的六种基本格式骨架,并解释 x86 为何以 15 字节为上限。
两种粒度的字节粒
定长产线的规矩是:不管语义轻重,每条指令一律占满固定位数。RISC-V 的 RV32I 与 ARM 的 A64、经典 MIPS 都是一律 32 位。32 位蛋糕怎么切,RISC-V 给出的答案是六种格式的骨架,先用 ASCII 把它们排开(每个字母一位):
R 型(寄存器运算) funct7 rs2 rs1 f3 rd opcode I 型(立即数运算) imm[11:0] rs1 f3 rd opcode S 型(存数) imm[11:5] rs2 rs1 f3 imm[4:0] opcode B 型(条件分支) imm 拆段 rs2 rs1 f3 imm 拆段 opcode U 型(大立即数) imm[31:12] rd opcode J 型(远跳转) imm 拆段 rd opcode
注意它的分蛋糕逻辑:操作码永远在最低 7 位(先看牌子再看货),目标寄存器 rd 永远在同一位置,源寄存器 rs1 紧随其后;立即数宽了就挤掉功能字段,分支与跳转的立即数甚至被拆成几段塞进缝隙。定长产线的一切设计都服务于同一个客户——解码器:字段位置固定,硬件可以并行抽取所有字段,不必等操作码译完才知道去哪取数。
变长产线是另一番气象。x86 指令由若干可选段拼接而成:
[前缀] [操作码] [ModRM] [SIB] [位移 0/1/2/4 字节] [立即数 0-4 字节]
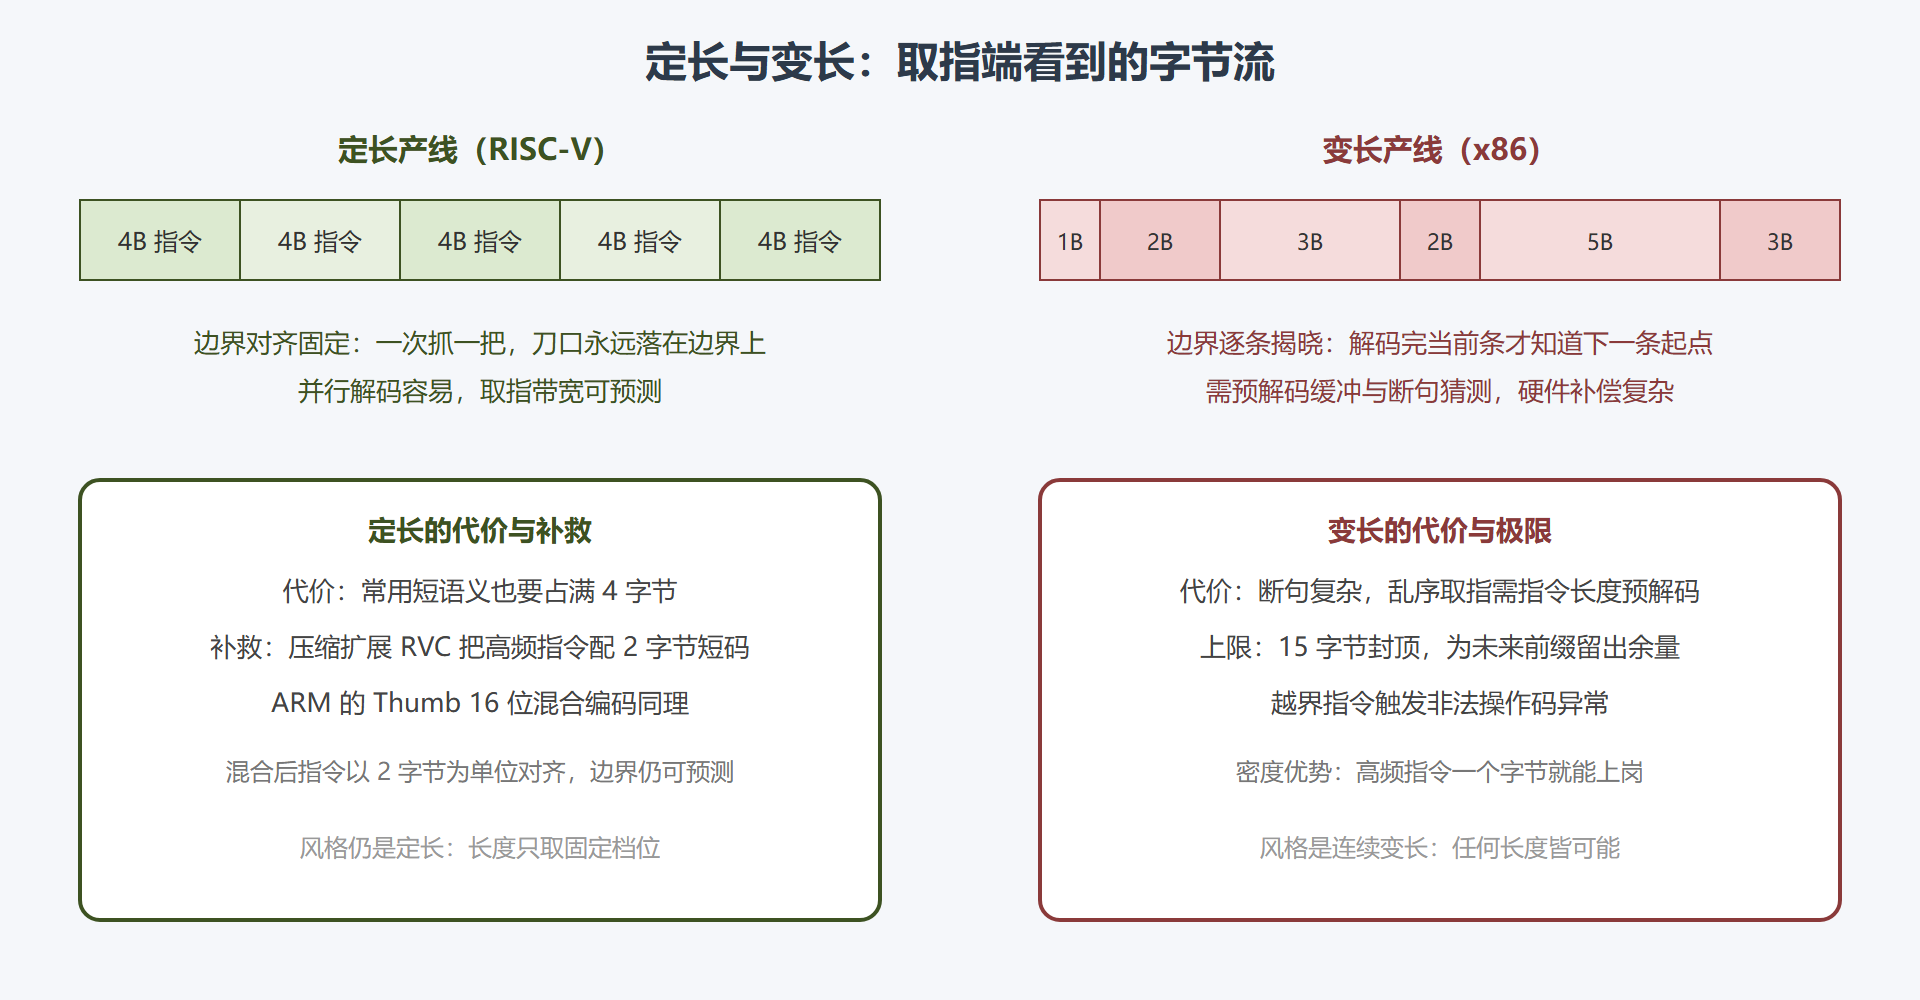
前缀可有可无、可叠多个;操作码 1 到 3 字节;寻址信息按需出现。结果是指令长度从 1 字节到 15 字节自由伸缩:push rax 一个字节(0x50),而带前缀、复杂寻址、四字节立即数的指令能吃满 15 字节。短指令省内存,长指令装语义,密度与表达力兼得——代价由解码器付:它必须逐字节扫描才能确定当前指令的边界,指令的起点还取决于上一条指令的长度。同一段字节从不同偏移开始解读,会解出完全不同的指令——这个特性日后既被反汇编工具的线性扫描算法拿来做文章,也曾被攻击者用于字节层面的歧义把戏。
图 3-1:定长与变长两条生产线的取指对比
产线选择如何回传到软件
两条产线的差异不止在硬件账本上,还会回传到软件的可观察行为。定长架构里,指令地址天然对齐(RISC-V 无压缩扩展时每条指令地址是 4 的倍数),函数入口、跳转目标的低两位恒零;调试器与性能分析工具可以放心做这些假设。变长架构没有这层福利:x86 的跳转可以落在任意字节,这既是灵活(手工优化时省字节),也是陷阱(反汇编器从错误偏移起步会满盘皆错,逆向工程里的"指令重对齐"技巧正是利用这一点)。
代码密度上,变长产线传统占优,但差距比直觉小:RISC-V 加上 C 压缩扩展后,常用代码的平均指令长度接近 3 字节,与 x86 的典型均值不相上下;ARM 的 Thumb-2 混合编码同样把均值压到 2 到 4 字节区间。真正拉不开密度的原因是双方的趋同演化——都在"高频指令给短码"上做足了文章。差异剩下的是硬件端:定长让取指与解码便宜,变长让编码表臃肿(x86 的一字节操作码空间 256 个格子早已用尽,3.2 节细看它怎么腾挪)。
容易踩的坑
第一个坑:把"RISC 定长"理解成"长度永不变化"。RISC-V 与压缩扩展共存后就是 2 字节与 4 字节混合的编码流,只是每种格式内部严格定长、且短编码以 2 字节对齐——边界的可预测性保留了大半,这与 x86 的逐字节伸缩有本质区别。第二个坑:以为 15 字节上限是设计失误。它是当年"给未来留 4 位长度余量"的工程决定,前缀字节早已把这段余量吃干净,EVEX 时代甚至要靠回收保留位续命——上限今天已成为真实的兼容性约束,编译器明知某些编码组合更优也必须绕行。第三个坑:定长产线上手写跳转表时忘记对齐假设被压缩扩展打破——目标地址低一位可能是 1(2 字节对齐),用低两位清零的旧技巧会出错。
格式的骨架:把六张格式表拼成一张地图
六种格式的骨架值得再压缩成一张决策地图,让你看到任何一条 RISC-V 指令就能立刻归位。问自己两个问题:第一,这条指令要不要碰内存?要碰就是访存类,装进 I 型(加载)或 S 型(存储),操作码分别是 0000011 与 0100011;不碰再看第二问,指令操作的对象是谁——两个寄存器运算走 R 型(0110011),寄存器加立即数走 I 型运算变体(0010011),条件判断走 B 型(1100011),大常数装载走 U 型(0110111 装高位,0110011 配合补位),远距离跳转走 J 型(1101111)。两个问题问完,格式确定,字段位置确定——这就是定长产线"查表即装配"的体验。
对照变长产线的同题体验:装配一条 x86 指令要依次决定前缀(要不要 REX 扩展寄存器号、要不要 66 换宽度)、操作码(一条还是两条、要不要 ModRM 里的延伸位)、寻址形态(ModRM 的 mod 档位)、要不要 SIB、位移与立即数的宽度档位——每个决定都可能改变后续字段的解释,而且某些组合非法。3.4 节的实战里你会两条产线各走一遍,届时对"定长的查表感"与"变长的拼装感"会有肌肉记忆。
变长产线还有一个常被忽略的细节值得点破:它的短指令比定长的短编码更短。x86 的一字节指令(如压栈、返回)在 RISC-V 压缩扩展里也要占 2 字节。这不是 x86 多高明,而是它愿意为最常用的少数指令保留整个一字节操作码空间——代价是这张空间早已枯竭,新指令全都住进前缀借来的新区(3.2 节)。两种产线的密度优势各有来源:变长赢在"最短可以多短",定长压缩赢在"平均可以多齐"。
常见疑问
问:压缩扩展加入后,定长架构的取指优势还剩多少?剩大头。RVC 指令流以 2 字节对齐为单位排布,取指窗口扫一遍,每条指令的边界由低两位模式即可判明,不需要解开操作码语义;x86 则要读完前缀与操作码才知道长度。用一句话总结:定长压缩是"两种长度、一眼可辨",变长是"任意长度、逐条揭晓"。
问:为什么 x86 不干脆引入定长模式?试过。当年 Intel 内部与学界都提过定长化的过渡方案,问题在于任何"新模式"都要与既有四十年编码共存,双模式并存的翻译成本最终落回解码器,收益抵不过代价。x86 的选择是把变长问题外包给微操作缓存与不断加宽的前端——这就是生态约束下的局部最优解。
本节要点回顾
- 定长产线字段位置固定,解码可全并行;六种 RISC-V 格式的切分逻辑是"操作码垫底、寄存器号靠前、立即数见缝插针"。
- 变长产线前缀、操作码、ModRM、SIB、位移、立即数按需拼接,1 到 15 字节伸缩,断句成本由解码器承担。
- 两条产线在互相渗透:RVC 与 Thumb 给定长补密度,x86 的规整化微操作给变长减负。
- 产线差异回传软件:对齐假设、跳转落点、反汇编起点,都是可观察的后果。
- 15 字节上限是历史余量耗尽后的硬约束,不是随手定的数字。