4.1 整数、浮点与向量:数据的包装规格
4.1 整数、浮点与向量:数据的包装规格
本节摘要:指令加工数据前,数据先得有标准包装。本节讲三种包装:整数的补码与字节序、浮点的分段科学计数法、向量的成箱规则,并解释对齐为何被做成架构约定。读完你应当能读懂内存转储,手工判断一段十六进制字节对应的数值与类型。
数据进车间前先包装
寄存器与内存只认位串,"这个位串是整数还是地址还是浮点"全靠包装规则约定。包装规则是硬合同:编译器按它装货,硬件按它卸货,谁也别想即兴发挥。本节按从简单到复杂的顺序过三种包装。
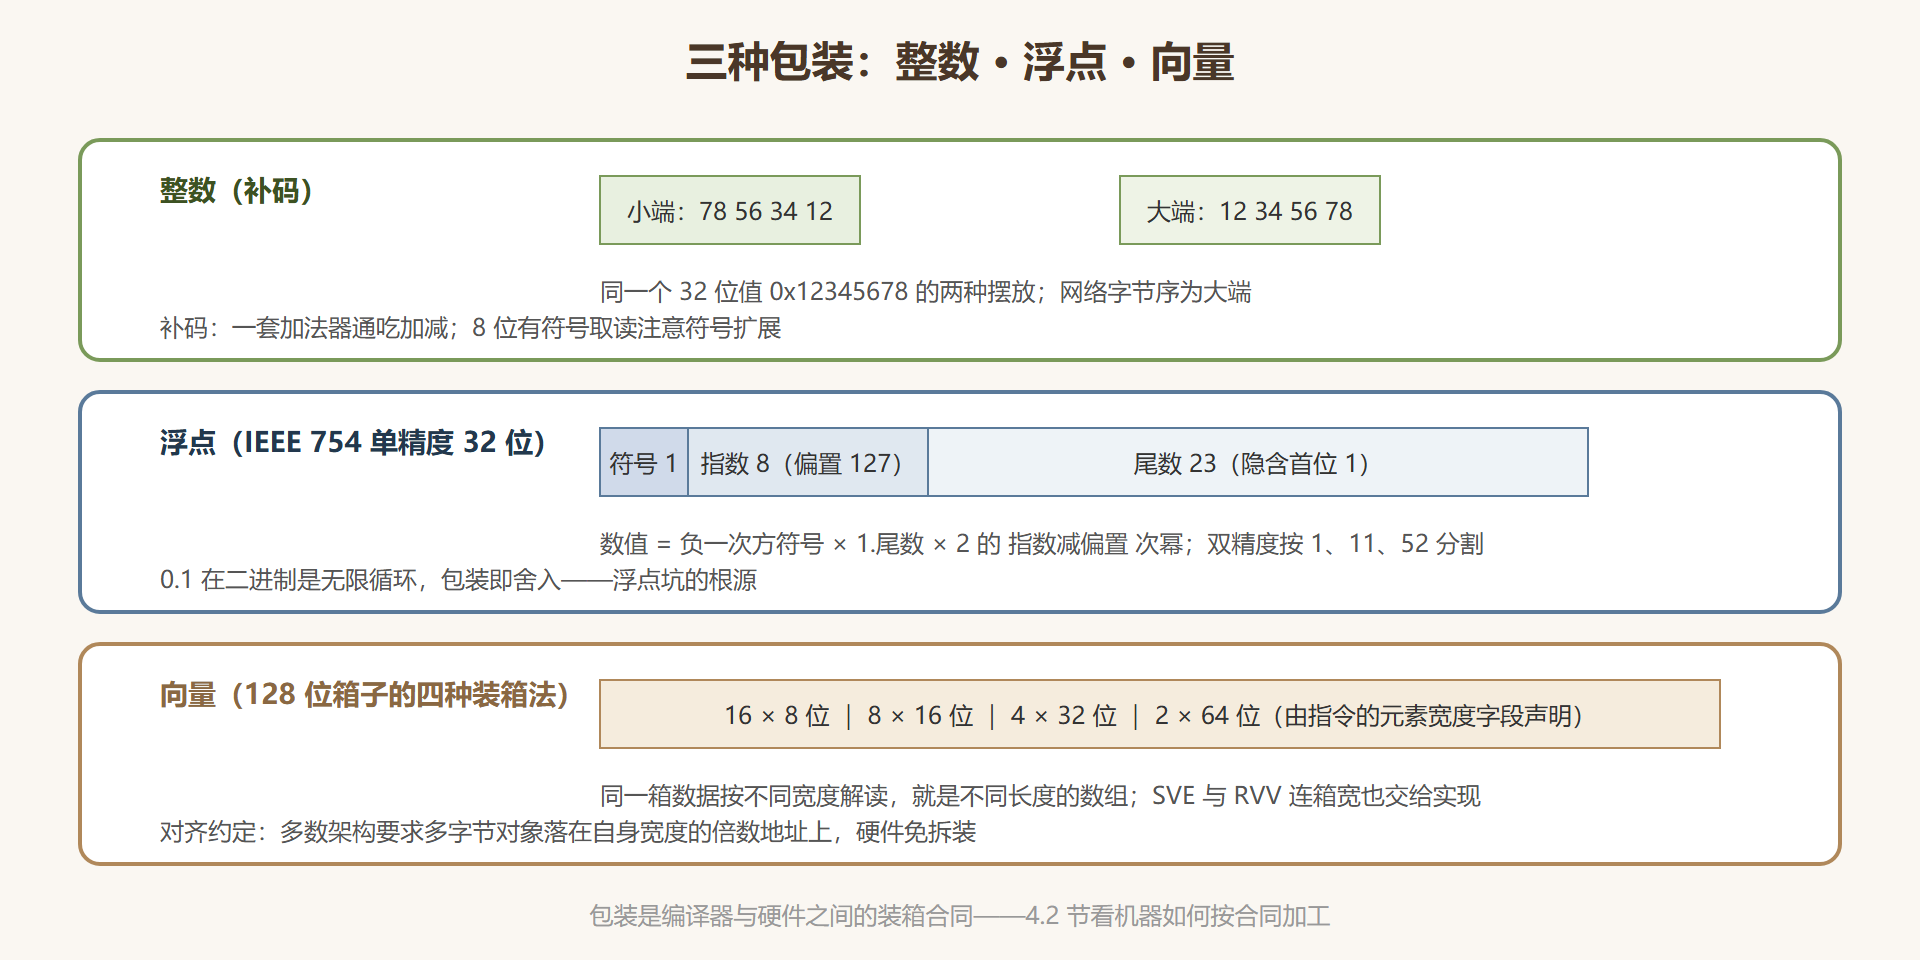
**整数:补码一统江湖。**无符号整数的包装平凡——直接二进制。有符号数曾有原码、反码、补码多种流派,如今补码完胜,原因值得记住:补码让加法器不用区分符号位,减法就是加负数的补码,一套电路通吃加减;而且 -1 全一、0 唯一表示、负数比正数多一个(32 位下范围是 -2147483648 到 2147483647)。溢出行为也定义得干脆:截断到固定位宽,高位丢失。看包装的实操:
内存转储(地址从左到右递增):78 56 34 12 小端机器读法:低字节在低地址 → 0x12345678 大端机器读法:高字节在低地址 → 0x78563412
同一份转储,字节序不同,数值南辕北辙。字节序影响的是多字节对象在内存里的摆放顺序,网络协议(网络字节序为大端)与文件格式因此必须显式声明——读网络包、解析文件头时,先问字节序,再谈数值。取部分宽度还有符号扩展的问题:从 32 位取 8 位,无符号读(零扩展)与有符号读(符号位填充高位)是两条不同指令(RISC-V 的 lbu 与 lb),选错会把 0xFF 读成 255 或 -1 两个答案。
**浮点:二进制的科学计数法。**浮点包装像科学计数法的二进制版:数值 = 符号 × 尾数 × 2 的指数次幂。单精度 32 位切成三段:符号 1 位、指数 8 位、尾数 23 位;双精度 64 位按 1、11、52 分割。指数带偏置(单精度偏置 127)以省去符号位;尾数隐含首位 1(规格化数)再多赚一位精度。分段细节与舍入规则留到 4.3 节专门解剖,这里只立规矩:浮点的包装决定了它天生只能表示"近似的实数",两个看似简单的十进制小数(0.1)在二进制里是无限循环,包装时就被舍入了——一切浮点比较的坑都源于此。
**向量:同规格物料成箱。**向量寄存器把 N 个同宽度数据打包搬运:128 位箱子可装 16 字节、8 个 16 位半字、4 个 32 位字或 2 个 64 位双字,装箱方式由指令的元素宽度字段声明。同一箱数据,按不同宽度解读就是完全不同的数组——4.1 的包装规则在向量维度上再乘一层。SVE 与 RVV 的"长度不可知"包装(2.4 节)更进一步:程序只声明"每元素多宽、处理多少个",箱子多大由硬件现场回答。
图 4-1:数据的包装规格总览
对齐:包装的位置规矩
包装还有一条位置规矩:多字节对象的地址最好落在自身宽度的整数倍上——32 位整数放 4 的倍数地址,64 位指针放 8 的倍数地址。这叫自然对齐。对齐的动机是搬运效率:内存与缓存按整块交换数据,对齐对象一次搬运到家;不对齐则可能横跨两块,硬件要么拆两次搬、要么直接拒绝。三种态度在现实中共存:x86 历来容忍不对齐访问(代价是变慢,跨缓存行时更明显);早期 ARM 与部分 RISC-V 实现直接抛异常;RVV 等新规范则把"是否允许"交给实现声明。原子指令还额外要求严格自然对齐——不对齐的原子操作在很多架构上直接失败,这是 4.4 节的伏笔。
写代码时对齐大半由编译器操心,三种场合例外:解析二进制格式(文件里的字段可能不对齐,须逐字节拷出再解读)、手工数据布局(为缓存友好故意重排结构体字段)、以及移植老代码(旧平台允许的紧缩结构在新平台触发异常)。看懂崩溃报告里的"非对齐访问异常",回到本节找答案即可。
一次完整的包装考古:从内存转储到语义
包装规则的综合演练放在这里。给你一段内存转储(小端机器):
地址: 0x1000: 78 56 34 12 0x1004: 00 00 80 3F
第一问:0x1000 处的 32 位整数是多少?小端读法低字节在前,逻辑值 0x12345678,十进制 305419896;若按有符号读,最高位为 0,仍为正数,答案不变。第二问:0x1004 处的 32 位值若是浮点呢?逻辑值 0x3F800000,切三段:符号 0、指数 01111111(127)、尾数全零——按 4.3 节的公式,指数减偏置为零、隐含首位一、尾数零,正好是 1.0。同一段字节,整数解读与浮点解读南辕北辙——包装规则就是"读法合同",读法错了数值全错。这道题的变式(把 0x12345678 当 16 位对读取、当大端解读)建议在纸上自行推演,全部答案都能用本节规则校验。
把视角再抬一层:转储考古是逆向分析、协议解析、故障取证三项工作的日常。它们共同的纪律是——先定字节序与类型边界,再读数值,最后才允许赋予语义。跳过前两步直接"猜语义",是新手在解析二进制格式时翻车的头号原因。
容易踩的坑
第一个坑:把字节序当成"老古董知识"。现代主流桌面 CPU 都是小端,但网络协议是大端、大量文件格式声明了字节序、还存在着仍用大端的嵌入式平台——跨机器的数据交换永远要过字节序这道闸。第二个坑:有符号与无符号的隐式转换。C 语言里无符号与有符号比较时,有符号一方被悄悄转成无符号,-1 < 1u 会得出假——包装规则层面的细节直接变成逻辑缺陷。第三个坑:以为对齐只是性能问题。对大多数指令确实是,但原子指令与向量加载在部分架构上把对齐当正确性要求,不对齐直接异常或结果未定义——性能问题可以忍,正确性问题不能忍。
本节要点回顾
- 补码让一套加法电路通吃加减,32 位有符号范围到负 21 亿多为止;部分宽度读取要分清零扩展与符号扩展。
- 字节序只影响多字节对象的摆放,网络与文件格式必须显式过闸;小端是桌面主流,大端活在协议里。
- 浮点包装是二进制科学计数法:符号、指数(带偏置)、尾数(隐含首位一)三段;近似性是包装自带的。
- 向量包装成箱,元素宽度由指令声明;SVE 与 RVV 连箱宽也交给实现。
- 对齐多数时候是性能问题,在原子与向量指令上会升级为正确性问题。