4.3 IEEE 754 浮点在指令中的落地
4.3 IEEE 754 浮点在指令中的落地
本节摘要:4.1 节给了浮点的包装图纸,本节看它如何落进真实指令集:专用浮点寄存器、可切换的舍入模式、NaN 的传染规则、融合乘加的精度红利,以及 x87 与 SSE 混用引发的真实精度事故。读完你应当能手工完成一次十进制到浮点编码的转换,并解释为什么同一段浮点代码在不同编译选项下结果不同。
浮点指令的真实处境
浮点运算指令与整数指令的待遇差别很大:独立的寄存器堆、独立的执行单元、多出来的控制位。x86 的浮点经历了两代王朝:x87 时代(8 个栈式寄存器,80 位扩展精度)与 SSE 时代(16 个平铺的 xmm 寄存器,32/64 位定宽);RISC-V 则用独立的 f0 到 f31 浮点寄存器,宽度随扩展(F 单精度、D 双精度)而定。指令形态也自成一套:addss(标量单精度加)、mulsd(标量双精度乘)、fmadd(融合乘加),后缀字母在帮你标记数据宽度与舍入行为。
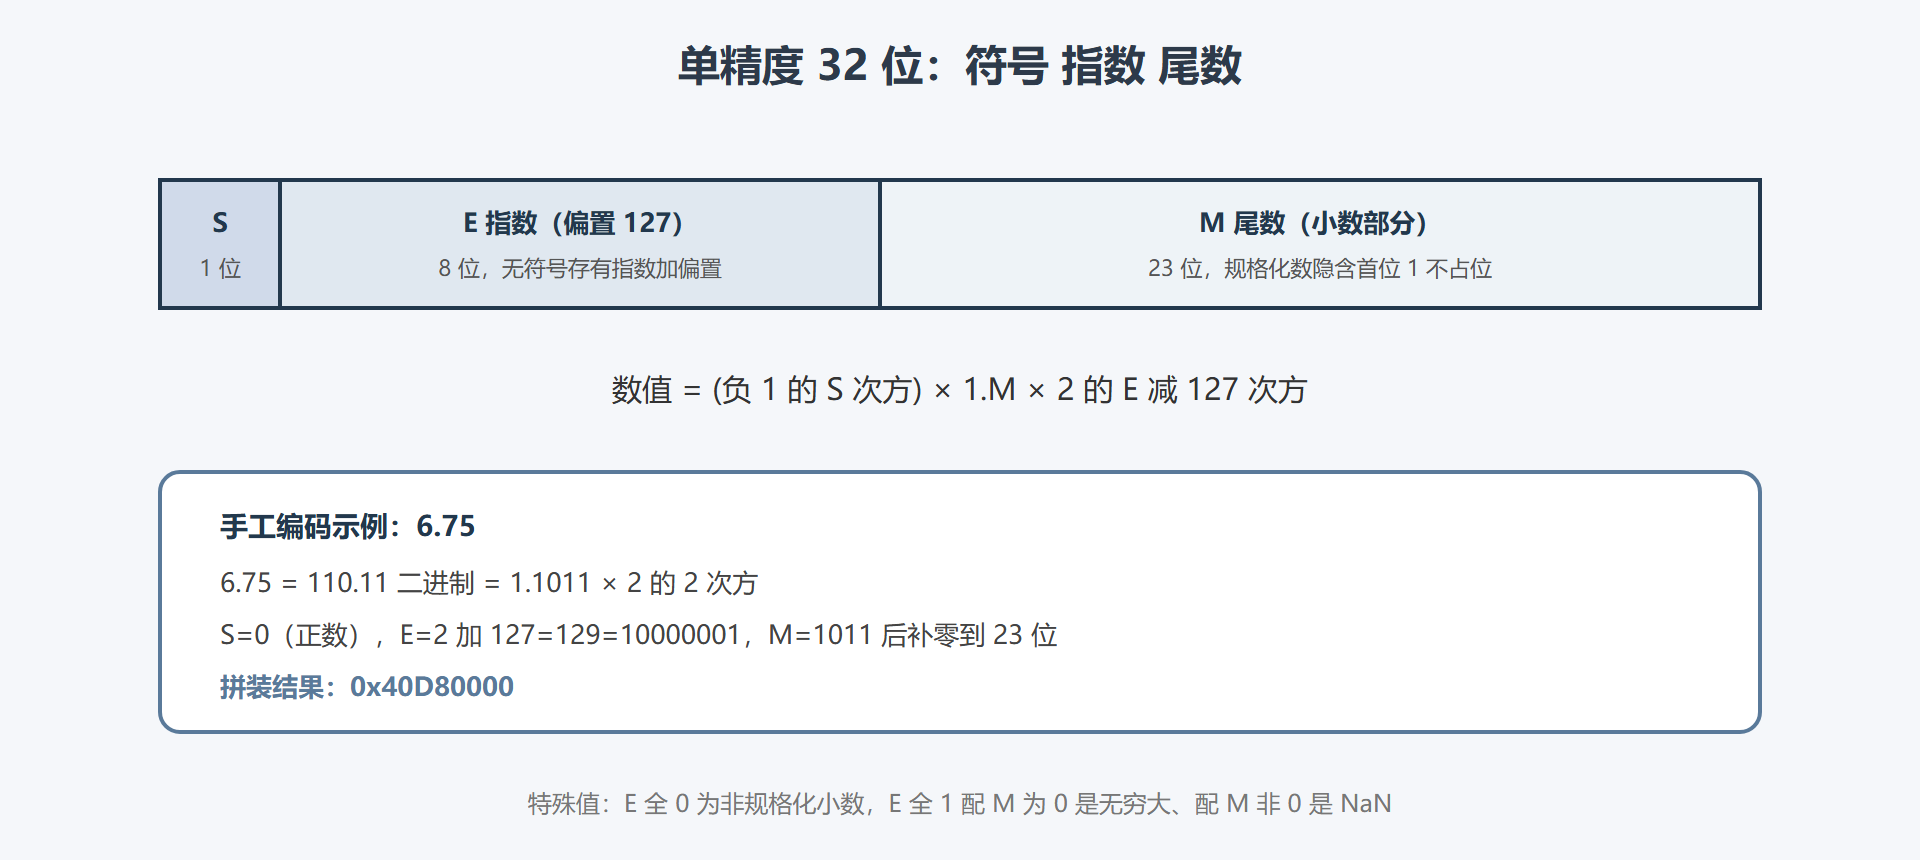
先手工完成一次编码转换,建立手感。把 6.75 装进单精度:整数部分 6 = 110₂,小数部分 0.75 = 0.11₂,合起来 110.11₂;规格化成 1.1011 × 2²;于是符号位 0(正数),指数段 = 2 + 127 = 129 = 10000001₂,尾数段 = 1011 后补零到 23 位。三段拼接:
0 | 10000001 | 10110000000000000000000 → 0100 0000 1101 1000 ... → 0x40D80000
反着来一遍就是解码:拿到 0x40D80000,切三段、减偏置、补隐含首位,还原出 6.75。这道手工题建议亲手做一遍——4.3 的全部复杂规则,都长在这套三段包装上。
图 4-2:单精度浮点的三段包装
舍入模式与 NaN 的规矩
包装只能表示有限精度,多出的精度要按舍入模式处理。IEEE 754 规定了四种:就近舍入(默认,平局时向偶数靠)、向零舍入、向正无穷、向负无穷。舍入模式存放在浮点控制寄存器里,指令执行时现场读取——这意味着同一份二进制代码在不同舍入模式下结果不同,而模式是全局状态,改一次影响全部运算。工程纪律:非要用非默认舍入,收窄到最小代码区间、用完立即恢复。
NaN(非数)的规矩更常被低估。任何涉及 NaN 的运算结果都是 NaN——它像病毒一样沿数据流传染,这本身是好事:计算链末端的 NaN 意味着上游某处出了问题(零除零、无穷减无穷、对负数开方)。但比较指令对 NaN 的行为反直觉:所有带序比较(小于、大于)遇到 NaN 都返回"假",包括 x <= x 这种恒真式——NaN 连自己都不大于自己。判断浮点是否 NaN 不能用等号,必须用专门的"无序比较"或 isnan 类内建。另一个经典陷阱是 -0.0:负零与正零数值相等(比较返回真),位模式却不同,作为除数或映射键时会分道扬镳。
FMA:融合乘加的精度红利
融合乘加(FMA)是一条值得单独认识的指令:fmadd 把 a×b+c 压成一条指令,中间积不做舍入、直接以全精度参与加法,只在最后舍入一次。两重好处:省一条指令、少一次舍入,数值上更精确。RISC-V 的 D 扩展与 x86 的 FMA3 都把它列为标准件。但它也带来工程上的经典纠纷——编译器把两次独立舍入的 a*b + c 优化成一次舍入的 FMA 后,浮点结果与旧版本在末位上不同,"编译器升级导致数值结果变化"的工单多半源于此。涉及严格数值复现的领域(金融清算、仿真回放)会在编译选项里禁用这类融合;追求性能的领域则敞开欢迎。4.2 节末尾的 FMA 归因问题,答案的另一半在这里:融合改变的不是语义正确性,而是舍入次数。
一次舍入的全程追踪
把舍入规则落到一条具体运算上。计算 0.1 + 0.2(单精度):0.1 的二进制是无限循环小数,装入即舍入为约 0.100000001490116;0.2 同样被舍入;两者相加的和再次舍入——三层舍入叠加后,结果约为 0.300000011920929,而直接把 0.3 装入单精度得到的是约 0.300000011920929 的另一个位模式——两个"看起来相等"的数在位层面并不相等,等号比较就此翻车。这就是那个著名的"0.1 加 0.2 不等于 0.3"案例的指令层解释:不是加法错了,是三次包装三次舍入各留了痕。
工程对策按场景分三档。日常业务计算:彻底绕开浮点,金额用整数最小单位(分)、数量用定点数——包装问题从源头消失。科学计算:接受近似性,用误差分析而非等号(容差比较),关键路径上控制舍入次数(这正是 4.3 节 FMA 的价值)。数值敏感的复现场景(回放、对账):锁定编译选项与舍入模式,把"结果的位模式"当合同条款管起来。三档的公共原则是:先想清楚你的场景容得下几次舍入,再让浮点进场。
容易踩的坑:x87 与 SSE 的双王朝冲突
x86 的浮点双王朝留下了一个延续至今的陷阱。x87 的栈式寄存器内部是 80 位扩展精度,运算中途精度高于 64 位;SSE 的 xmm 寄存器则是干净的 64 位。同一段代码,32 位编译(默认走 x87)与 64 位编译(走 SSE)可能给出末位不同的结果——中间多出的精度改变了舍入时机。更隐蔽的故障在混用上:x87 栈与 xmm 各管各的,编译器在函数间搬运浮点参数时会做精度转换,若内联汇编一边用 x87 一边用 SSE,精度损失会在你不设防的位置发生。诊断思路记住一条:浮点结果"差一点点"且与编译位数或选项相关,先查浮点单元是哪一代王朝在执政。现代代码的正确姿势是全面走 SSE/AVX 一系、把 x87 留给上古遗产,并按 4.1 节的精神把"0.1 不可精确表示"这类根源问题挡在需求评审阶段——该用整数的最小单位(分、毫秒)就别用浮点。
本节要点回顾
- 浮点指令自成王朝:独立寄存器堆、独立执行单元;x86 经历 x87 栈式与 SSE 平铺两代,RISC-V 用独立的 f 寄存器系。
- 三段包装可手工拆装:6.75 = 0x40D80000 的编码全程值得亲手演一遍。
- 四种舍入模式是全局状态,改模式要收窄区间用完即还;NaN 全比较为假且会传染,判 NaN 必须用专门手段。
- FMA 少舍一次:更精确也更"善变",数值复现需求与性能需求的经典冲突点。
- 双王朝精度错位:浮点末位差异与编译位数相关时,先查 x87 与 SSE 谁在执政。