6.2 Load/Store 架构:访存指令设计
6.2 Load/Store 架构:访存指令设计
本节摘要:访存指令是仓储车间的搬运单据。本节解释 Load/Store 架构为什么把全部访存收敛成加载与存储两型——算术指令只在寄存器间干活——以及缓存层级如何决定一条加载的真实延迟。读完你应当能从数据布局推断缓存行为,并说出"缓存友好代码"的具体标准。
搬运工的规矩
CISC 的老设计允许算术指令直接吃内存操作数:add eax, [ebx] 一条指令同时取数与运算。Load/Store 架构把这条路封死:只有加载(load)与存储(store)两类指令能碰内存,其余指令的操作数必须已在寄存器里。这不是审美洁癖,收益实打实:算术指令的格式里不再需要寻址信息,解码端更规整(3.1 节的定长产线因此更纯粹);执行端的运算单元不再等待地址翻译,前递网络只需盯寄存器流;调度器看到的依赖更清晰——访存的归访存、运算的归运算,5.4 节的乱序机构得以按两种节奏分头安排。
两型单据的完整形态以 RISC-V 为例:加载按宽度与符号处理分家(lb/lbu/lh/lhu/lw/lwu/ld,无符号加载零扩展、有符号加载符号扩展,4.1 节的包装规则在此接线),存储只有宽度之分(sb/sh/sw/sd——存数不需要符号概念)。寻址统一为基址加 12 位偏移(3.3 节)。x86 虽是 CISC,现代编译器产出的代码同样呈现 Load/Store 风格——先 load 到寄存器、纯寄存器运算、再 store 回去,指令集的表面差异被编译器的共同习惯抹平。
两型单据的味道,拿同一段循环在两家的汇编里对照最直观。语义:把数组 b 的每个元素加一后存进数组 a——
# RISC-V(RV64):Load/Store 纯血 loop: ld t0, 0(s2) # 取 b[i] 进寄存器 addi t0, t0, 1 # 寄存器之间运算 sd t0, 0(s1) # 存回 a[i] addi s2, s2, 8 # 指针推进 8 字节 bne s2, s3, loop # 未到末尾则继续 # x86-64:CISC 允许运算指令直接吃内存操作数 loop: add qword ptr [rsi], 1 # 一条指令完成取数、加、存回 add rsi, 8 cmp rsi, rdx jne loop
x86 的循环体更短,但那条"直接吃内存"的 add 在硬件内部仍被拆成加载、加法、存储三个微操作(5.1 节)——表层的风格差异到了执行端殊途同归;而 RISC-V 的显式加载与存储让编译器在排程时就看得清每一步依赖。两种写法的缓存行为完全一致:决定性能的是指针递增带来的顺序访问模式,不是指令风格——这正是本节标题要立的观点。
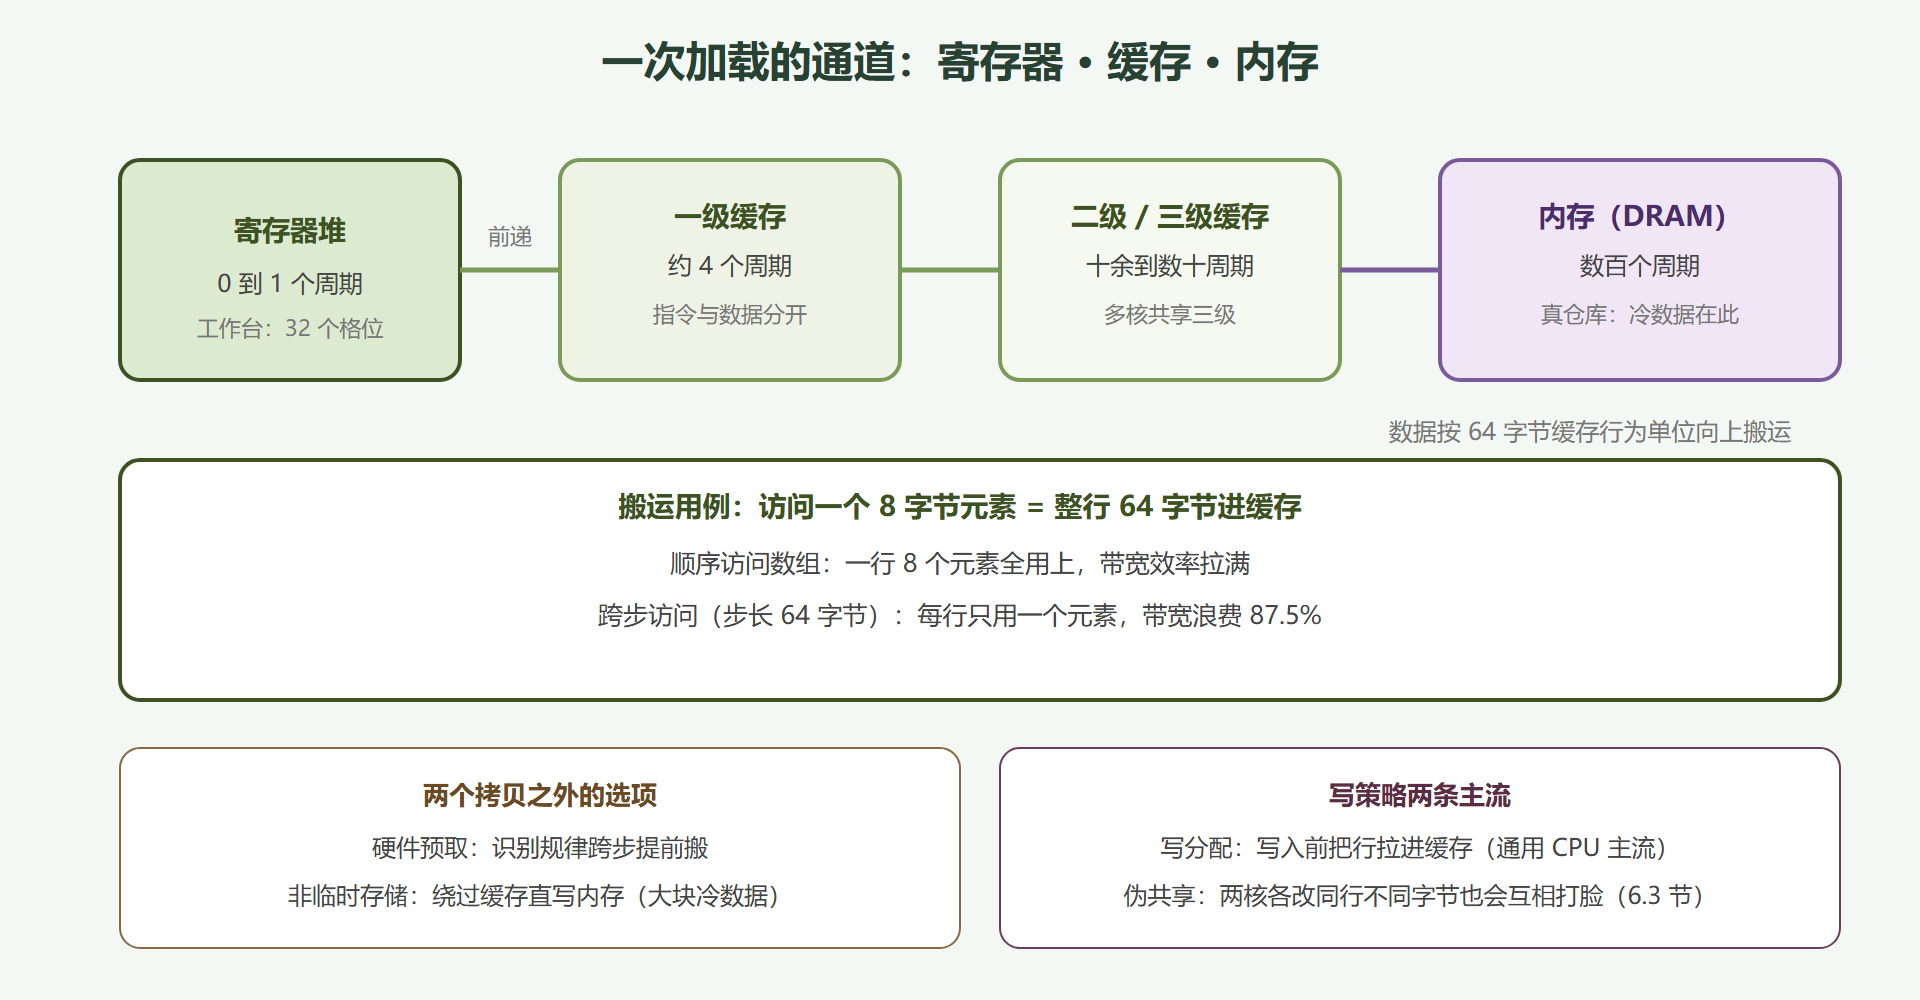
图 6-1:一次加载的搬运通道与延迟阶梯
缓存行:搬运的最小单位
加载的延迟阶梯由缓存层级决定,但比延迟更值得记住的是搬运颗粒:缓存行(典型 64 字节)。哪怕你只读一字节,缓存也把整行搬上来——这个事实直接给出缓存友好代码的标准:
顺序访问:数组连续遍历,每行 8 个 8 字节元素全数利用 —— 最优 跨步访问:每 64 字节只用其中 8 字节 —— 带宽浪费八成以上 指针追逐:链表节点散落各页,一行往往只用一个节点 —— 延迟无处可藏
硬件预取器能识别规律跨步并提前搬运,对顺序访问是锦上添花,对指针追逐束手无策。这解释了为什么"数组永远优于链表"在当代硬件上比教科书时代更接近真理——不是算法复杂度的差别,是搬运颗粒利用率的差别。结构体布局同理:把热点字段聚在一起(同行的邻近字节一起受益)、把冷字段拆出去,一行缓存扛更多有效数据;"结构体数组"与"数组结构体"的选型,本质就是"每个搬运单位里有效数据占比"的选型。
存储侧多一条策略分岔:写入时先把行拉进缓存再改(写分配),还是直接改并标记回写。通用 CPU 主流是写分配加写回——后续对该行的修改都落在缓存里,退役时才回内存。这带来两个工程后果:其一,写一小段也会拉整行进来,随机小写是带宽噩梦;其二,写留在缓存里的时间窗口正是 6.3 节一致性问题上演的舞台。大块冷数据的写入可以走"非临时存储"直通内存,绕开缓存污染——视频编码、大批量拷贝库里常见这手。
容易踩的坑
第一个坑:拿"内存带宽"当"有效带宽"。跨步与指针追逐让理论带宽大半作废,性能模型要按"每行有效字节"折算——剖析工具里的缓存未命中计数比带宽数字诚实得多。第二个坑:忽视非对齐与原子访问的耦合。Load/Store 架构大多容忍非对齐普通访问(代价是可能跨行、跨页,延迟翻倍),但 4.4 节的原子指令要求自然对齐——把 8 字节原子变量放在 7 字节偏移上,轻则性能断崖,重则异常。第三个坑:把预取当成白来的午餐。预取器按历史规律搬行,程序模式突变时它会搬错——错误预取不但浪费带宽,还可能把有用行挤出缓存(替换污染);调优时关掉预取做对照实验,是定位"带宽瓶颈还是容量瓶颈"的常用手段。
两个布局对照实验
6.2 节的布局知识值得配一个可复算的对照。场景一:遍历一个 1024 行、每行 8 个 32 位整数的二维数组。按行遍历(外层行、内层列),访问顺序与内存布局一致,每行缓存行整行利用,未命中次数约为数组总字节数除以行大小;按列遍历(外层列、内层行),每次访问跳 32 字节,每个缓存行被访问一次就遗弃,未命中次数直接翻 8 倍。同一段算法、同样的指令条数,性能差数倍——差的全是搬运颗粒利用率。
场景二:结构体数组与数组结构体的选型。假设每条记录 64 字节,其中只有 8 字节的 status 字段是热点。结构体数组布局下,每个 status 都拖着 56 字节冷数据进缓存,每行只服务一条记录;数组结构体布局把 1024 个 status 密排在 8 行缓存里,热数据密度提升 8 倍。两个实验的算式都不复杂,但亲手算完的体感与看结论完全不同——建议把两道题的未命中数都在纸上算出来,然后到剖析工具里实测对照。
常见疑问
问:编译器不能自动做这些布局优化吗?结构体字段重排(按对齐与大小排序)编译器在做,但"结构体数组换数组结构体"属于数据结构重构,涉及接口语义变化,编译器无权替你决定。语言层面的所有权与别名信息不足以支撑自动改写——这是人机分工的固定边界:机器优化指令调度,人负责数据形状。
问:缓存行一定是 64 字节吗?主流 x86 与 ARM 服务器核心是 64 字节,个别平台用过 128 字节(部分 Apple 芯片)。写跨平台的高性能代码时,把缓存行大小做成可配置常量而不是写死的假设,是成本极低的保险。
本节要点回顾
- 访存收敛成加载与存储两型:解码规整、前递清爽、调度清晰,是 RISC 立场在仓储侧的兑现。
- 缓存行 64 字节是搬运颗粒:顺序访问全行利用,跨步访问浪费带宽,指针追逐无处可藏。
- 布局即性能:热点字段聚合、结构体数组对数组结构体的选型,都是在优化"每行有效占比"。
- 写分配加写回是主流策略:小随机写很贵、非临时存储给大块冷数据留了后门。
- 对齐对普通访问是性能、对原子指令是正确性——两层要求别混。