4.1 计算机体系结构与微处理器
4.1 计算机体系结构与微处理器
本节摘要:第三章的算法需要机器来跑。本节拆开处理器这只"黑盒":指令集是软件与硬件的合同,流水线是吞吐量的发动机,存储层次是性能的隐形裁判,DSP 则是给信号处理特化的变体。读完本节,你能回答工程选型的常见考题:同样的滤波算法,为什么在 CPU、DSP、FPGA 上的表现差出百倍。
一个选择困境开场
团队要为一款实时音频产品选主控:跑通用操作系统的高主频 CPU 每秒能执行数亿条指令,看似绰绰有余;可实测在满负荷下偶发处理超时。问题不在指令速度,而在两件事:通用 CPU 的中断响应路径太长(要保存的现场太多),以及 cache 未命中时的访存延迟不可预测。这个真实困境说明:评价处理器的第一指标不是每秒指令数,而是"最坏情况多久响应"。嵌入式与实时系统的一切体系结构知识,都围绕这个视角展开。
指令集:软件与硬件的合同
指令集架构(ISA)规定处理器能听懂哪些话:有哪些寄存器、支持哪些运算、怎样访存。两大风格:CISC(指令多而全,硬件译码复杂,x86 是代表)与 RISC(指令少而规整,单周期执行为主,ARM 与 RISC-V 是代表)。嵌入式世界 RISC 获胜的理由很实际:规整指令让流水线设计简单、功耗低、芯片面积小——这三样恰好是电池供电产品的命根。
存储组织上,哈佛结构(指令与数据分总线,取指与取数并行)与冯诺依曼结构(共用一条总线)是一对经典取舍:数字信号处理器普遍用哈佛结构,因为信号处理的循环里"取指令、取数据、写结果"三件事同时发生,分总线让它们不打架。
流水线:吞吐量的发动机
把一条指令的执行切成取指、译码、取数、执行、写回五级,让五条指令像车间流水线一样错峰重叠,吞吐量可提升近五倍——单条指令的延迟没变,但"产出频率"翻了。代价是两类"卡壳":
- 数据冒险:后一条指令要用前一条还没写回的结果。对策是前递通路(结果直接转发)或插入停顿;
- 控制冒险:跳转指令让预取的指令作废。对策是分支预测(猜错了再冲刷)。
现代 CPU 的分支预测器准确率超过 95%,猜错的代价反而成了性能分析里最隐蔽的坑。2.3 节的建立保持时间是流水线每级的"物理法律",静态时序分析按级执法——两节在此接榫。
图 4.1-1 存储层次:越快越贵越少的金字塔
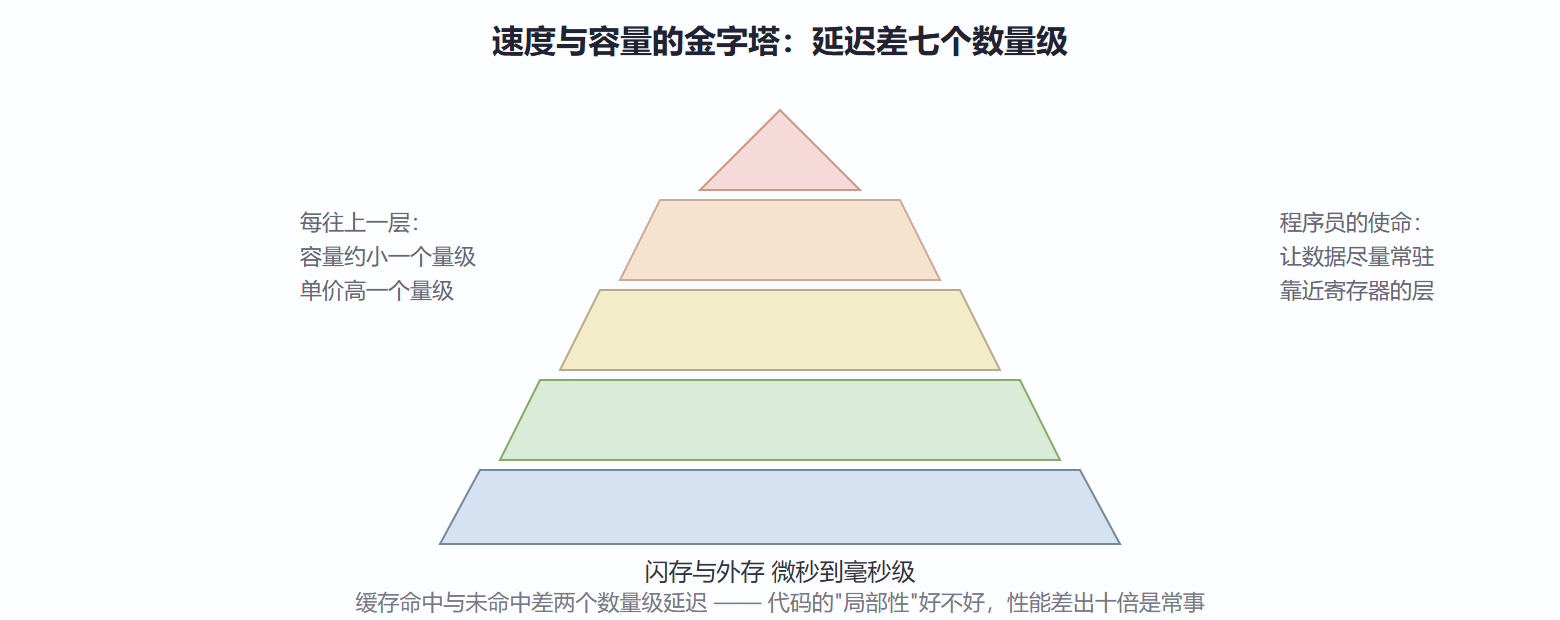
金字塔的解释力很强:为什么数组按行遍历比按列快(连续地址命中同一缓存行)、为什么 DMA 搬运要凑整块、为什么实时系统忌讳动态内存(分配延迟不可预测)。程序优化的一半功夫,是在给这座金字塔"喂"出好的访问模式。
DSP:给信号处理特化的变体
通用 CPU 跑 FIR 滤波要一个循环做"乘、加、移位、跳转"四件事;DSP 处理器把这些焊成硬件惯例:乘加指令单周期完成、循环缓冲自动回绕(省去边界判断)、哈佛总线并行取指取数、零开销循环(硬件计数器替代软件跳转)。同一个 128 抽头滤波器,DSP 每样点 128 周期上下,通用 CPU 可能要四五百周期。选型时看"每秒乘加运算次数"而不是主频,就是给这类特化定价。定点与浮点的选择同样现实:定点 DSP 便宜省电但要精心定标防溢出,浮点贵但开发快——消费类产品多数选前者并把定标功夫花在算法团队身上。
动手对照:同一件事的两种写法
把 2.2 节音频通路的增益搬进数字域,对比通用写法与 DSP 风格的差异:
// 通用写法:循环边界判断 + 乘加分立,每样点约 4 到 5 个周期 for (i = 0; i < N; i++) { acc = 0; for (k = 0; k < L; k++) acc += coef[k] * buf[(i - k + N) % N]; // 取模回绕,代价高 out[i] = acc >> 15; // 定点定标 } // DSP 风格:环形缓冲 + 乘加一体 + 零开销循环(示意,含内在函数) for (i = 0; i < N; i++) { circ_buf[idx] = x[i]; // 硬件循环寻址自动回绕 acc = 0; for (k = 0; k < L; k++) acc = __mac(acc, coef[k], circ_buf[(idx - k) & (L-1)]); // 单周期乘加 out[i] = __saturate(acc >> 15); // 饱和指令防回卷 idx = (idx + 1) & (L - 1); }
两段代码语义相同,后者在真实 DSP 上快三到五倍。差异全部来自体系结构的"特化菜单":循环寻址、乘加指令、饱和运算。写嵌入式代码时翻指令手册找这些"特价菜",是性能提升最便宜的一档。
⚠️ 常见坑:用桌面思维评价嵌入式性能——只看平均吞吐不看最坏响应。实时系统的正确指标是最坏情况响应时间与抖动,cache 与中断优先级的设计都要为最坏情况让路。
常见疑问两则
问:主频相近的两款芯片,实际性能可能差多少?答:差两三倍很常见。决定因素包括每指令周期数(流水线与指令集效率)、存储层次设计、以及有没有乘加与饱和这类特化指令。比较嵌入式芯片请直接测目标算法的每秒处理帧数,主频只能用来比较同架构同代的芯片。
问:为什么不用最高主频换取裕量?答:动态功耗与频率成正比、与电压平方成正比,而电压又须随频率上调,实际功耗随主频近三次方增长。降频百分之二十常换来功耗近乎减半——电池产品宁可牺牲两成峰值性能换回一半续航,这就是移动芯片调度器存在的理由。
问:缓存对实时系统是敌是友?答:是把双刃剑。缓存提升平均性能,但未命中的延迟尖刺让最坏响应时间恶化且难以预测;硬实时系统要么禁用缓存、要么按关键任务锁定缓存行(锁定后永远命中)。这再次印证本节主旨:实时设计管理的是最坏情况,而缓存天生是个"平均主义者"。
本节要点回顾
- 实时性看最坏情况,响应延迟与抖动比峰值性能更致命;
- RISC 胜在规整省电,哈佛结构让信号处理的三件事并行;
- 流水线靠前递与分支预测续命,2.3 节的时序红线逐级执法;
- 存储金字塔差七个数量级,代码局部性直接兑换性能;
- DSP 的特化菜单(乘加、循环寻址、饱和)是同一算法快数倍的全部秘密。
处理器已就位,下一节讲怎样让它在一个真实产品里活着:外设驱动、实时系统、功耗管理与调试。