4.3 可编程逻辑与集成电路设计
4.3 可编程逻辑与集成电路设计
本节摘要:当软件追不上信号的速度,就把算法直接铸成电路。本节讲两条路:FPGA——用可重构的逻辑单元阵列现场"拼"出硬件;ASIC——把电路固化进硅片换极致效率。内容包括硬件描述语言的思维转变、状态机与流水线两大设计范式、综合布局布线的全流程、以及芯片设计里"面积性能功耗"的铁三角。配一个 FIFO 控制器的完整设计。
思维开场:从"顺序执行"到"空间存在"
写 C 代码时你在安排时间:先做这个后做那个。写 Verilog 时你在安排空间:这块电路与那块电路同时存在、同时工作。初学者最常见的翻车是写了三行赋值就以为它们"依次执行"——实际上这三行综合成三块并行电路,同一时刻各自生效。这个思维转变是从软件工程师到芯片设计师的成人礼:你描述的不是过程,是结构。
FPGA:可重构的电路橡皮泥
FPGA 芯片里整齐排着海量查找表(任何四五输入逻辑函数都能查表实现)、触发器(2.3 节的时序细胞)、以及可编程互连与块存储、乘法器等硬核。设计流程是纯软件化的:写硬件描述语言 → 综合器把代码映射成查找表网络 → 布局器安排位置 → 布线器连通 → 生成比特流烧进芯片。改设计等于重烧一次,几分钟到几十分钟一轮迭代。
图 4.3-1 同一算法的两种实现范式:状态机 与 流水线
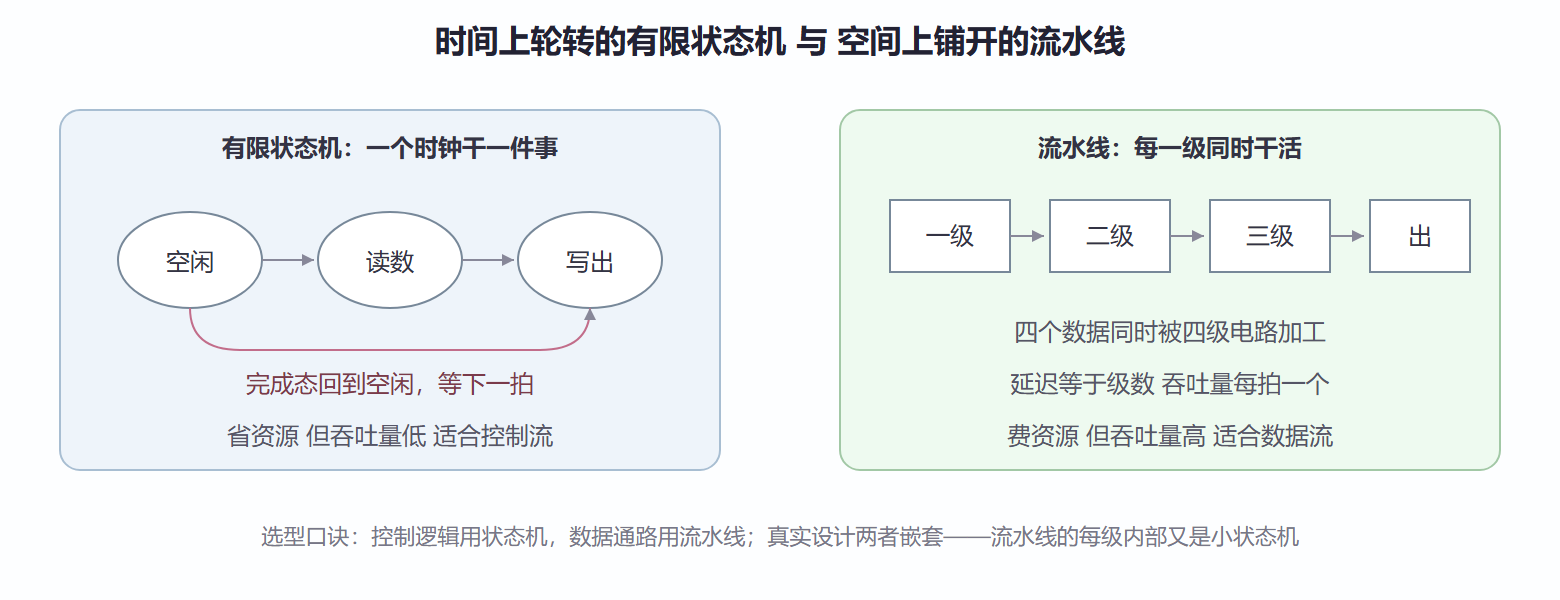
流水线的吞吐量账本:N 级流水线首结果延迟 N 拍,之后每拍出一个结果——面积换成吞吐的明码交易。第五章 OFDM 的 FFT、8.1 雷达的脉冲压缩,在硬件里无一例外是流水线实现。
动手:一个 FIFO 缓冲控制器的骨架
跨时钟域搬数据(4.2 节遗留的难题)的标准答案是异步 FIFO。给出其核心的"指针比较"设计,体会硬件思维:
module fifo_ctrl #(parameter DEPTH=16) ( input wire wclk, rclk, rst_n, input wire wr, rd, output reg full, empty, output reg [$clog2(DEPTH)-1:0] wptr, rptr ); always @(posedge wclk or negedge rst_n) begin if (!rst_n) wptr <= 0; else if (wr && !full) wptr <= wptr + 1'b1; // 写指针只归写时钟管 end always @(posedge rclk or negedge rst_n) begin if (!rst_n) rptr <= 0; else if (rd && !empty) rptr <= rptr + 1'b1; // 读指针只归读时钟管 end // 空满判断用格雷码指针跨域比较:相邻值仅一位变化,亚稳态危害最小化 wire [$clog2(DEPTH):0] wgray = (wptr >> 1) ^ wptr; // 二进制转格雷 wire [$clog2(DEPTH):0] rgray = (rptr >> 1) ^ rptr; assign empty = (wgray == rgray); assign full = (wgray[$clog2(DEPTH)] != rgray[$clog2(DEPTH)]) && (wgray[$clog2(DEPTH)-1:0] == rgray[$clog2(DEPTH)-1:0]); endmodule
三处设计智慧值得咀嚼:写读指针分别只被各自时钟驱动(跨域隔离);指针转格雷码再跨域比较(相邻态单比特变化,配合 2.3 节的同步器,亚稳态风险最小);空满判断用"高位不同余相同"的对称技巧。一个不到二十行的模块浓缩了本节与前两节的一半知识点。
ASIC:把电路铸进硅片
FPGA 的查找表是"通用鞋",ASIC 直接为你的算法定制"跑鞋"。数字全流程:寄存器传输级代码 → 功能仿真 → 综合(映射到工艺库的标准单元) → 布局布线 → 时序签核与物理验证 → 版图交晶圆厂流片。每一步的工具类型与检查目的在第九章 9.1 展开,此处先记结论:从代码到芯片的周期以月计,一次改错的代价以百万计——这与 FPGA 的"分钟级重烧"是两个世界。
代价换来的是数量级收益:同功能 ASIC 的面积、功耗、单位成本在量产百万片后远优于 FPGA。铁三角"面积、性能、功耗"在设计里此消彼长:流水线加深提速但费面积;阈值电压降低提速但漏电上升;时钟门控省电但要加控制逻辑。芯片设计工程师的日常就是在三者间挪预算。
板凳深度:先进封装与芯粒
单芯片逼近工艺极限后,行业转向"拼装":芯粒(Chiplet)把大芯片拆成多颗小芯粒,用先进封装互联,良率与成本同时改善——每颗小芯粒面积小良率高,还能混用不同工艺(计算用最先进节点、接口用成熟节点)。这与建筑设计从"独栋"走向"预制件装配"的演进逻辑一致,也是第十章讨论延续摩尔路线的伏笔。
⚠️ 常见坑:用软件思维写硬件——大段 if 分支与深层组合逻辑,综合后时序不满足还不知何故。硬件代码的纪律:时序逻辑用阻塞感强的模板写、组合逻辑限制层级深度、跨域必上同步器、复位策略全项目统一。
常见疑问两则
问:FPGA 既然能反复烧写,为什么不全部用它?答:三个硬约束:单价(同容量 FPGA 比 ASIC 贵一到两个数量级,量产必亏)、功耗与面积(可重构结构本身占资源,能效比 ASIC 差数倍)、静态漏电。合理分工是:原型与小批量验证用 FPGA,百万级量产固化 ASIC;通信基带则常用"FPGA 加 ASIC"混合,算法可变部分留在 FPGA。
问:状态机的编码方式(独热码、二进制、格雷码)怎么选?答:FPGA 寄存器富余,独热码(每状态一比特)译码快、综合器友好,是默认选择;ASIC 门数敏感,倾向二进制紧凑编码;跨模块或低功耗场景用格雷码减少翻转。一个小小的编码选择,背后还是"资源换速度"与"翻转省功耗"的老账本。
本节要点回顾
- 硬件描述语言描述结构不是过程,并行是默认态;
- 状态机管控制流、流水线管数据流,真实设计是两者的嵌套;
- 格雷码加同步器是跨时钟域指针传递的标准安全带;
- FPGA 迭代分钟级、ASIC 流片月级,验证投入要与返工代价成正比;
- 铁三角挪预算是芯片设计日常,芯粒与先进封装开辟第二战场。
比特的加工厂全部建好。下一章信号终于要上路:调制,让比特骑上载波,向空中出发。