3.4 计算模拟:从原子预测宏观
3.4 计算模拟:从原子预测宏观
本节摘要: 纳米对象的规律散落在量子、原子、连续三个层级,单一解析手段覆盖不了,计算模拟因此从辅助工具变成设计主线。本节讲三支主力方法(第一性原理、分子动力学、连续介质衔接)、它们各自的可信域与成本,以及一个标准模拟工作流的决策树与验证纪律。
为什么纳米研究离不开模拟
三层理由。其一,尺度夹缝。 纳米对象太大,量子化学精确解不动;又太小,连续介质近似失真——恰好卡在两个经典工具都够不着的地方,必须用多尺度方法搭桥。其二,实验贵且"测不准"。 纳米实验的表征(第 5 章)往往破坏样品或只能看系综平均,模拟能补上单颗粒、单帧、原子级的"虚拟测量"。其三,试错成本。 材料发现的传统周期以十年计;高通量计算加数据库(材料基因组的思路)把初筛搬进机器,把实验留给决赛圈。
三支主力与可信域
第一性原理(DFT,密度泛函理论)。 从电子结构出发,不依赖拟合参数,能算能带、态密度、表面吸附能、反应势垒。可信域:数百原子以内、零温为主(声子与有限温处理贵)。典型用途:判定一种表面改性把功函数改了多少、某反应路径的速控步垒高。局限要牢记:交换关联泛函的近似让绝对值有偏差,范德华作用需要专门修正泛函——算层状材料的层间距时用错泛函能错百分之十几。
分子动力学(MD)。 原子为粒子、按经验势或机器学习势演化牛顿方程,得到轨迹与统计量。可信域:数十万到数亿原子、纳秒到微秒。典型用途:纳米颗粒的团聚与熔化、界面热阻、纳米通道里的流体输运、力学响应。经典经验势快但可迁移性差——换个化学环境就可能失真;机器学习势以 DFT 数据训练,把 DFT 级精度带到 MD 的尺度,是近年最大变量。
连续介质衔接。 传热、流体、弹性问题在器件尺度仍要用有限元,但材料参数由原子级模拟喂进去(界面对导热的卡门阻、纳米复合物的有效模量)。多尺度的语法是"下层出参数,上层出响应"。
| 方法 | 原子数 | 时长 | 输出强项 | 典型坑 |
|---|---|---|---|---|
| DFT | 约 10²–10³ | 静态为主 | 电子结构、能垒 | 泛函近似、范德华失准 |
| 经验势 MD | 10⁵–10⁸ | 纳秒–微秒 | 动力学、统计量 | 势函数超出标定域即失真 |
| 机器学习势 MD | 10⁴–10⁷ | 纳秒 | 接近 DFT 精度的动力学 | 训练集覆盖不足处外推危险 |
| 有限元 | 连续体 | 任意 | 器件级响应 | 参数必须由下层喂,不能拍脑袋 |
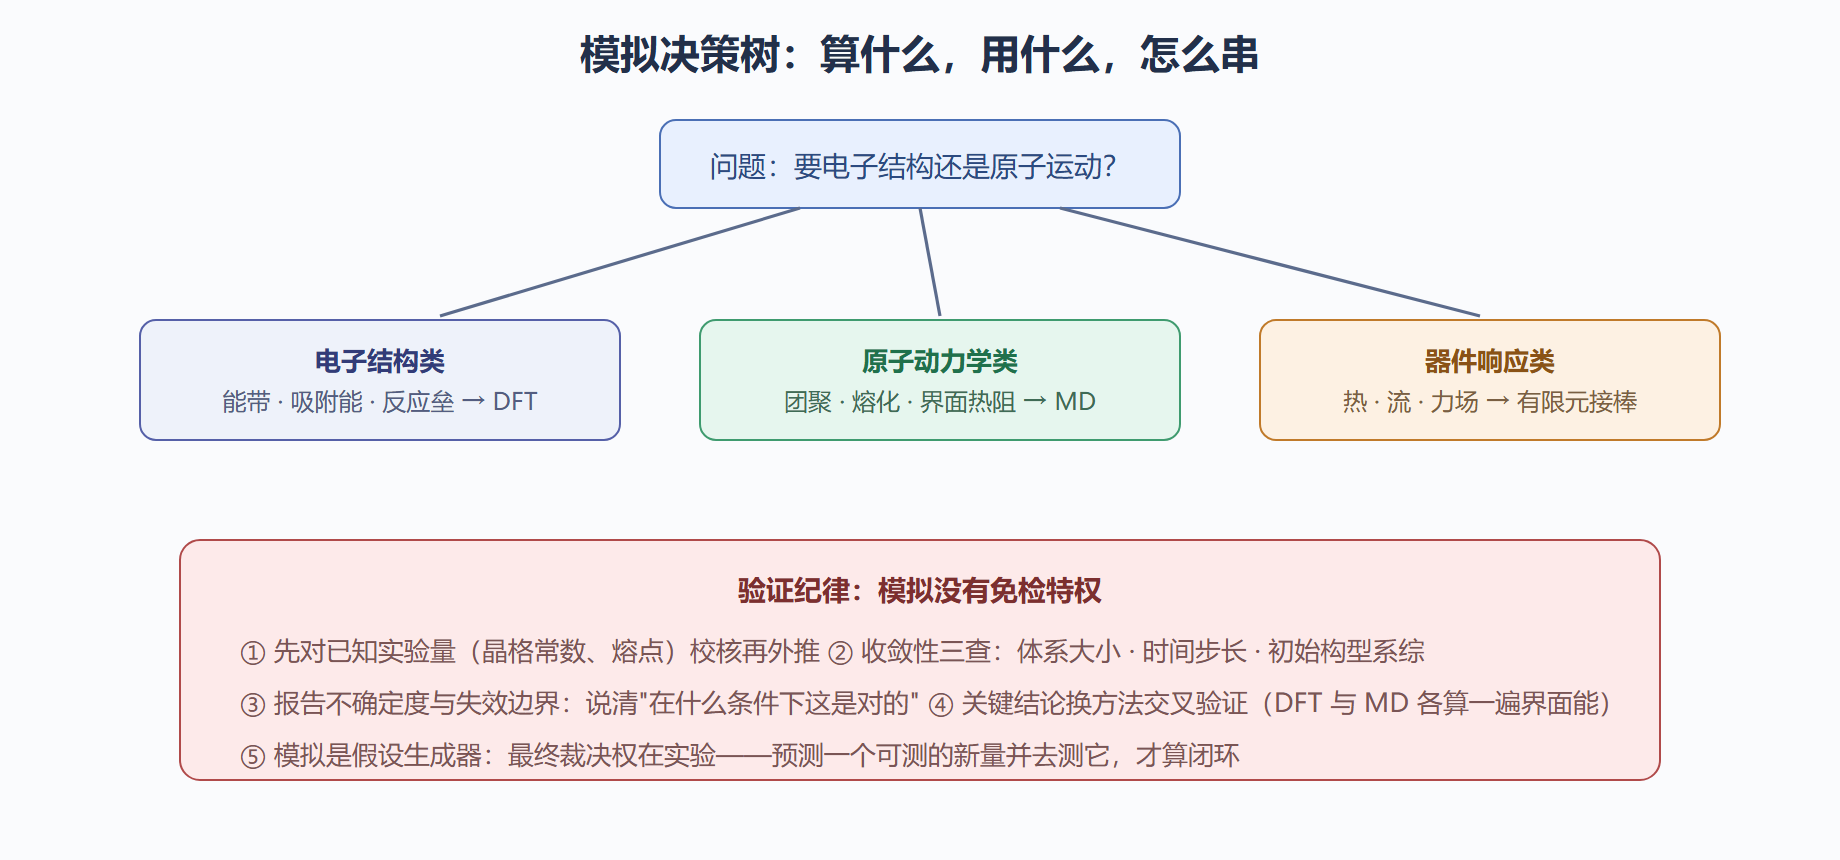
概念代码:一个 MD 工作流的骨架
以"纳米颗粒在溶液中的稳定性"为例,伪代码勾勒工作流:
工作流 颗粒稳定性行动: 构型 ← 切出直径 5 nm 颗粒, 松弛表面 # 先让物理合理的几何就位 力场 ← 选机器学习势或经验势, 查标定域 # 确认势函数见过这种化学环境 平衡 ← 恒温恒压跑 1 ns, 监控能量温度漂移 # 没平衡的轨迹一切统计无效 生产 ← 三条独立初速度的生产轨迹, 各 100 ns # 单轨迹是轶事, 系综才是数据 统计 ← 径向分布函数 + 配位数 + 均方位移 判据 ← 若径向分布首峰随时间锐化 → 正在团聚, 需加配体 闭环 ← 预测"加某配体后团聚时间翻倍" → 交给合成实验验证
这套骨架的每一步都在防一类事故:松弛防"伪应力"、标定域检查防外推、平衡监控防"没热身就统计"、多轨迹防把涨落当结论。
坑与业界现状
三个高频坑。坑一,精度错觉。 经验势在小体系上复现了文献 melting point,就敢外推大体系——势函数没见过的构型空间里它给出的数是"编的"。坑二,时间尺度鸿沟。 MD 能算微秒,扩散控制的真实过程要毫秒到秒,直接外推等于把慢过程的结论快进播放;增强采样(伞形采样、元动力学)是正规解法,但引入了偏置势,反分析要谨慎。坑三,图表美学掩盖统计。 单帧截图配漂亮渲染不构成证据,均方位移曲线不带误差棒不构成结论。业界现状:高通量材料数据库把 DFT 结果做成可检索资产,机器学习势把 DFT 精度带进 MD 尺度,自动化实验室把"模拟预测→机器人合成→表征回填"连成闭环——第 8 章会看到这条闭环的全貌。
💡 关键直觉:把模拟器当"高精度外推仪"而非"真理机器"。它最值钱的输出不是某个数字,而是趋势与排序(A 比 B 更稳定、增加配体密度单调推迟团聚)——数字会随泛函与势函数漂移,稳健的排序才是决策依据。
算例:一次跨尺度的参数接力
用界面热阻问题走一遍"下层出参数,上层出响应"。背景:芯片里散热瓶颈常不在材料体内而在界面——硅与二氧化硅、金属与介质之间有一层几纳米的原子失配区,热流在此打折。接力第一棒(DFT):算界面两侧原子级的声子谱失配与键合强度,得到单位面积界面热导的上限估计——体系只有几百原子,恰好是 DFT 的可信域。第二棒(MD):把同样界面建成几千原子的模型,非平衡态跑热流,统计温度跃变除以热流得到界面热导,与第一棒交叉核验量级是否一致(差三倍以内算通过,差十倍说明有一边建模有错)。第三棒(有限元):把热导作为边界条件喂进芯片级热模型,回答工程问题——这个界面让结温升了几度、要不要加一层碳化钛导通桥。注意每一棒的产出与消耗:第一棒给机理与上限,第二棒给含缺陷统计的现实值,第三棒给决策数字。任何多尺度报告都应该能画出这条接力图——说不清参数从哪来、到哪去的多尺度模拟,只是把不确定性问题转移了坐标。
一个高频追问:算力和方法的边界在哪? 粗算可知:一台服务器跑一天 DFT 大约能优化数百原子的结构;机器学习势 MD 一天能跑千万原子纳秒级。反过来推需求:想知道蛋白冠在纳米颗粒上的构型(微秒、百万原子),DFT 不可能、经验势不准,只能机器学习势加增强采样——先算这笔账再立项,能省下大量试错时间。
要点回顾
- 纳米对象卡在量子化学与连续介质都够不着的尺度夹缝,多尺度模拟是必经之路
- 三支主力:DFT 出电子结构、MD 出动力学、有限元出器件响应,"下层出参数,上层出响应"
- 机器学习势是近年最大变量,把 DFT 精度带到 MD 尺度,但训练集外推同样危险
- 验证纪律五条:先校核再外推、收敛性三查、报告失效边界、交叉验证、实验闭环
- 模拟最可靠的输出是趋势与排序,不是绝对数字
理论主线到此收束。第 4 章转入制造:怎么把账本上的设计变成实物。