8.1 能源大数据与人工智能:预测与优化双引擎
8.1 能源大数据与人工智能:预测与优化双引擎
能源人工智能的两个主引擎:预测(负荷、新能源出力、设备故障)与优化(调度、定价、运维策略)。它们的商业价值有一条铁律:预测误差直接换算成备用容量成本,优化质量直接换算成燃料与电费。
数字化章第一站。第 7 章说"波动是新型电力系统的头号挑战",本节展示算法如何压缩这个挑战;它通往 8.2 节(预测与优化要落地,需要边缘侧的实时数据管道)与第 10 章(AI 也是聚变控制与新材料筛选的加速器)。
一个负荷预测任务的完整解剖
把"预测明天整座城市的用电曲线"这个任务拆开,看每一层工程决策。特征侧:气象(温度湿度是空调负荷的第一驱动)、日历(工作日与周末差出一成,节假日另算)、历史负荷(强自相关)、特殊事件。模型侧:从梯度提升树到长短期记忆网络再到Transformer类时序模型,精度提升一档,工程复杂度也升一档。考核侧:平均绝对百分比误差降一个百分点意味着什么?
# 预测误差的经济价值估算(示意) city_peak_mw = 12000 # 某城市晚高峰负荷 reserve_cost = 350 # 旋转备用容量价格, 元每兆瓦每小时 err_old, err_new = 0.03, 0.02 # 误差从3%降到2% saved = city_peak_mw * (err_old - err_new) * reserve_cost print(f"每日节省备用成本约 {saved} 元") # 输出约 42 万元每天——一个百分点的误差价值千万级年化 # 这就是能源AI的定价锚: 算法费用只要低于备用节省就有商业闭环
这个算例揭示了能源AI行业的商业模式本质:卖的不是模型是"减少的不确定性"。同一条逻辑链适用于新能源功率预测(考核偏差电量罚款)、设备故障预警(非计划停机一天的损失以百万计)与现货市场价格预测(发电商的报价策略)。
优化引擎:从经济调度到数字孪生
预测回答"未来什么样",优化回答"现在怎么办"。经典的机组组合问题在数学上是混合整数规划:哪些机组开、各发多少,满足负荷、备用与网络约束下成本最小——变量数随机组数指数爆炸,求解器与启发式算法在此深耕数十年。新能源时代的升级版多了储能充放策略(充放时机是随机优化问题)、需求响应邀约(用户侧的多目标优化)与配电网重构(拓扑组合优化)。
数字孪生是优化引擎的豪华形态:把物理电网映射成实时同步的仿真模型,规划人员在孪生体里预演"如果这里加装储能""如果台风登陆"再落到现实。两个已落地的场景:一是调度培训与事故预案推演,把停电恢复流程在孪生体里排练;二是新能源消纳评估,新场站并网前先在孪生网里测电压与短路电流影响,替代昂贵的现场实测。
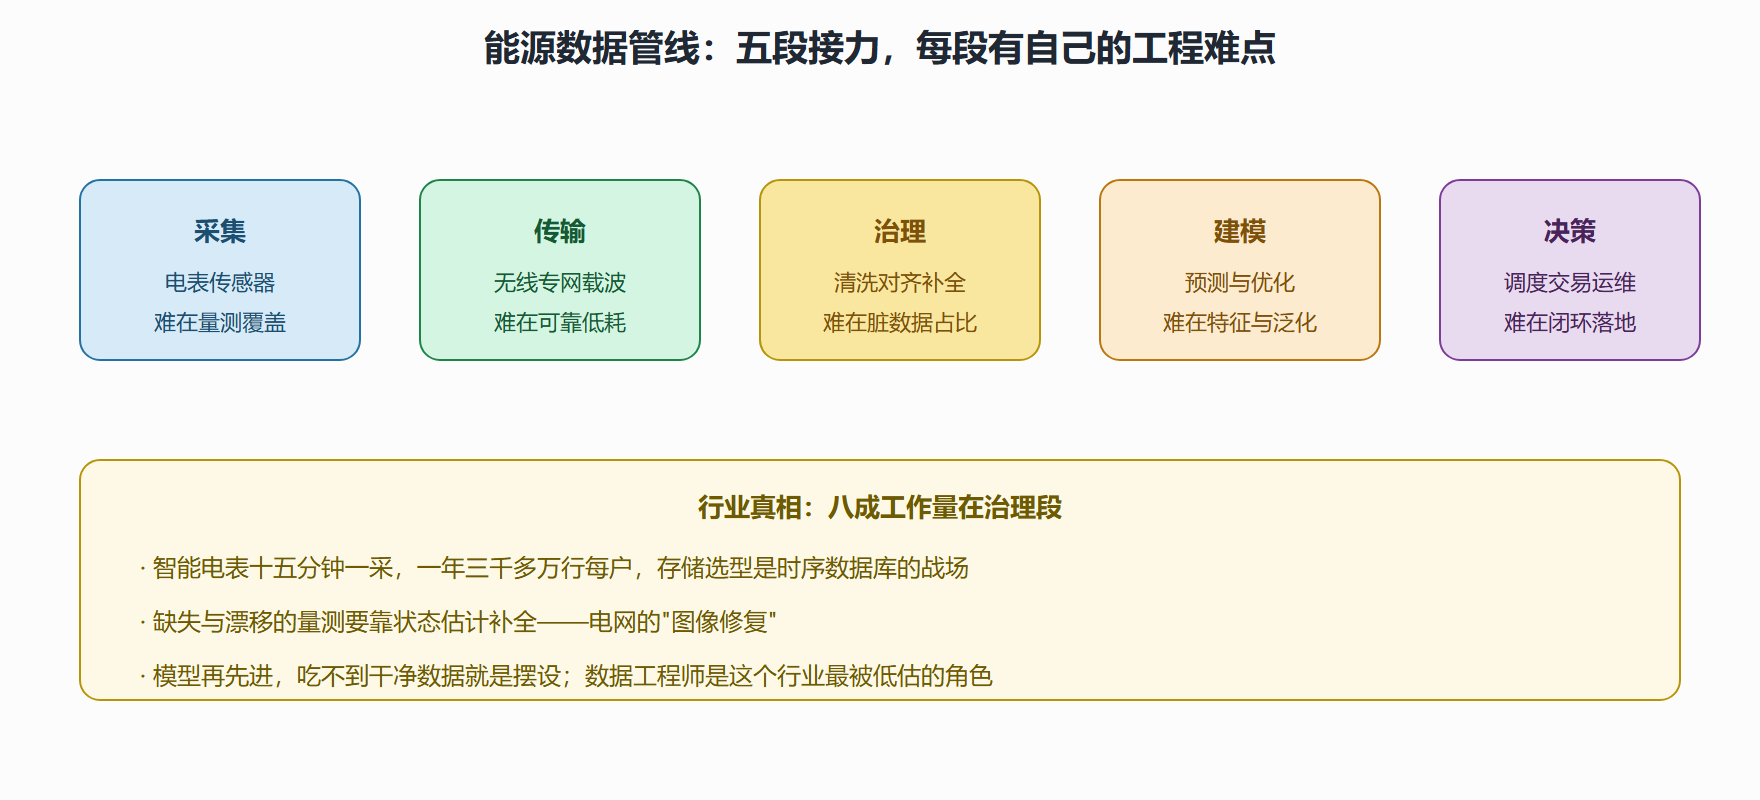
图 8-1 能源数据从表计到决策的全管线
⚠️ 常见坑:盲目上大模型。负荷预测这类强规律任务,梯度提升树配好特征往往打平深度模型且可解释、可运维;把大模型用在数值预测上是拿牛刀杀鸡还杀不利索。AI 选型的第一问永远是数据结构与误差成本,不是模型热度。
本节要点回顾
- 误差即成本:预测每准一个百分点,备用与罚款成本千万级下降,这是能源AI的定价锚;
- 优化是第二引擎:机组组合、储能策略、网络重构,数学规划是电网的老手艺;
- 数字孪生用来预演:规划推演与事故排练是两个已验证的落地场景;
- 八成功夫在数据:采集传输治理的工程质量决定模型上限。
案例复盘:一次光伏功率预测考核的翻盘
西北某 200 兆瓦光伏电站连续两个月被调度考核——功率预测偏差电量罚款累计近百万元,站长第一反应是换更贵的模型。算法团队进场后先做归因,发现问题根本不在模型:气象源用的是县城预报,场址在四十公里外的戈壁,云团路径差异让辐照预测系统性跑偏;此外组件积灰导致实际出力比同辐照下的历史均值低约 6%,模型的物理基线从源头就歪了。整改三步:接入两家数值天气预报并按场址网格点插值、加装场内辐照仪做实时纠偏、把清洗周期纳入特征。两个月后考核电量降了七成,模型本体一行未改。这个案例是本节"数据决定上限"的完整注脚,也给从业者一条排查口诀:预测不准先查三个错位——气象源与场址的错位、设备状态与历史基线的错位、考核口径与训练目标的错位,最后才轮到模型。
常见问题与易错点
问题一:负荷预测误差 2% 到底算好算坏?
看时空颗粒度。日前省级负荷预测误差做到 2% 属于优秀,超短期(未来四小时、每十五分钟一个点)可以压到 1% 以内;但若是单台户用光伏的出力预测,10% 也属正常——不确定性随对象缩小而放大。比较预测水平必须同对象、同时间尺度、同考核口径,跨口径的"我们的误差更低"是行业营销的常见话术。
问题二:人工智能会取代调度员吗?
可预见的未来是"人机协同"。算法擅长海量变量的连续优化,调度员擅长罕见工况的判断与责任承担——系统里总要有那个"敢按下按钮、能为决定负责"的人。现实演进是决策支持:算法给出方案与置信度,人在异常与边界场景兜底。这与第 4 章核电"安全文化"的结论一致:自动化改变人的角色,不取消人的责任。
动手验算
用本节开头的算例做个敏感性实验:把备用价格从 350 改为 200 元每兆瓦每小时,误差从 3% 降到 2% 的日价值从 42 万降到 24 万元——同一套算法在不同市场里价值差近一倍。再想想:若该城市新能源占比升到四成,备用需求本身放大,算法价值还会水涨船高。能源AI 的市场空间,本质上是"不确定性总量"的函数——新能源越多,这门生意越大。
最后补一条工程伦理提醒:能源AI系统的错误有物理后果。预测模型把置信度低的输出当确定值下发、优化算法在约束建模漏掉一条线路的载流限值,都可能引发真实设备动作。所以能源场景的算法落地有三条行规:关键决策保留人工确认环节与回滚预案;优化结果必须经过潮流校核等物理可行性验证才能执行;模型版本与训练数据留档,事故可追溯。这三条与第 4 章核安全文化同源——凡是错误代价高昂的系统,自动化都要在"可审计、可干预、可回退"的框架内运行,这是跨行业的通用律。
再给一个数据治理的实操提醒:能源数据工程里最耗时的从来不是建模而是对齐——表计口径与结算口径对齐、设备台账与实时测点对齐、多系统时间戳对齐。行业里流传的"八成时间在洗数据"并不夸张。评估一个数据项目进度时,先问数据字典与点表完成度,比问模型准确率更能预测它能否按期上线。