4.1 节点去哪儿:移动性建模与链路寿命预测
4.1 节点去哪儿:移动性建模与链路寿命预测
移动性建模把节点的运动抽象成可仿真、可分析的数学过程(随机游走、随机路点、高斯马尔可夫);链路寿命预测则从两个节点的相对运动推算无线链路还能维持多久,用于在断链之前主动换路。
不掌握运动规律,就没法评估任何动态机制。你改进的路由协议到底比原版强多少?答案取决于节点怎么动——同一协议在慢速游走场景稳如泰山,换成车载场景可能一塌糊涂。移动模型因此是仿真实验的"自变量",选错模型,结论全部作废。链路寿命预测则是把运动知识变现的那一步:既然知道双方在怎么动,就能算出"这条链路还剩几秒",从而把断链处理从被动救场升级为主动换角。
三个模型,三种性格
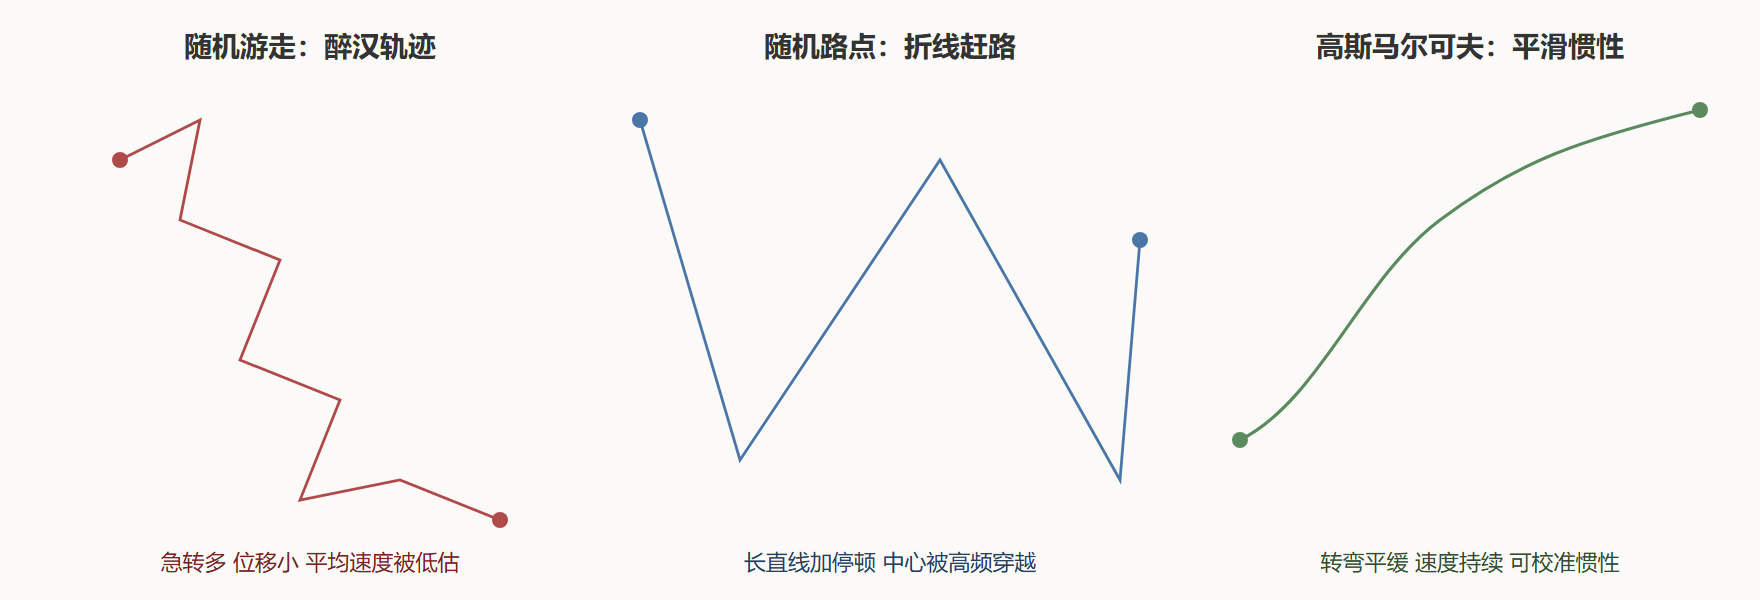
随机游走最简单:每隔一段固定时间(或每走一段固定距离),随机选一个方向与速度走下一步。它无需任何参数与记忆,但有个著名毛病——节点轨迹像醉汉,频繁急转弯与原地打转,统计出的平均速度严重偏低。随机路点为场景仿真而生:在区域里随机挑一个目的点与一个速度,匀速走过去,停顿片刻,再挑下一个点。它比随机游走"像人",但区域中心会被系统性高频穿越(边界无人经过),且长时间仿真后平均速度持续下滑(快节点先到达并积累在高概率路径上,产生稳态偏差)。高斯马尔可夫介于两者之间:当前速度是上一时刻速度与新随机扰动的加权混合,权重参数控制"惯性"大小——参数取极限时退化为随机游走,取另一极限则成为匀速直线。它能校准出"合理的转弯频率与速度持续性",因此成为车载与人携带场景的常用选择。
图:三种模型的轨迹性格
一段可跑的高斯马尔可夫一维速度更新(二维就是横竖各来一份):
import random # 高斯马尔可夫速度更新:alpha 越大惯性越强 alpha = 0.75 # 记忆系数 mean_v = 8.0 # 期望速度,米每秒 sigma = 2.0 # 扰动强度 v = mean_v for step in range(6): v = alpha * v + (1 - alpha) * mean_v + sigma * random.gauss(0, 1) print(f"step {step}: 速度 {v:.2f} m/s") # 示例输出(每次运行不同): # step 0: 速度 9.14 step 1: 速度 10.37 # step 2: 速度 9.05 step 3: 速度 8.71 # step 4: 速度 7.42 step 5: 速度 8.26
真实轨迹模型是第四条路:直接拿出租轨迹、通勤班车 GPS 记录、无人机航线回放给仿真器。它的可信度最高,但只能回答"在这条轨迹上"的问题,外推要谨慎。工程实践通常是三段式:随机路点做初筛,高斯马尔可夫做参数扫描,真实轨迹做验收仿真。
链路寿命:几何题一道
两个节点都在动,什么时候互相走出射程?把问题放到相对运动里看:设 A、B 相距 d,相对速度大小为 v_r(向量差的模),沿连线方向的分离速度分量为 s(靠近为负、远离为正),通信半径 r。若 s 大于零(正在远离),链路剩余时间的粗估就是 (r - d) 除以 s;s 小于等于零(在靠近或平行),本窗口内链路不会因距离失效,剩余时间记为无穷,交给下次评估。真实环境再叠加信号起伏,工程上把 r 打个折(比如取零点九 r)当预警线,提前触发换路。
def link_residual_time(d, r, s): # d: 当前距离米; r: 通信半径米; s: 分离速度米每秒(负为靠近) if s <= 0: return None # 本窗口内不会因距离断链 return (r - d) / s # 粗估剩余秒数 # 例:相距120米,半径150米,正以3米每秒远离 print(f"链路剩余约 {link_residual_time(120, 150, 3):.0f} 秒") # 输出:链路剩余约 10 秒 —— 足够在断链前发起换路
这个估算的价值不在精确(真实信道有起伏),而在给协议一个提前量:剩余十秒,就足够 AODV 发起一次按需寻路(典型一两秒内完成),把"断链后丢包重传"变成"断链前无缝切换"。预测的盲区也要记住:它只看几何,不看遮挡与干扰——拐过一个街角,几何距离没变信号却没了。所以预测要与链路质量监测(第4.2、5.1 节的信道估计)互为补充,几何管趋势、信号管现实。
一次模型选错的返工
背景:某车联网预研项目用随机路点模型评估邻居发现机制,结论"平均邻居表波动在百分之十以内,机制可靠"。操作:进入实车测试,装在城市通勤车队上跑了一周。结果:实测邻居表波动达百分之四十,机制频繁触发重建,控制开销是仿真的三倍。解读:通勤车流有明显的同向结队与对向掠过两种模式——同向时相对速度小、邻居关系长久;对向时相对速度高达两倍车速、邻居几秒内清空。随机路点完全没有这种结构性,把两种极端抹平成了温和的平均。返工做法:改用真实轨迹回放重测,并按"同向、对向、路口交汇"三类场景分别给出指标区间。教训:模型的平均指标可能全部正确,而分布的全部尾部都错——协议恰恰活在尾部。
轨迹数据从哪来
要用真实轨迹,先得有轨迹。三个来源按可信度递增:一是公开数据集(出租车、公交、校园无线关联记录),量大便宜,但场景匹配度要自查——出租车轨迹对仓库场景几乎无参考价值;二是自采,给设备或车辆加定位记录模块跑一两周,成本可控且场景完全对口,是正式项目的标准动作;三是混合合成——拿自采轨迹提取统计特征(速度分布、停留时长、方向转移概率),喂给参数化模型生成更多样本。第三种最容易被低估:它兼具真实性与可扩展性,做参数扫描时不用反复追车采数据。无论哪种来源,交付物都应该是同一格式——时间戳加坐标加状态(移动或停留),这个格式能直接喂给 5.3 的仿真器,也让 4.1 的成果沉淀为团队资产而不是一次性脚本。
台词摘录
- 模型即自变量:仿真结论只在所选模型的世界上成立,换模型先换结论。
- 三个性格:随机游走低估速度、随机路点偏爱中心、高斯马尔可夫可校准惯性。
- 三段式评估:随机路点初筛、高斯马尔可夫扫参、真实轨迹验收。
- 寿命公式:剩余距离除以分离速度,几何管趋势,信号管现实。
- 警惕平均:协议活在分布尾部,模型把尾部抹平等于把问题藏起来。