7.3 发门牌与接轨:地址分配、互操作与轻量栈
7.3 发门牌与接轨:地址分配、互操作与轻量栈
地址自动分配让节点在没有地址管理机构时自领门牌并查重(随机自选加冲突检测,或代理分号);互操作把 Mesh 世界与 IP 世界缝合(网关地址映射加分组封装);轻量协议栈把栈的内存与代码体积裁到小设备背得动的程度。三者是大规模落地的最后一公里。
有中心网络里,地址是发下来的(DHCP 服务器分配、运营商放号)。自组织网络里谁来发号?节点可能同时开机、先后到场、中途合并两个网——两套网络一合并,门牌撞号是大概率事件。地址这件"小事"没有中心时一点也不小:路由、信誉、安全全部锚定在地址上,撞号轻则路由错乱,重则安全身份张冠李戴。
自领门牌的两条路
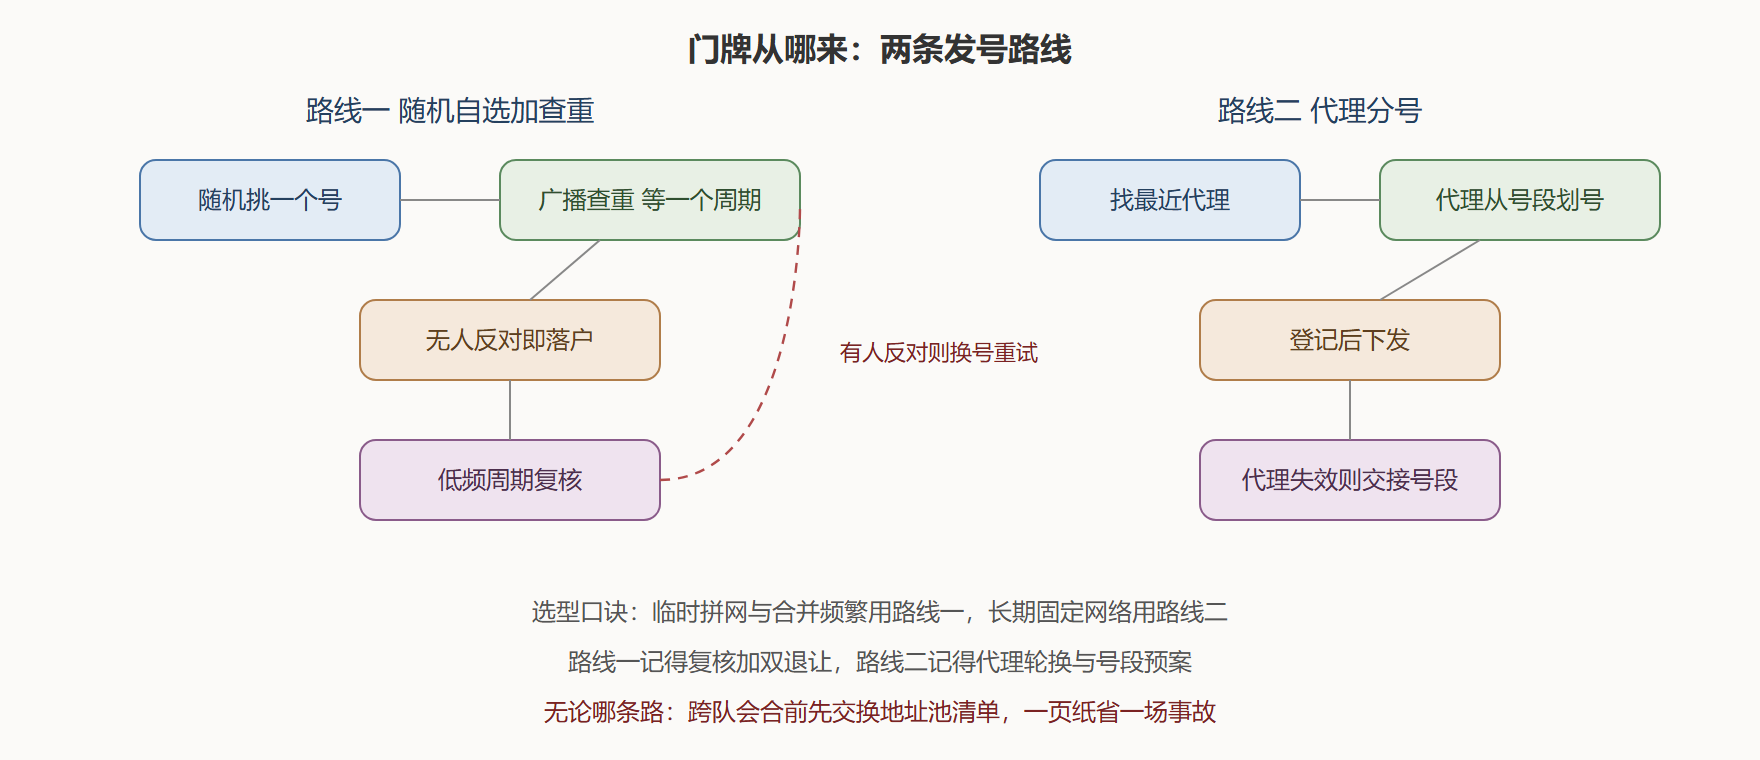
随机自选加冲突检测:节点在地址池里随机挑一个(或按硬件标识推导一个),然后向全网(或其所在域)广播"有人用这个号吗",等一个周期没人反对即落户;有人反对就换号重来。这在合并网络时会漏判——两个子网各自用过同一个号、各自都"无冲突",合并瞬间冲突才显现,而两边的持有者会同时收到对方的查询却都以为对方在攻击自己。所以工程版本要加冲突复核:落户后周期性低频重查,且冲突时双方都退让重选(而不是僵持)。代理分号:新节点向最近的已落户节点要号,代理从自己管理的号段里划一个给它,号段不够再向别的代理要。这把冲突概率压到代理边界,代价是代理要维护号段状态——代理失效时号段的归属要交接,这与 7.2 骨干轮换是同一类问题。
随机自选加检测的一个生命周期(示意): 上线:随机选号 A,广播地址冲突查询,TTL 限域内 无应答(等一个探测周期):落户,登记到本地地址表 收到应答:换号重选,重试上限 3 次 落户后:每 10 分钟低频复核一次(合并网场景的补漏) 冲突处理:双方同时退让,各自重选并广播新号 已有会话的节点收到新号通告:更新映射,会话不断
与 IP 世界接轨
Mesh 网络最终几乎都要接进 IP 世界(回监控中心、上云、被远程管理)。接轨的构件是网关,它做四件事。地址映射:Mesh 内部地址与 IP 地址双向翻译(网络地址转换式,或代理式——网关替内部节点对外应答)。分组封装:Mesh 报文过网关时加上 IP 外壳(或反之拆壳),路由域边界清晰互不渗透。质量等级翻译:Mesh 内部的优先级类别映射到 IP 侧的队列标记,别让语音过了网关就降级成尽力而为。安全衔接:Mesh 内的轻量认证(预共享密钥类)与 IP 侧证书体系在网关处对接,通常做法是网关双身份——对内是仲裁者,对外是唯一暴露面。多网关部署还要处理出口选择:流量从哪个网关出去(就近、负载均衡、主备),这直接复用 2.3 异构融合的架构,网关就是那里"翻译官"的具体化。
把协议栈塞进小设备
末端传感节点的全部内存可能只有几十 KB,标准 IP 栈一个人就吃掉大半。轻量化的三板斧。头部压缩:低功耗无线里 IP 头那四十字节对一百字节的 payload 是暴殄天物,6LoWPAN 一类适配层把头部压到几字节,核心思想是"链路上下文里能推断的字段就不传"。状态裁剪:全功能 TCP 窗口机、乱序重排缓存都砍到最小,传感业务多数是短报文,UDP 加应用层确认就够了——协议能力与业务需求对齐,不背包袱。代码可裁剪:把栈按功能模块化编译(要 IPv6 就不带 IPv4,要 CoAP 就不带 HTTP),配置驱动装配。下表是选型时的心智清单:
| 维度 | 全功能栈 | 轻量栈(含 6LoWPAN 类) |
|---|---|---|
| 内存占用 | 数百 KB 级 | 数十 KB 级 |
| 报文开销 | 头部完整 | 头部压缩到几字节 |
| 传输层 | TCP 全套 | UDP 加应用层确认 |
| 互操作性 | 天然 | 需网关或适配层翻译 |
| 适用设备 | 网关与骨干 | 末端传感节点 |
注意轻量栈的代价是翻译层:它省下的每一字节都要在网关处用复杂度赎回。所以轻量化是"末端省、网关还"的债务结构——部署规划时要确认网关有足够算力接住这笔债。
一次网络合并的事故与修复
背景:两支救援队各自带着一个三十节点的 Mesh 网会合,合并后约二十分钟出现诡异的"报文串台":A 队的三号传感器数据出现在 B 队的指挥屏上。操作:排查发现两队部署时都在各自网里随机自选了地址,撞号的有四个节点;合并后冲突检测只触发了两个(另外两个的冲突查询被高负载期的丢包吃掉了,恰好都是低频复核还没轮到的节点)。修复:现场把两队的地址池强制划分为不重叠的号段(人工划定),四个撞号节点手工改号并广播映射。事后改进:部署规范新增"跨队会合前先交换地址池清单";协议配置把冲突复核周期从十分钟压到两分钟、复核报文加高优先级。解读:随机自选的漏判概率不大,但小概率乘上大规模部署就是必然事故;而冲突查询这类"低频保命消息"恰恰最容易被拥塞牺牲,必须给它优先级保护——这与 5.2 的区分服务正好接上。变式:如果两队用的是代理分号且各自代理的号段来自同一个预分配计划(会合前就规划过不重叠号段),合并就完全无痛——地址这件事,事前一页纸的规划胜过事后所有补丁。
规模化运维的隐形墙
地址与栈之外,大规模落地还有一堵常被低估的墙:批量运维。一千个节点的固件升级不是"点一千次确定",它需要分批灰度(先百分之一观察一夜)、失败回滚(升级失败自动回退旧版本)、断点续传(中途断电不砖)三件套;任何一件缺失,第一次大规模升级就会变成事故复盘会的主角。同理还有配置变更的版本化(谁改的、改了什么、怎么撤回)与时钟基准的统一(6.3 提到的日志时间戳依赖它)。这些运维机制在几十节点的项目里看不出差别,上千节点后就是生死线——评标时问一句"固件升级怎么做灰度",能过滤掉一多半没做过规模的方案商。
对接轨的网关还有一条低调的红线:出口唯一性与源地址一致性。多点出口(多个网关)时,同一内部会话若从不同网关出去,返回流量的路径与状态就对不上,表现为"时通时断"。标准解法是会话粘性——同一会话的报文始终从同一网关出;网关故障切换时要连同映射状态一起迁移。这一条排障时的特征很明显(换条路就断),记住它能在出口问题上省下大半天。
两种发号路的一张对照图
随机自选与代理分号的流程差异,画在一张图里最直观:左边是"自己挑号、全网查重",右边是"找代理领号、号段管理"。图底部的两行注释是选型的关键——前者部署零依赖但合并网络时要防漏判,后者平时安稳但代理交接要做对。
图:地址自动分配的两条路线
台词摘录
- 地址即锚点:路由、信誉、安全都锚在地址上,撞号是系统性风险不是小毛病。
- 两条发号路:随机自选要配周期复核与双方退让,代理分号要处理代理交接。
- 网关四件事:地址映射、分组封装、等级翻译、安全衔接——对外唯一暴露面。
- 末端省网关还:头部压缩与栈裁剪的债,由网关的算力赎回。
- 保命消息优先:冲突检测与复核要享受高优先级队列,别被拥塞牺牲。