8.2 会学习的网络:AI 驱动的自组织决策
8.2 会学习的网络:AI 驱动的自组织决策
学习型网络用机器学习替代或增强协议里的启发式规则:强化学习做路由与信道选择,异常检测做安全与故障告警,预测模型做资源预留。它的收益出现在"环境规律存在但写不成规则"的场景,风险是分布漂移、样本成本与不可解释。
前面七章的所有机制都是人写规则:权重怎么定、阈值怎么选、什么时候换路。工程师的痛苦在于,这些规则在环境 A 调得很好,搬到环境 B 就要重新调——因为环境的规律写不进 if-else。机器学习的入场券正是这个:让节点从自己的经验里把规律学出来。但学习不是银弹,它有自己的失败模式,这一节把收益与风险放在同一张桌上讲。
强化学习路由:把选路变成试错
把路由建模成强化学习问题:状态是(当前节点、邻居链路质量、队列深度、目的方向),动作是"选哪个下一跳",奖励是投递成功加低时延的组合。节点维护一张 Q 值表(每个状态动作对记一个分数),每次转发都是一次试验——按大概率选当前最优动作(利用),按小概率试试别的(探索);转发成功拿到奖励就上调该动作的分数,失败就下调。经典 Q 学习的更新公式用一句话说清:新分数等于旧分数加学习率乘以(本次回报加未来最大回报减旧分数)。
# 路由 Q 学习的极简骨架(示意) Q = {} # (节点, 下一跳邻居) -> 分数 alpha, gamma = 0.5, 0.8 # 学习率 折扣因子 def choose_next(node, neighbors): if random.random() < 0.1: # 探索 return random.choice(neighbors) scores = [Q.get((node, nb), 0.0) for nb in neighbors] return neighbors[scores.index(max(scores))] # 利用 def update(node, action, reward, next_best): old = Q.get((node, action), 0.0) Q[(node, action)] = old + alpha * (reward + gamma * next_best - old) # reward 典型取法:投递成功 +1,重传 -0.3,超时 -1,高队列深度再减分
它的甜点在哪?链路质量与干扰的时空规律(早高峰某个路口方向总是差、某栋楼下午遮挡变强)写不进静态度量,但强化学习能在几百次交互后隐式掌握——有实测报告称在周期性干扰环境里,学习型路由比最短路径与静态度量路由的投递率高出一到两成。它的坑也明确:探索流量本身就是开销(试错要付学费);环境一变(新干扰源出现)Q 表全盘作废要重学(分布漂移);多智能体同时学习时互相扰动(你学的规律里包含别人的行为,别人也在变)。深度强化学习(用神经网络代替 Q 表)能处理更大的状态空间,但要算力与样本量,末端节点基本无缘——现实部署常是分层学习:骨干节点学、末端节点跟。
异常检测:把 6.1 的攻击和故障一起看
第二类应用是"看见不正常"。思路转变很有意思:6.1 的攻击检测是特征工程——每种攻击写一套规则(序列号异常、跳数不匹配);异常检测则是学"正常长什么样",凡不像正常的都报警。常用特征向量包括:节点报文速率、路由消息占比、邻居变化速率、丢包时空分布。模型从简单到复杂依次是:统计阈值(滑动窗口均值加减三倍标准差)、聚类(正常行为聚成簇,离群即异常)、自动编码器(学习压缩正常模式,重构误差大即异常)。深度学习模型还能捕捉"时序上的不正常"——比如某节点白天沉默夜里狂发,单点指标全正常、时间模式露馅。
这套方法把灰洞(6.1)这类"慢性温和"攻击从死角里捞了出来:单次行为都在合理范围,但长期统计分布与正常节点显著不同。代价是两个经典误差:误报(正常突发被当攻击,5.2 的错峰案例里那种突发就是误报高危场景)与漏报(攻击者慢慢训练模型适应边界,"温水煮青蛙")。所以工程上的第三课与 6.2 相同:异常检测输出的是"疑点"不是"判决",要接到信誉系统与人审的闭环里,不能直接联动封禁。
资源预测与联邦学习
第三类应用是预测。流量预测(下一小时的负载分布)支撑 7.2 的骨干轮换与 4.2 的睡眠调度提前量;链路质量预测(结合 4.1 的移动模型与信道历史)支撑提前换路;能量预测(结合太阳能采集的天气数据)支撑采集任务的排期。预测模型不必复杂——传感网络里线性回归与小网络往往就够了,赢在特征工程而非模型深度。
联邦学习是这些模型的"网络化训练方式":数据不出节点,各节点本地训练、只上传模型参数的更新,聚合出全局模型再下发。它与自组织网络是天生一对——数据本来就分散在各节点、且常含隐私(6.3 的位置数据)。聚合点天然落在边缘节点或骨干(8.1 的三方交易)。但联邦的学费也要看清:参数交互本身占空口(模型再大点,通信量就反客为主);参与方数据不均衡(有的节点流量大样本多,有的几乎没数据);还有投毒风险——恶意节点上传恶毒参数把全局模型带偏,防御又回到 6.2 的信誉机制(给参数更新也记信誉)。整个 AI 与安全的纠缠在这里闭环:学习系统自己也需要被信任。
一次学习型调度上线的过程
背景:园区 Mesh,业务以白天的视频回传与全天传感为主,原用固定睡眠调度(4.2 的同步周期方案),夜间空转明显。操作:上线学习型调度——各骨干节点按小时级预测本地流量,动态调整所在域的睡眠参数;模型先在仿真环境用历史数据预训练两周,再小范围灰度(两个域)两周,全网上线。结果:夜间能耗下降约三成,白天高峰无性能回退;但上线第二个月遇到园区装修,两个域的流量模式突变,预测失准导致这两域在过渡期出现采集延迟超阈值。处置:给调度加了"预测置信度检查"——置信度低时回退到保守的默认参数,等于给学习系统装了安全带。复盘:这次上线把三步走(仿真预训练、灰度、回退兜底)走全了,损失被控制在两个域两周;同类项目里跳过灰度直接全网的,故障面通常会大一个量级。变式:若是任务型网络(流量模式按任务切换而非按时间周期),预测模型的特征要从"时间"换成"任务阶段"——特征选错,模型再好也学不到点上。
学习闭环的一张图
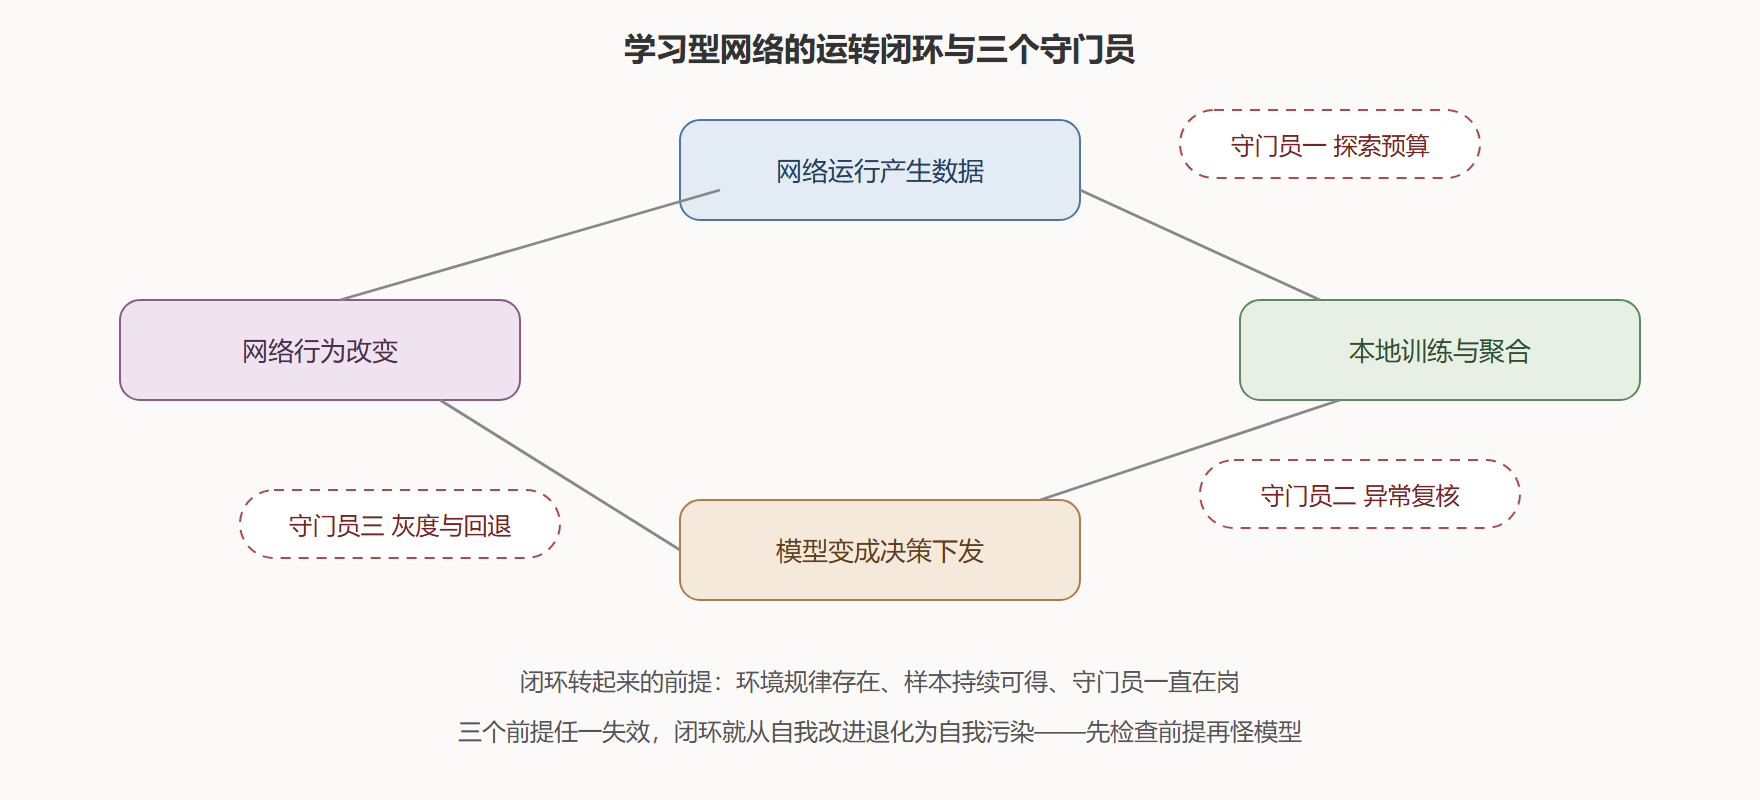
把本节三类应用放进同一个循环看:网络运行产生数据,模型从数据里学出规律,规律变成决策下回网络,网络行为改变又产生新数据——一个会自我改写的闭环。图上标出的三个守门员(探索预算、异常复核、灰度回退)就是 8.2 全部风险控制的落点。
图:网络与模型互相塑造的闭环
台词摘录
- 入场条件:规律存在但写不成规则时学习才有优势,规则能写清的场景别上模型。
- 试错有学费:探索流量是实打实的开销,收益要扣除学费再算账。
- 疑点不判决:异常检测的输出接进信誉与人审闭环,直接联动封禁必翻车。
- 分层学习:骨干学、末端跟,算力与样本的现实约束决定架构。
- 三步走上线:仿真预训练、小范围灰度、置信度回退兜底,缺一步故障面翻倍。