1.2 经典比特与量子比特:两种信息的攻防属性
1.2 经典比特与量子比特:两种信息的攻防属性
本节摘要:量子比特的状态由复数振幅对描述,测量以概率方式给出结果;单个量子比特不稀奇,稀奇的是态空间随比特数指数扩张。本节建立态矢量的最小数学工具集,用可运行代码演示测量与归一化,并算清那笔让经典模拟绝望的内存账。
先承认一个反直觉的事实
内存账可以从这个数字算起:五十个纠缠量子比特的完整状态,用现代计算机的浮点数硬存,大约需要二千万亿字节——堪比一座数据中心的一个存储机柜;三百个量子比特的态,其振幅数量超过可观测宇宙中的原子总数。而另一边,你在市面上买到的高端台式机,内存不过几十上千亿字节。这笔账不是修辞,它是本节要讲透的第一性事实:量子信息的态空间比经典信息大得多,大得让"用经典方法精确跟踪量子计算"这条路在大规模下根本走不通。理解了这一点,量子计算的全部吸引力与全部麻烦——都随之而来。
一、量子比特的数学骨架
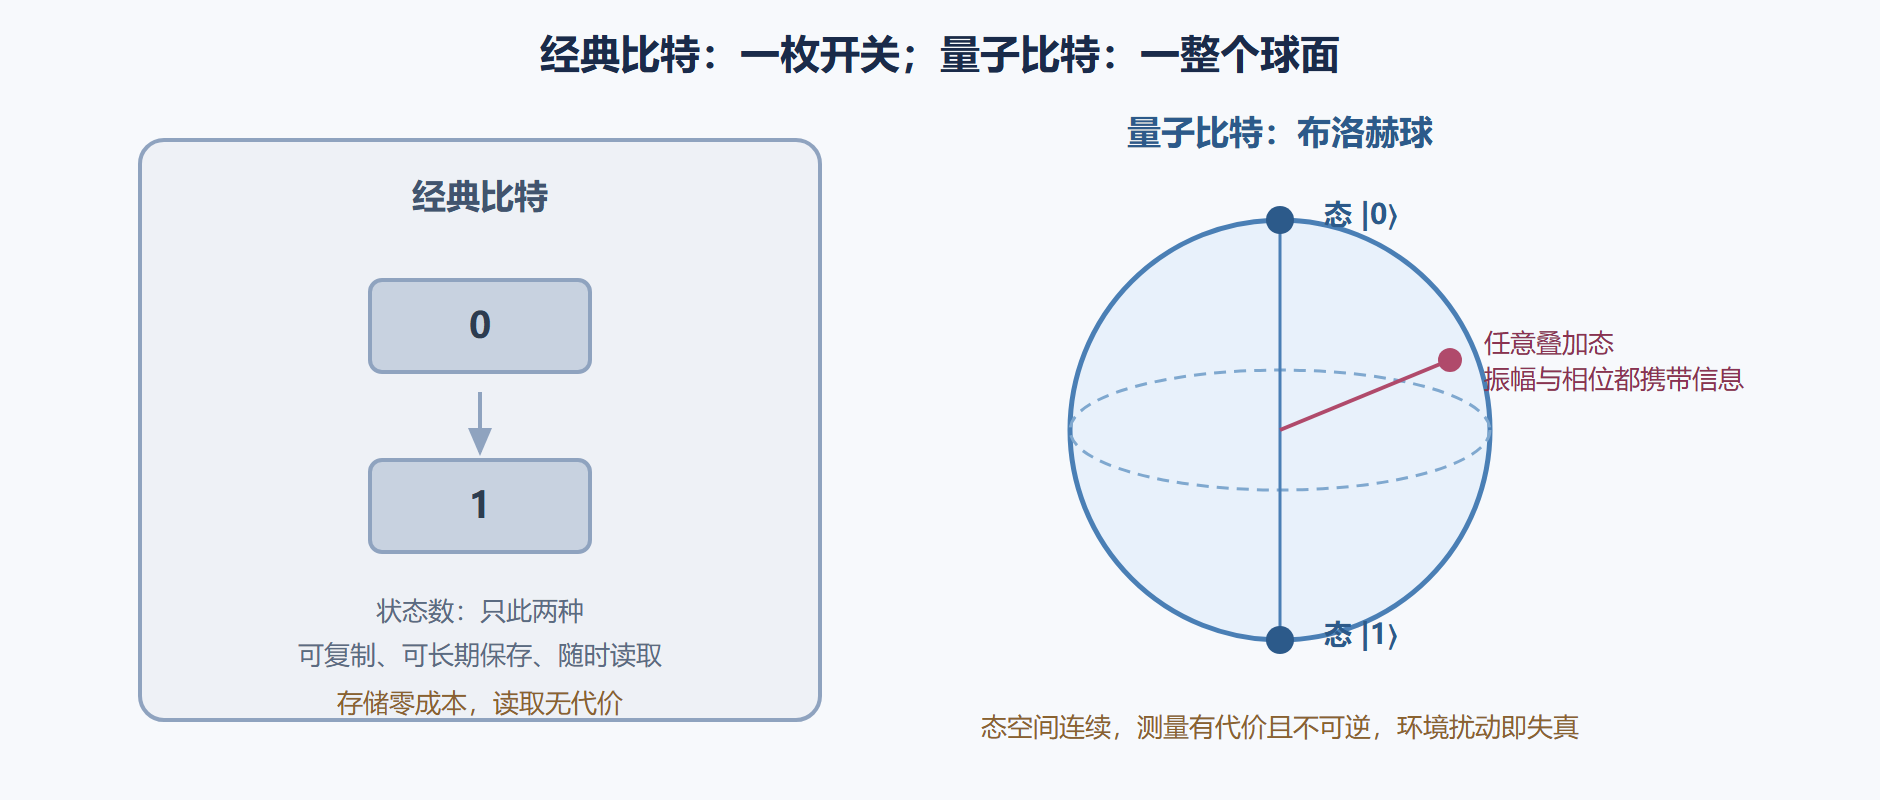
经典比特是开关:非零即一,任一时刻的状态就是一比特信息。量子比特的状态写作
其中振幅 \alpha 与 \beta 是复数,满足归一化条件 |\alpha|^2 + |\beta|^2 = 1。测量时,态以 |\alpha|^2 的概率坍缩到零、以 |\beta|^2 的概率坍缩到一,测量之后振幅信息全部丢失。
这里有三层含义值得拆开。第一层,振幅是复数:它有相位,相位差决定了两段振幅"相遇"时是相互加强还是相互抵消——这就是干涉,量子算法真正干活的手艺。第二层,测量不可逆:测量前态是连续分布的振幅对,测量后只剩经典结果,且原态被破坏,你无法"测完再看一眼"。第三层,叠加不是"又零又一"的模糊开关:|0\rangle 与 |1\rangle 是二维复向量空间里的一组基,叠加是它们张成的整个平面上的任意方向——把态画在所谓布洛赫球上,北极是零、南极是一,赤道上任意一点都是等权叠加态,球面上每一条经线对应一种相位。
图 1-2:经典比特与量子比特的属性对照
二、演练:亲手实现态矢量与测量
抽象公式在手边跑一遍才踏实。下面用纯 Python 实现最小的量子态工具:复振幅向量、归一化校验、按概率采样测量。二十几行代码,后面所有章节的模拟器都在它之上生长。
# qubit_min.py:最小量子态工具(仅用标准库 random 与 math) import math, random class Qubit: """单个量子比特:振幅对 [alpha, beta],约定基序 [0, 1]。""" def __init__(self, alpha: complex, beta: complex): norm = abs(alpha)**2 + abs(beta)**2 if abs(norm - 1.0) > 1e-9: raise ValueError(f"振幅未归一化,模方之和 = {norm}") self.amps = [complex(alpha), complex(beta)] def probabilities(self): return [abs(a)**2 for a in self.amps] def measure(self, rng=random): """按玻恩规则采样,返回 0 或 1,并把态坍缩到对应基矢。""" p0, p1 = self.probabilities() outcome = 0 if rng.random() < p0 else 1 self.amps = [complex(1 if outcome == 0 else 0), complex(0 if outcome == 0 else 1)] return outcome # 演练 1:等权叠加态(哈达玛门作用在 |0> 上的结果) plus = Qubit(1/math.sqrt(2), 1/math.sqrt(2)) print("plus 态测量概率:", plus.probabilities()) # 约 [0.5, 0.5] # 演练 2:批量采样应逼近理论概率 rng = random.Random(42) counts = {0: 0, 1: 0} for _ in range(100000): q = Qubit(1/math.sqrt(2), 1/math.sqrt(2)) counts[q.measure(rng)] += 1 print("十万次采样:", counts) # 约各五万次 # 演练 3:相位不可见性——两次测量分布完全相同 q1 = Qubit(1/math.sqrt(2), 1/math.sqrt(2)) q2 = Qubit(1/math.sqrt(2), -1/math.sqrt(2)) # 相位差 180 度 print("q1 概率:", q1.probabilities(), " q2 概率:", q2.probabilities())
第三个演练藏着本节最重要的坑:直接在计算基下测量,|+\rangle 与 |-\rangle 的统计分布一模一样,相位信息完全隐形。但这两个态并不等价——在别的基下(比如把态旋转四十五度再测)它们的分布恰好相反。量子算法正是通过幺正变换"换基",把藏在意欲求解的问题答案里的相位差,搬到测量能看见的地方。第 5 章讲肖尔算法时你会看到这套手艺的完整应用。另一个易错点是归一化校验:浮点振幅经过成百上千次门操作会累积数值误差,真实模拟器都要周期性地重新归一化,否则概率和悄悄漂移,测量分布整体失真。
三、指数扩张的态空间:力量的来源与模拟的绝境
单个量子比特只是布洛赫球上一个点,谈不上算力。力量来自组合:两个量子比特的态是四维复向量,十个是一千零二十四维,照此每加一个比特维度翻倍。数学上写作 2^n:n 个量子比特的完备描述需要 2^n 个复振幅。纠缠态——比如振幅只在 |00\rangle 与 |11\rangle 上非零的贝尔态——无法拆成两个单比特态的乘积,描述必须整体进行,指数账单无法分期。
| 属性 | 经典比特 | 量子比特 |
|---|---|---|
| 状态空间 | 两态之一 | 二维复空间任意方向 |
| 复制 | 可以(存储、备份) | 禁止(不可克隆定理,详见 2.2 节) |
| 读取 | 无损,任意次 | 有损,通常一次机会 |
| 多比特描述代价 | n 比特即 n 个开关态 | 需要 2^n 个复振幅 |
| 失效方式 | 电压越限、位翻转 | 退相干:相位与振幅被环境侵蚀 |
| 纠错方式 | 拷贝比对即可 | 需要纠缠编码与伴随式测量 |
对照表里两行是重点。描述代价一行解释了为什么经典模拟有天花板:普通工作站到三十比特上下就撞上内存墙,超级计算机借助分布式内存也只能把这条边界推到五十比特附近(这正是第 5 章模拟器代码的用武之地与边界)。失效方式一行预告了全书敌人的形态:经典设备的出错是离散的、显性的,量子设备的"出错"是连续的、隐性的——态不会突然归零,而是相干性一点点流失,像墨滴在水里晕开。这种连续性正是第 2 章要用密度矩阵精确刻画的。
四、防御视角的定位
到这里,本章开头第二问的答案已经成形:量子信息值得建一整套技术体系,是因为它的态空间指数大——大到某些计算可以借道而行;它的麻烦也来自同一处——态空间越大越精妙,被环境污染的方式越多。强与脆同源,这是量子信息与经典信息最本质的分野。下一节我们把这个定性判断升级成定量地图:具体哪些计算问题站在量子优势的防区之内,哪些问题根本不值得动用量子机器。
本节要点回顾
- 态矢量三要素:复振幅、归一化、玻恩规则测量,二十行代码可完整实现。
- 相位是隐形资产:计算基测量看不见相位,量子算法靠换基把相位差搬运到可测量的地方。
- 态空间指数扩张:2^n 维振幅既是量子加速的源头,也是经典模拟的绝境,五十比特是台式机模拟的实用边界。
- 纠缠不可分期:纠缠态无法拆成单比特乘积,描述代价无法压缩,这是与经典概率最深的分界。
- 失效是连续的:量子错误不是开关跳变而是相干性渐失,这决定了第 2 章以后的所有防御工具的形态。