5.2 变分算法 VQE 与 QAOA:NISQ 时代的游击战术
5.2 变分算法 VQE 与 QAOA:NISQ 时代的游击战术
本节摘要:变分算法把计算拆成两半——量子设备只负责"按参数准备态并采样",经典优化器负责"改参数",循环往复逼近目标。浅线路加经典闭环,恰好绕开噪声时代设备的两大短板(深度不够、不能纠错)。本节完整跑通一个可运行的变分循环,并如实呈现采样噪声带来的全部麻烦。
一个被催促的项目经理
把镜头对准某化工公司的量子项目例会。算法负责人汇报:"我们的设备每秒能跑两千个线路,但每个线路深度不能超过二十,错误率千分之三。"项目经理追问:"那化学模拟要的百万门深度怎么办?"答案就藏在变分策略这个战术里:不追求一次算完,而是把问题改造成"准备一个带参数的试探态、测一个能量、让经典算法猜下一组参数"的循环——每一轮量子设备只出浅线路,数学上的重活交给经典计算机。游击战的要义正是如此:不与敌人的主力(深度需求)正面交锋,用无数次小规模遭遇战(浅线路采样)累积战果。本节就把这场游击战从原理到代码完整过一遍。
一、VQE:把基态能量变成参数寻优
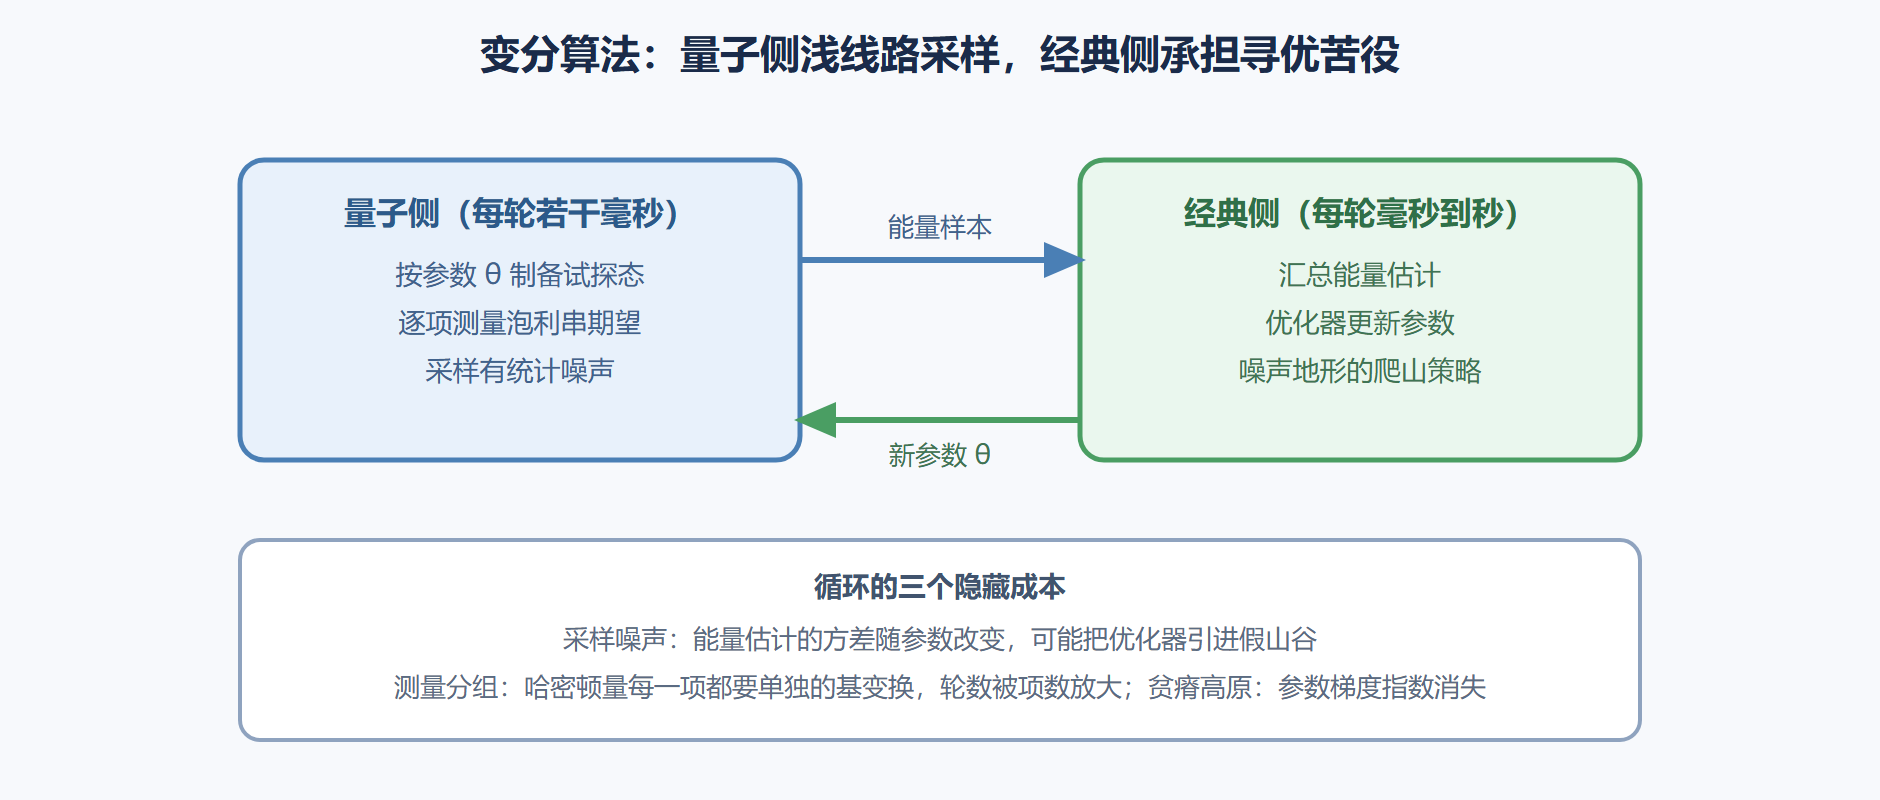
变分本征求解器的数学底座是变分原理:任意试探态的能量期望不会低于真实基态能量,于是"求基态"化归为"调参数让期望能量最小"。流程四步:选定拟设(一个参数化线路,比如单比特上的一串旋转门);制备试探态并测量哈密顿量各项的期望值(哈密顿量拆成泡利串之和,逐项测量后加权);把测得的能量交给经典优化器;优化器吐出新参数,回到制备。量子侧永远只干"浅线路加采样",寻优的苦役全在经典侧——这个分工是整套战术的灵魂。
QAOA 是同一思想在组合优化上的变体:把目标函数编码成"代价哈密顿量",线路由代价层与混合层交替叠成,层数与角度就是待调参数。两者对比一目了然:
| 维度 | VQE | QAOA |
|---|---|---|
| 目标问题 | 基态能量(化学、材料) | 组合优化近似解(MaxCut、调度) |
| 拟设来源 | 化学直觉构造(UCC 类)或硬件高效型 | 问题结构给定(代价与混合层交替) |
| 参数语义 | 无直接物理含义 | 层数与角度对应绝热演化的离散化 |
| 理论保证 | 变分上界,靠拟设表达力 | 深度足够时逼近绝热最优 |
| 主要敌人 | 采样噪声、贫瘠高原 | 角度寻优的非凸地形 |
图 5-2:变分循环——量子与经典的分工闭环
二、演练:完整跑通一个变分循环
演示问题刻意取最小:单比特哈密顿量 H = 0.8 Z + 0.6 X,精确基态能量为负一(解析可算),拟设只用一个旋转角。麻雀虽小,采样噪声、由粗到细的寻优、与精确值对账,一个不少。
# vqe.py:最小变分算法循环(仅标准库) import math, random def prepare(theta): """拟设:Ry(theta) 作用在 |0> 上,返回振幅对 (a, b)。""" return complex(math.cos(theta / 2)), complex(math.sin(theta / 2)) def sample_energy(theta, a, b, shots, rng): """Z 基与 X 基各采样 shots 次,估计 a*Z + b*X 的期望(带统计噪声)。""" a0, a1 = prepare(theta) pz0 = abs(a0) ** 2 ez = sum(1 if rng.random() < pz0 else -1 for _ in range(shots)) / shots px0 = abs((a0 + a1) / math.sqrt(2)) ** 2 # X 基:哈达玛后测 Z ex = sum(1 if rng.random() < px0 else -1 for _ in range(shots)) / shots return a * ez + b * ex def vqe(shots, rng, sweeps=4, coarse=0.3): """由粗到细的模式搜索:噪声目标下的朴素但稳健的爬山。""" theta, best = 0.0, float("inf") for sweep in range(sweeps): step = coarse / (2 ** sweep) improved = True while improved: improved = False for cand in (theta - step, theta + step): c = cand % (2 * math.pi) e = sample_energy(c, a, b, shots, rng) if e < best - 1e-12: best, theta, improved = e, c, True return theta, best a, b = 0.8, 0.6 exact = -math.hypot(a, b) print(f"精确基态能量 {exact:+.4f}") for shots in [50, 500, 5000]: rng = random.Random(9) th, e = vqe(shots, rng) print(f"每轮采样 {shots:>5} -> 估计 {e:+.4f},theta = {th:.3f}")
输出里能读出四层战术结论。第一,采样越多估计越准:五千采样的能量偏离精确值不足百分之一,五十采样则差出近一成——这是游击战的弹药账:方差按采样数的平方根收敛,精度每翻一倍、弹药要翻四倍。第二,噪声地形会把朴素优化器引进假山谷:五十采样那档的参数停在与最优相差零点七弧度的位置,还自认为收益已经收敛;工业界的对策要么加大采样,要么换用对噪声鲁棒的优化器(如同时扰动随机逼近)。第三,留意五百采样那档的估计居然低于精确基态(负一点零三八对负一点零零零)——变分原理的"永不低于"只在期望严格精确时成立,采样噪声会把它捅出破口,实战里这个"破底"现象反而是诊断噪声水平的常用线索。第四,分组测量的代价已在最小例子显形:两味泡利串就要两套基各采一遍,真实化学问题的哈密顿量动辄上千项,分组与合并测量是变分算法工程化最重的一块。
三、易错点与适用边界
三条边界值得刻在案头。其一,贫瘠高原:拟设的参数一多,能量期望对参数的梯度会指数式趋平,经典优化器在平地上瞎走——缓解靠问题启发的拟设(把化学结构或图结构编进线路),而不是无脑加参数。其二,采样噪声不是设备错误率,两者会叠加:本节的模拟里设备是完美的,噪声全部来自蒙特卡洛;上真机后,门错误与读出误差再叠一层,所以 5.3 节的误差缓解是变分算法的标准前置工序。其三,变分算法的战果至今是"演示级":它在小分子与几十节点的图上证明了自己能跑,但"跑赢最佳经典算法"仍未在小规模之外被严肃证实——把它当成长期能力投资,而非短期业绩承诺,是与这个领域打交道的健康姿势。
本节要点回顾
- 变分原理换战场:求基态化归为参数寻优,量子侧只出浅线路,深度劣势被结构性地绕开。
- VQE 与 QAOA 同宗:前者打化学基态,后者打组合优化,参数语义与理论保证各有侧重。
- 采样是弹药账:精度翻倍采样翻四倍,测量分组会放大轮数,两项成本都要列入预算。
- 噪声地形会骗人:假山谷与贫瘠高原是寻优的两大暗礁,靠鲁棒优化器与问题启发拟设应对。
- 战果定位要诚实:演示级能跑与规模级能赢之间还隔着整个容错时代。
下一节处理后勤:编译器怎么把线路改短,误差缓解怎么把已发生的污染从统计里估出来。