3.4 多组学整合:把证据链拧成一股绳
3.4 多组学整合:把证据链拧成一股绳
本节摘要:单路证据各有偏差,整合才有力量。本节讲两种整合思路——因子模型(MOFA、iCluster 一族)怎么把多组学压成共同变化的暗因子,加权证据框架怎么把异质证据折算成可比分数,并给出可运行的整合演算。代谢组与表观组两类补充取证也在本节并入。它是第 3 章的收口站:产出一张交给第 4 章排序的加权证据表。
前三节各采一路证据,本节把它们拧起来。整合的位置放在取证章的末尾是有讲究的:整合不产生新证据,它只决定旧证据怎么合在一起说话——合得对,三路证据互相补强;合得糙,等于把三种偏差加权平均成一种更大的偏差。
拼图规则
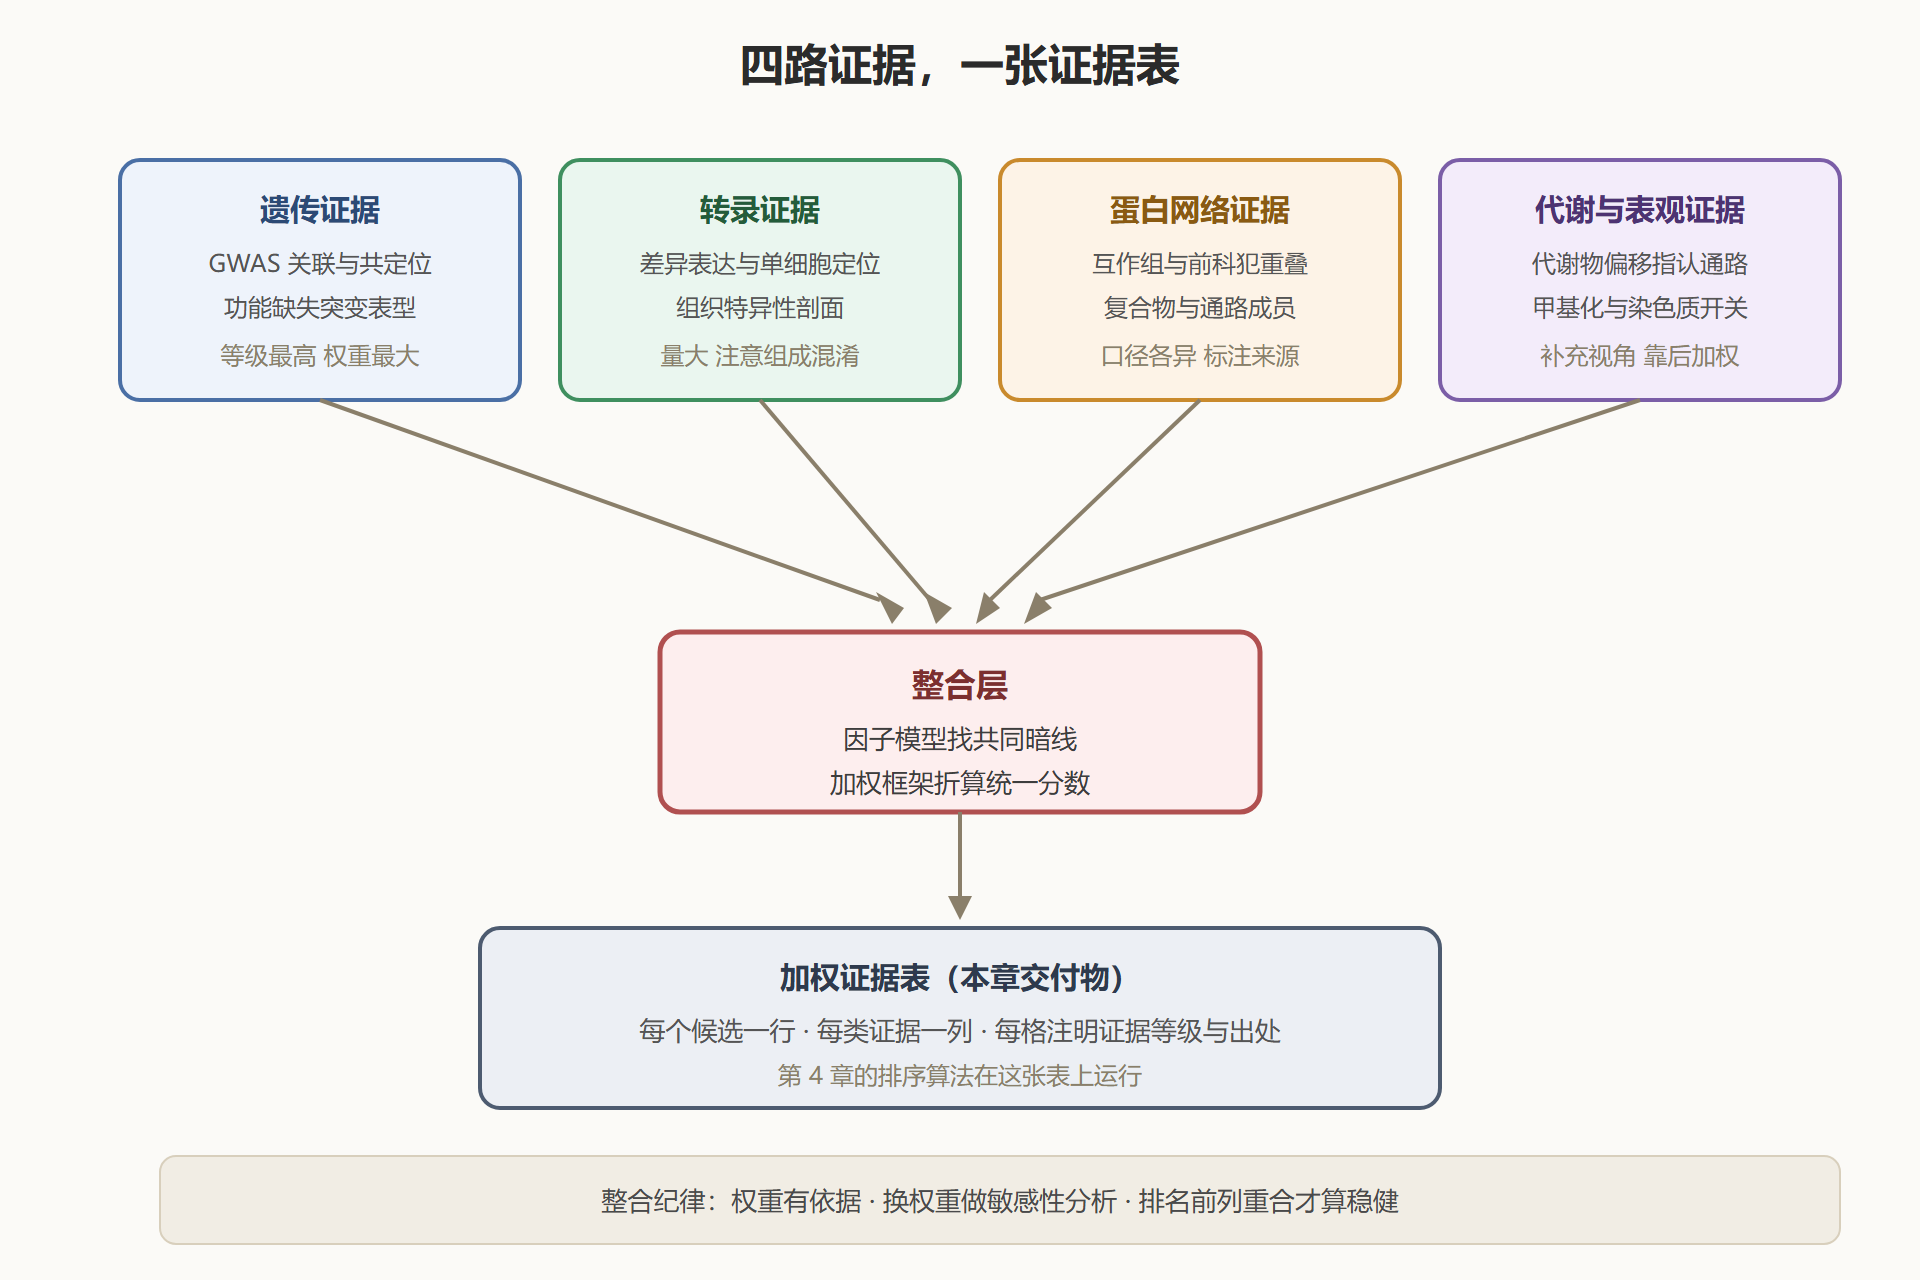
整合要回答两个问题:证据之间是否指向同一批分子(一致性),各路证据各值多少分(权重)。两条技术路线对应这两个问题。
路线一:因子模型找暗线。 MOFA、iCluster 这类多组学因子模型把基因、转录、蛋白、代谢几层数据放在一起,寻找"同时在多层上变化"的潜在因子。直觉是:如果某批分子在遗传上受同一批变异驱动、转录上协同升降、蛋白上同步增减,那么多组学数据就存在一个共同的"暗因子"。因子模型把这个暗线显式地压出来,每个样本在暗因子上的坐标可用于分型,每个基因在暗因子上的载荷用于衡量它与暗线的绑定程度。整合由此变成"找共同结构",而不是简单的表拼接。
代价也要说清:因子模型丢信息换可读性,载荷大的分子不一定是靶标(可能只是细胞组成变化的影子);因子数量的选择带主观性;结果的可解释性依赖事后的人工标注。把它当"发现共同结构的显微镜",别当"证据裁决器"。
路线二:加权框架折算分数。 Open Targets 这类证据整合平台走的是另一条路:把每类证据按统一口径折算成分数(遗传证据、组学证据、文献证据、药物证据、动物模型证据各占一路),再按预设权重合成为靶标-疾病关联总分。它回答的是"所有证据合起来值多少",适合做嫌疑排序的地基——第 4 章的打分排序就建立在这类分数上。
加权框架的命门在权重设定:权重本质是主观先验,设错方向整盘皆输。两条纪律:权重设定要有依据(比如遗传证据权重高于文献共现,因为前者不可被引用网络扭曲);要做敏感性分析——换一套合理权重重算一遍,排名前列的分子若大体重合,结论才稳健。
图 3-3:多组学证据的分层整合
补充取证:代谢组与表观组
代谢组测的是小分子代谢物的全景偏移,它离表型最近——基因与蛋白再怎么折腾,最终都要通过代谢活动兑现成表型。取证价值体现在两端:一是通路指认,一组代谢物协同偏移能直接点名被扰乱的反应步骤,比转录读数更靠近功能;二是患者分层,代谢读数便宜、可重复测量,适合做纵向随访与分型。局限是鉴定覆盖率低、浓度受饮食与昼夜节律扰动大,样本收集规范比统计方法更决定质量。
表观组测染色质层面谁来谁走:DNA 甲基化、组蛋白修饰、染色质可及性。它补的是转录证据解释不了的"为什么"——同样的基因组,哪个开关被打开了、被谁按住的。疾病关联变异落在染色质开关区时(大多数 GWAS 位点的宿命),表观图谱是给街区找门牌的主力工具之一,与 3.1 的 eQTL 路线互为补充。
把整合跑起来
下面这个演算把四路证据折成一张加权证据表,附敏感性分析——它是第 4 章排序的地基,值得亲手跑一遍再改权重观察排名变化。
# 加权证据整合:四路证据 -> 总分 + 敏感性分析 candidates = { # 遗传 转录 网络 代谢表观 (各路 0-1 分) "MUC5B": [0.95, 0.90, 0.55, 0.30], "TGFB1": [0.60, 0.85, 0.90, 0.70], "LOX": [0.40, 0.75, 0.80, 0.55], "CXCL8": [0.10, 0.45, 0.35, 0.20], "WNT2": [0.25, 0.70, 0.60, 0.40], } w_main = [0.40, 0.25, 0.25, 0.10] # 主权重:遗传优先 w_alt = [0.20, 0.35, 0.35, 0.10] # 敏感性备选:机制证据抬升 def rank(weights): scored = {k: round(sum(v*w for v, w in zip(vals, weights)), 3) for k, vals in candidates.items()} return sorted(scored.items(), key=lambda kv: -kv[1]), scored top_main, _ = rank(w_main) top_alt, score_alt = rank(w_alt) print("主权重排序:") for k, s in top_main: print(f" {k:<8} {s}") print("敏感性备选权重排序:") for k, s in top_alt: print(f" {k:<8} {s}") stable = {k for k, _ in top_main[:3]} & {k for k, _ in top_alt[:3]} print("两套权重下都进前列(稳健候选):", sorted(stable)) # 解读:MUC5B 遗传证据过硬,两套权重都稳居前列——稳健候选; # TGFB1 在机制权重下上升,提示它属于"证据靠网络与功能"的类型, # 立项文书中应把两类候选分开叙述,不混一张榜单。
易错点:把整合当仲裁
最后强调本章开头那句话的反面:整合不产生新证据,它是证据的组织方式。两个候选总分接近时,正确动作不是比总分小数点,而是回到证据类型看差异——一个靠遗传、一个靠转录,级别完全不同(3.1 的教训)。任何整合分数体系里,遗传证据的缺位都无法被组学证据的堆量填平。
💡 关键直觉:证据表按"证据等级 × 一致性"排序,不按"数据量 × p 值"排序。表做得诚实,第 4 章的算法才有地基。
整合的常见疑问
因子模型的"暗因子"怎么解释?
解释靠载荷审计:看哪些基因、蛋白、代谢物在因子上的载荷最高,再问这批分子有什么共同点——常浮现出细胞周期、免疫浸润、基质活化一类的"程序"标签。要警惕的是把因子直接当生物学实体:暗因子是统计结构,可能与真实程序对齐,也可能只是技术偏差的混合(批次效应就常常贡献一整个因子)。所以因子模型的标配动作是:把因子与技术协变量相关一遍,与技术强相关的因子直接剔除,剩下的才进生物学解读。
证据之间打架怎么办?
先别急着加权,先查打架的原因。转录说高、蛋白说低——最常见的解释是翻译后调控或蛋白降解加速,这本身是机制信息;遗传说有关、转录说无关——提示调控发生在蛋白活性层而非表达层。证据冲突的正确处理是升一层解读(问为什么冲突),而不是平均掉冲突(加权框架会把冲突折算成中庸分数,恰恰丢掉了最有信息量的信号)。立项文书里,证据冲突的案例甚至比一致案例更值得写。
整合表的证据等级怎么标?
用两轴标注:证据类型(遗传、转录、蛋白、代谢表观)乘以证据等级(人群因果、人群关联、体外、预测)。每一格注明数据来源与版本,跨格的综合结论只写"一致性"不写"因果性"——因果这个词留给人群功能缺失突变与验证实验。一张诚实标注的整合表,是下一章所有算法的地基;地基里混进的任何高估,都会被排序算法放大成假榜单。
整合表的复检清单
证据表合卷前过一遍五问:每行的证据类型是否标注了来源与版本?等级标签(人群因果到计算预测)是否完整?冲突证据是否保留并解释,而不是被加权抹平?冷门高分候选是否带着"证据少但无反证"的标签?表头是否写明权重方案与敏感性分析结果?五问全过,这张表才配交给第 4 章;任何一问含糊,排序环节都会把含糊放大成榜单上的一批假名次。
顺带交代整合表的迭代纪律:证据表是活的,每季度或每个里程碑刷新一次版本,刷新时旧表存档、新增行注明追加理由、被推翻的行不删除而是标"降级"并留一行原因。靶标发现周期以年计,一张只有当前态、没有演化史的证据表,在复盘时几乎无法回答"当时为什么这么排"。
办案手记(要点回顾)
- 整合回答一致性与权重两问,对应因子模型与加权框架两条技术路线;
- 因子模型是发现共同结构的显微镜,不是证据裁决器;
- 加权框架的命门在权重设定,敏感性分析是必做的稳健性检查;
- 代谢组离表型最近、表观组解释开关来源,都是补充视角而非主证;
- 整合分数不能掩盖证据类型差异,遗传缺位无法用组学堆量填平;
- 本章交付加权证据表,下一站第 4 章:让算法在表上排出嫌疑榜。