4.3 图神经网络与优先级排序
4.3 图神经网络与优先级排序
本节摘要:图谱立起来之后,排序的主流工具是图神经网络——节点带特征、边带类型、消息沿边传播,每个候选最终得到疾病相关性分数。本节讲消息传递的直觉与一段可运行的网络传播演算,把药物-靶标相互作用预测并入同一框架,重点交代防泄漏评估与可解释性审计。它是推理章的收口:交付可复核的嫌疑榜。
4.1 的打分器逐个看候选,4.2 的图谱推理逐条走路径,本节的图神经网络把整张网一起看:一个候选的分数由它自己、它的邻居、邻居的邻居共同决定。本节是推理章的最后一站,产出要经得起"分数从哪来"的追问。
让网络自己说话
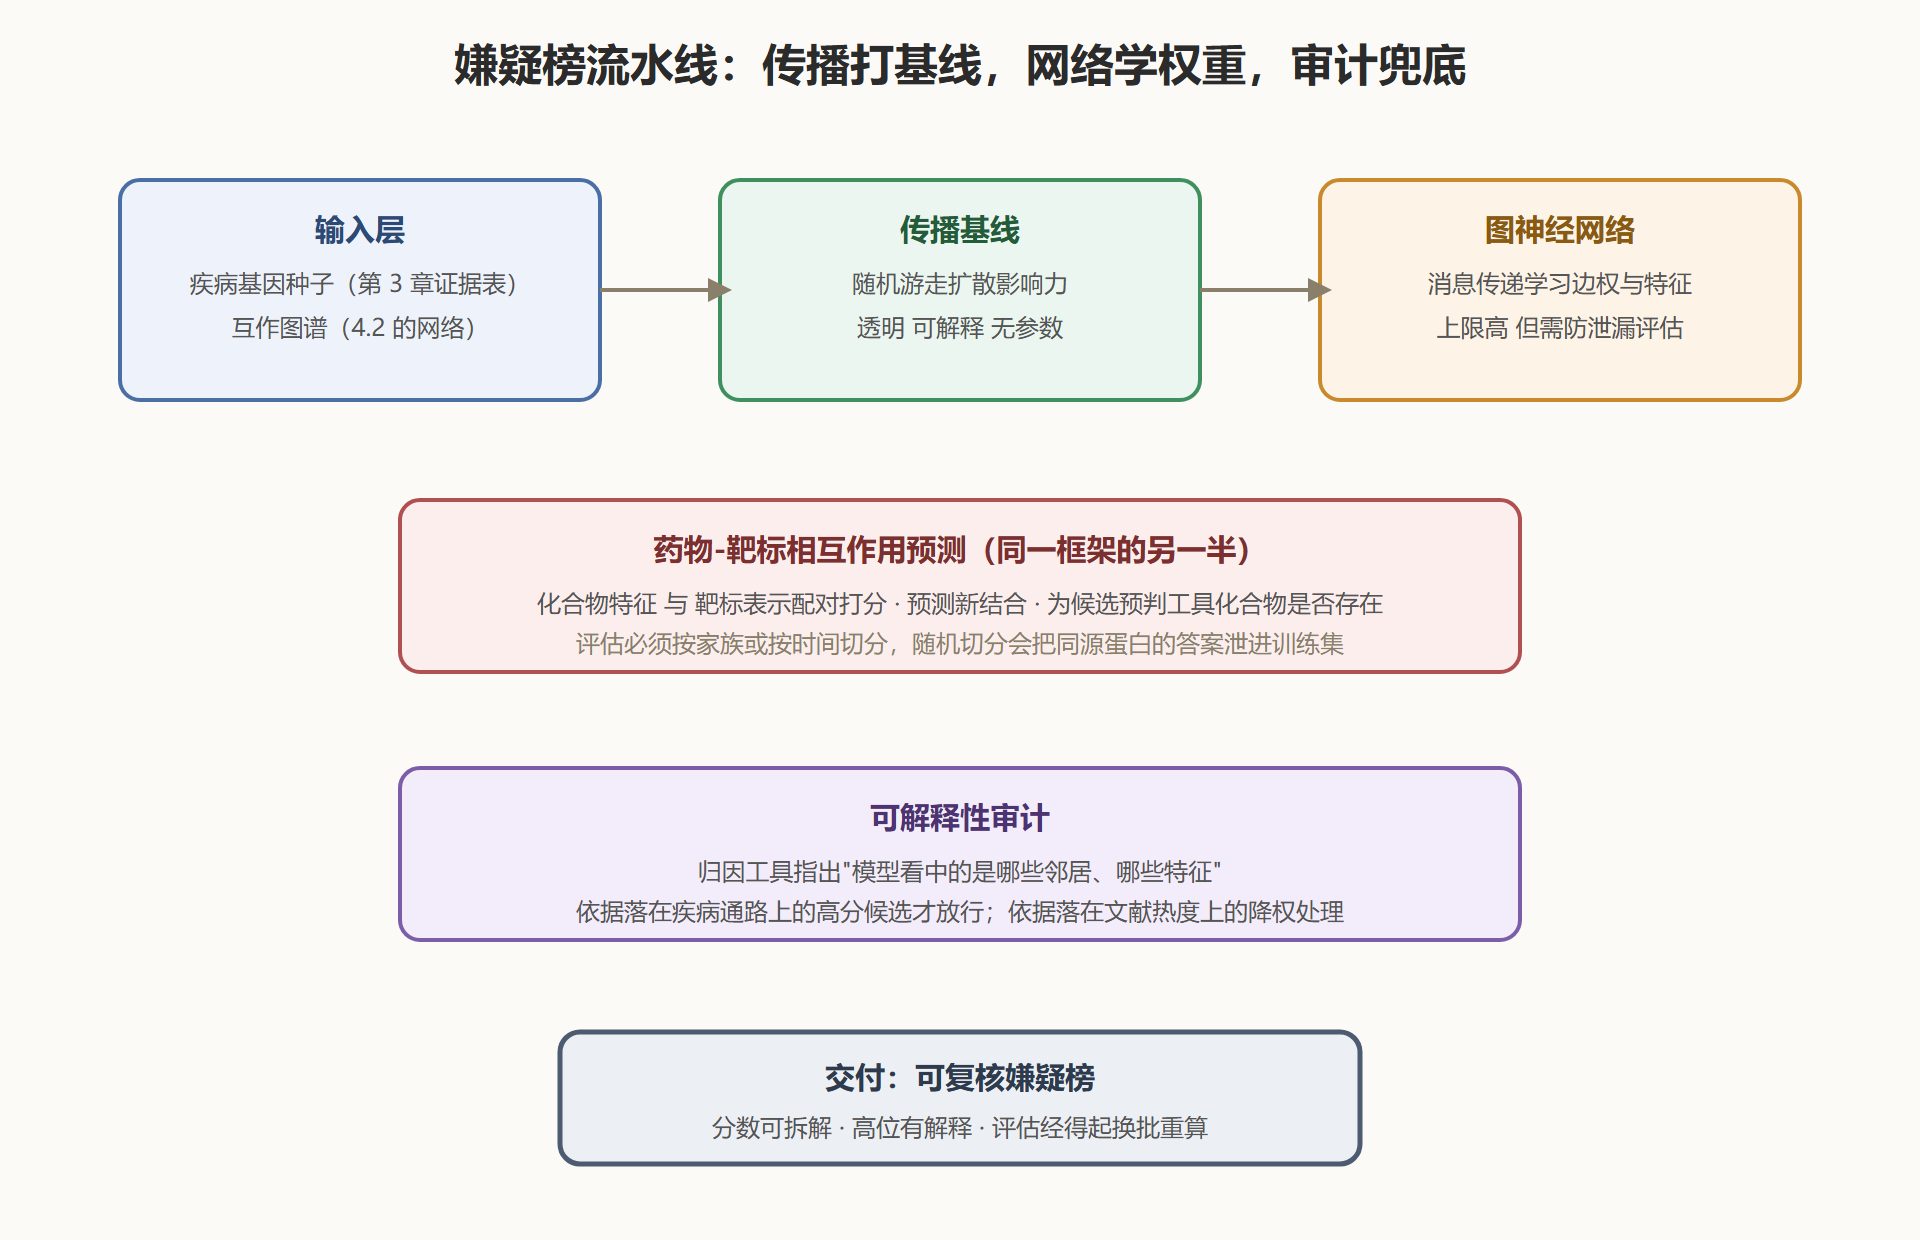
消息传递的直觉一句话能说完:每个节点反复收集邻居的信息、更新自己的表示。跑若干轮之后,节点的表示里就揉进了它在网络中的位置、邻域的构成、乃至二跳三跳外的结构信号。用这个表示去预测"该节点与疾病的关联",就是图神经网络版的靶标优先级排序。相比 4.2 的显式路径推理,它的进步在于:不用人工指定"走哪条路算相关",路径的权重由模型从训练数据里学出来;代价是黑箱程度上升——这正是本节必须配上可解释性审计的原因。
消息传递有个朴素的前身值得先跑一遍:网络传播(标签传播、带重启的随机游走一族)。它的逻辑是"从疾病节点出发,让影响力沿着边扩散,扩散到谁头上谁嫌疑大"。下面的演算实现带重启随机游走的玩具版——它至今仍是许多靶标优先级排序系统的基线,也是理解图神经网络的台阶。
# 带重启随机游走:网络传播做靶标优先级排序(图神经网络的朴素基线) from collections import defaultdict edges = [ ("疾病", "MUC5B"), ("疾病", "TGFB1"), ("疾病", "PDGFRA"), ("MUC5B", "WNT2"), ("TGFB1", "LOX"), ("PDGFRA", "LOX"), ("LOX", "HIF1A"), ("WNT2", "RSPO2"), ("HIF1A", "VEGFA"), ("VEGFA", "PDGFRA"), ("疾病", "COL1A1"), ("COL1A1", "LOX"), ] adj = defaultdict(list) for a, b in edges: adj[a].append(b); adj[b].append(a) nodes = list(adj) idx = {n: i for i, n in enumerate(nodes)} n = len(nodes) # 列归一化转移概率 trans = [[0.0] * n for _ in range(n)] for a in nodes: for b in adj[a]: trans[idx[a]][idx[b]] = 1.0 / len(adj[a]) seed = [0.0] * n seed[idx["疾病"]] = 1.0 # 从疾病节点出发 RESTART, STEPS = 0.15, 30 p = seed[:] for _ in range(STEPS): p = [(1 - RESTART) * sum(p[idx[a]] * trans[idx[a]][idx[b]] for a in nodes) + RESTART * seed[idx[b]] for b in nodes] # 已知疾病基因是种子已给分,排序看"新面孔"里谁承接的传播量最大 ranked = sorted(((nodes[i], round(p[i], 4)) for i in range(n) if nodes[i] != "疾病"), key=lambda x: -x[1]) print("传播排序(新面孔优先):") for name, score in ranked[:8]: print(f" {name:<8} {score}") # 解读:LOX 与 PDGFRA 承接的传播量领先——它们多重连接到已知的 # 疾病基因 neighborhood,正是"同案犯网络"的数值化表达。
图 4-2:从传播基线到图神经网络的排序流水线
同一框架的另一半:药物-靶标相互作用预测
排序回答"谁嫌疑大",还有一个对称问题:哪个化合物可能作用于它——药物-靶标相互作用(DTI)预测。它决定收网方案的可行性:一个排名靠前的候选若在化学库里找不到任何可用的工具化合物,收网就要先"造武器",项目周期完全不同。
DTI 预测与靶标排序共用图框架:把化合物与蛋白放进同一张图,"结合"关系是一种边类型,模型预测缺失的边。经典特征包括化合物的分子指纹、靶标的结构域、以及两类实体的已知关系网络。这一任务有一个专属的免费资源可以交叉利用:ChEMBL 一类化学档案里的活性测量就是天然的带标注边——哪个分子对哪个靶标在多少浓度下起效,全是现成的训练材料。它的陷阱也最出名:按"随机边"切分评估集时,同一蛋白家族的结合模式会同时出现在训练与测试两侧,模型背下"这一族激酶都结合这类分子"就能拿到虚高指标。所以本领域的评估铁律是按蛋白家族切分或按时间切分:训练时根本没见过该家族的任何成员,测试时还能预测对,才算真本事。
审计:让模型交出"为什么"
黑箱排序不能直接送进收网。可解释性工具(梯度归因、注意力检查、子图提取一族)能把单个候选的高分拆解成证据构成:模型看中的是它连着疾病节点的哪些邻居、它的哪些特征(保守性?表达广度?)贡献了分数。审计时的两条判读线:
- 生物学合理性线:归因依据落在疾病通路成员、遗传证据基因上——高分可信,放行;
- 热度偏差线:归因依据落在"文献多的节点""注释全的节点"上——这是 4.1 提过的出名度偏差换了一身算法外衣,降权或剔除后重算。
审计产出的清单直接决定嫌疑榜的可信分层:榜首候选必须人人有合理性归因;归因不清的高位候选,宁可降到"待审计"也不送收网——黑箱分数造成的错误侦查方向,比没有分数更浪费警力。
易错点:指标漂亮不等于模型会看病
把本章的评估观收拢成一段话:排序任务的评估指标(早期精度、命中召回一族)只对评估集负责。评估集若与训练集共享同源蛋白、共享文献来源、共享时间窗,指标衡量的就是"记忆重现率",不是"发现能力"。三条纪律对应三种泄漏:同源泄漏用家族切分堵;来源泄漏用证据类型分层堵(训练只用某几类证据,测试看能否泛化到没见过的证据类型);时间泄漏用时间切分堵(用过去的知识预测之后才确认的关联)。评估方案写进项目文档的分量,应当与模型结构本身等重。
⚠️ 常见坑:跨项目复用模型时沿用原项目的评估指标。不同疾病的正例规模、证据结构、家族分布差异巨大,原项目的"高分"在新项目里可能毫无参照意义。
从基线到神经网络的常见疑问
图神经网络比传播方法好在哪,什么时候不值得上?
好在前沿处的权重学习能力:传播方法对所有边一视同仁(或人工定权),图神经网络能从标注数据里学出"哪些类型的边、哪些方向的传播更可信",在边类型异质的图上(互作、共表达、通路归属混在一起)优势明显。不值得上的场景同样明确:标注样本少(已知疾病基因只有几十个时学不出可靠权重)、图质量差(噪声边比真边多时,学权重等于学噪声)、以及解释要求极高的场合。务实的路线图永远是:先跑传播基线,图神经网络只在能显著打败基线时上场——打不赢就留在基线,省下的复杂度全是可解释性。
排序结果怎么向非技术评审交代?
用"可复核三件套"交代:分数拆解(这个候选的分来自哪几类证据、各占多少)、邻域解释(它连着哪些已知疾病基因、传播路径的形状是什么)、对比锚点(它与已获批药物靶标的分数位置关系)。评审不信任的不是算法,是不可问询的算法——三件套让每个分数都能被质询,这份可质询性本身就是排序结果的一部分。
模型每天在更新,榜单要跟着换吗?
要控制换榜频率。排序结果对图版本、数据库版本、模型版本都敏感,任一更新都可能让名次小幅抖动——如果侦查资源跟着名次抖动分配,下游实验会陷入永久的重排。务实的做法是设"换榜阈值":名次变化超过分位带(比如跌出前列)才调整侦查配置,带内抖动不动作;同时每次换版保留旧榜单存档,评审时能回答"当时的依据是什么"。
办案手记(要点回顾)
- 消息传递让分数由节点自身与邻域共同决定,网络传播是其透明的朴素基线;
- DTI 预测与排序共用图框架,决定候选有没有现成武器、收网周期长不长;
- 评估铁律按家族或时间切分,随机切分的漂亮指标多半是记忆重现;
- 可解释性审计分生物学合理线与热度偏差线,归因不清单宁可降级不送收网;
- 推理章交付物:分数可拆解、高位有解释、评估经得起换批重算的嫌疑榜;
- 下一站第 5 章:嫌疑榜交实弹,CRISPR 大排查开场。