5.1 CRISPR 文库筛选:全基因组大排查
5.1 CRISPR 文库筛选:全基因组大排查
本节摘要:CRISPR 文库筛选把第 2 章的单基因审讯升级成工业化排查:一次实验对约两万个基因同时执行敲除,在疾病相关的选择压力下读出"动谁谁出事"。本节讲方案的四个设计开关、读数分析逻辑与一段演算,以及覆盖度、脱靶、背景选择三大坑。它承接第 4 章嫌疑榜,是收网的第一枪。
收网从最大规模的审讯开始。本节在证据链上的位置:它把 2.2 的扰动审讯从"一次一个"放大到"一次全部",给嫌疑榜上的每个候选一次在同台条件下被复查的机会——侦查排序如果有偏,这一步是纠偏的机会;实验读数如果有坑,这一步也是埋雷的重灾区。
排查方案怎么设计
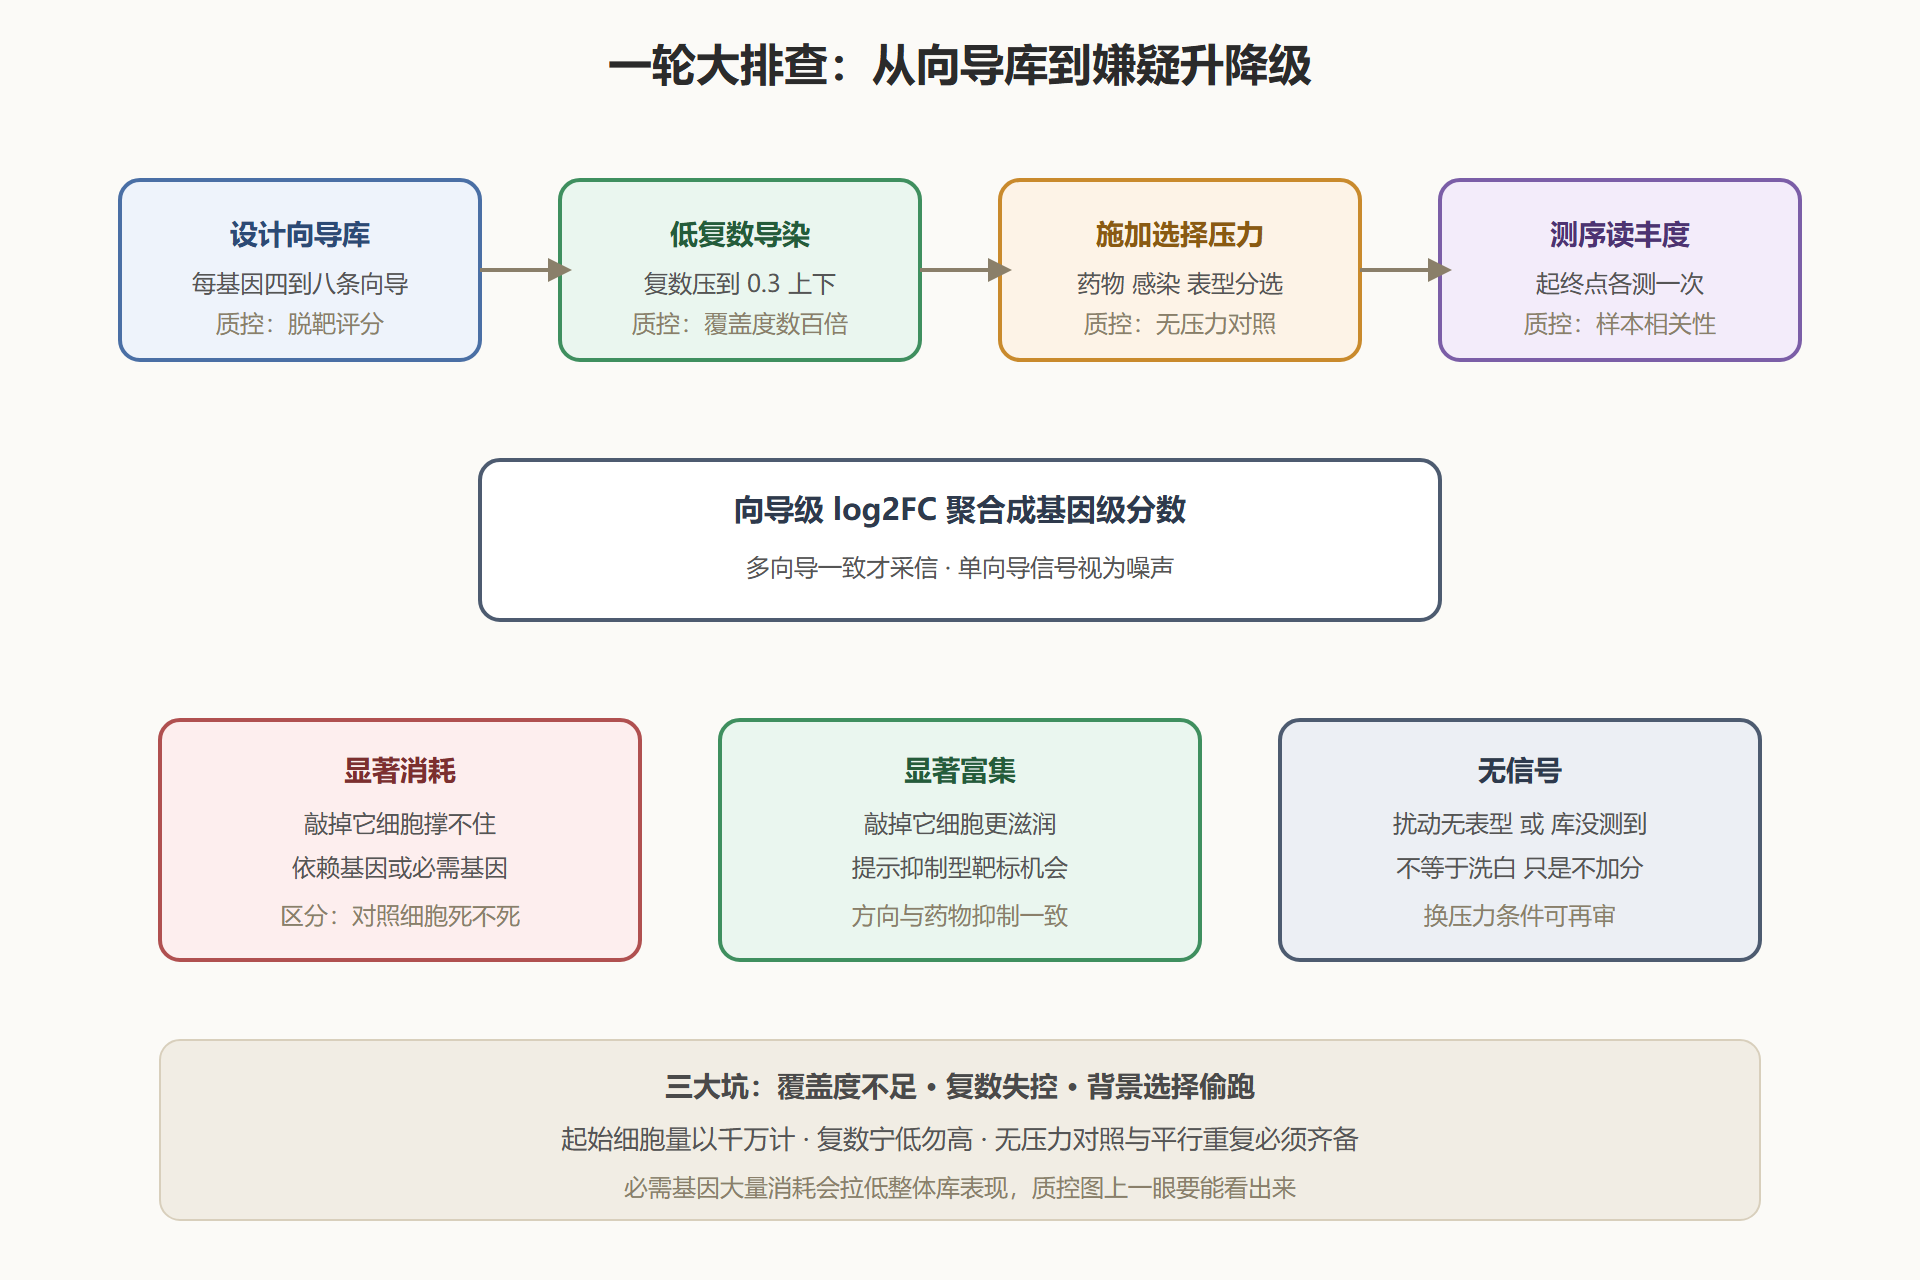
一轮全基因组 CRISPR 筛选(以敲除为例)的标准流程:设计并合成向导 RNA 文库(每个基因通常配四到八条向导,全库十万条上下);把文库以低感染复数导入细胞,保证每个细胞只带一条向导;施加选择压力(药物处理、病原感染、微环境胁迫,或与疾病表型挂钩的分选);培养若干代后测序统计每条向导的丰度变化。某条向导被显著消耗,说明它敲掉的基因在当前压力下是细胞的活路;被富集,说明敲掉它反而让细胞活得更滋润。
方案设计有四个开关,每个都决定数据的可用性:
- 文库开关:全基因组库做发现,定制库(聚焦某通路或嫌疑榜前几十个基因、每基因十几条向导)做复核。预算有限时,"全库粗筛 + 定制库精筛"两级方案最稳。
- 感染复数开关:复数必须压到 0.3 上下(多数细胞只感染一条向导),否则一个细胞里多条向导的表型混在一起,归因失效。这是最容易被赶进度牺牲、也最不能牺牲的开关。
- 覆盖度开关:每条向导在起始细胞群里要有数百个代表("覆盖度"),库里十万条向导意味着起始细胞量以千万计。覆盖不足时,丰度变化的随机漂移会淹没真实信号。
- 选择压力开关:压力要贴合疾病机制(纤维化模型用基质活化读数,感染模型用病原入侵),并留无压力对照组——两组相减才能把"向导本身的影响"消掉。
读出丰度后,分析逻辑不复杂:把基因名下所有向导的丰度变化聚合成基因级分数,排序。主流工具(MAGeCK 一族)用负二项模型做聚合与检验,下面的演算演示聚合的核心逻辑。
# CRISPR 筛选读数分析:向导级 log2FC -> 基因级聚合与排序 import math, statistics # 模拟一次筛选的测序计数:无压力对照组 与 药物压力组 library = { # 基因: [(向导名, 对照计数, 压力计数), ...] "MUC5B": [("g1", 500, 180), ("g2", 520, 210), ("g3", 480, 195), ("g4", 510, 205)], "TGFB1": [("g1", 495, 470), ("g2", 505, 500), ("g3", 488, 460), ("g4", 512, 495)], "LOX": [("g1", 500, 160), ("g2", 490, 150), ("g3", 505, 175), ("g4", 498, 168)], "COL1A1": [("g1", 495, 488), ("g2", 500, 492), ("g3", 490, 485), ("g4", 505, 498)], "ACTB": [("g1", 500, 60), ("g2", 505, 55), ("g3", 495, 62), ("g4", 500, 58)], # 必需基因 "SAFE1": [("g1", 500, 505), ("g2", 495, 490), ("g3", 502, 498), ("g4", 497, 500)], # 阴性对照 } def gene_hits(gene_guides): """每条向导算压力对对照组的 log2FC,再取基因内中位数聚合""" l2 = [] for g, c_ctrl, c_drug in gene_guides: l2.append(math.log2((c_drug + 1) / (c_ctrl + 1))) return statistics.median(l2), l2 print(f"{'基因':<8}{'中位log2FC':>12} 向导一致性 判读") rows = [] for gene, guides in library.items(): med, l2 = gene_hits(guides) consistent = all(x < 0 for x in l2) or all(x > 0 for x in l2) if med < -1 and consistent: verdict = "显著消耗:候选依赖/必需" elif med > 1 and consistent: verdict = "显著富集:敲掉更有利" else: verdict = "无信号" rows.append((gene, med, consistent, verdict)) for gene, med, _, v in sorted(rows, key=lambda r: r[1]): print(f"{gene:<8}{med:>12.2f} {'一致' if _ else '不一致'} {v}") # 解读方向:ACTB(必需基因)重消耗 = 阳性质控; # SAFE1 无信号 = 阴性质控;MUC5B 与 LOX 显著消耗, # 说明这两个侦查排序候选在药物压力下确为细胞依赖——嫌疑升级。
图 5-1:全基因组排查的流程与质控位
三大坑:排查怎么翻车
覆盖度不足。文库每条向导的代表数掉了,丰度读数就成了抽签。翻车现场的特征是:重复实验的相关性低、大量"单向导显著"的假 hit。治理靠起始细胞量与取样量的预算纪律——这页账不能省。
感染复数失控。复数一高,一个细胞多条向导,消耗读数无法归因到单个基因;更隐蔽的是多条向导同时敲在相关通路上造成的"组合效应"假信号。复数要用流式或抗性比例实测,不能只信感染时的加样比例。
背景选择偷跑。培养过程中细胞自身在演化:长得快的克隆自发扩张,与向导无关。表现为"某些向导在对照组里也大幅波动"。治理靠生物学重复、时间匹配对照,以及对"跨重复不一致"的 hit 坚决降级。
⚠️ 常见坑:把"敲除致死"直接当成好靶标。全库筛出的重消耗基因大头是核糖体与剪接体这类必需基因——正常细胞同样离不开。只有"疾病细胞依赖、正常细胞不依赖"的消耗才通向治疗窗口,对照组比较不能省。
排查的常见疑问
全库筛和定制库怎么分配预算?
两级方案:全库粗筛负责发现预期外依赖(它的价值恰恰是"不知道该筛谁"的场景),定制库负责复核与扩展(每基因十条以上向导、加时间点重复)。预算紧张时的正确取舍是保覆盖度而非保基因数——两万个基因低覆盖度地过一遍,不如八千个基因高覆盖度过一遍;漏掉的基因可以下一轮补,噪声里的假 hit 却会让整轮白干。
非编码区与 RNA 编辑类靶标能进库吗?
传统 CRISPR 敲除库只覆盖蛋白编码区,非编码元件(增强子、剪接位点、lncRNA)需要专属库型:CRISPRi 用 dCas9 压制调控元件,碱基编辑库做点突变扫描。这类库的设计难度更高(每个元件的"向导打哪里"没有编码区那么直白),但肿瘤与遗传病领域已经跑通多轮——如果案子的嫌疑区在非编码地带,库型选错了什么都筛不出来。
命中之后的复核流程怎么走?
标准四步:定制库复筛(同基因多条向导一致消耗);独立验证(单个基因的单向导敲除实验,含蛋白量验证);表型 rescue(回补抗编辑版本,表型恢复才算数);背景扩展(换细胞系或换疾病模型看依赖是否保留)。四步走完还站得住的 hit,才配得上"候选靶标"四个字——每一步都有文献报道过漏步翻车的先例,省不得。
读数质量的四道体检
分析数据前先给实验质量做体检,四道缺一不可。文库代表性:起测样本里向导检出率与丰度分布应均匀,掉到检测线以下的向导比例过高说明覆盖度崩了。重复相关性:同条件重复实验的向导级读数相关系数要有基本盘(通常看到 0.7 以上才谈分析),低相关的重复先解决实验再谈结论。质控向导的表现:必需基因向导组应整体强消耗、安全位点向导组应纹丝不动,两头失灵分别提示压力过度或批次错乱。选择压力的动态:无压力对照组随培养代数的漂移幅度,决定了"多大的丰度变化才算信号"——漂移大的实验,阈值要相应收紧。四道体检的结果要原样写进分析报告:排查结论的可信度,从来是实验质量与分析方法共同决定的。
体检之外还有一条分析层的纪律:hit 名单必须带"方向注记"而不是裸排序。每个基因旁标注消耗还是富集、跨重复的一致性、以及是否落在第 4 章嫌疑榜的预期区——排查结果的正确读法是与侦查排序对照着读:榜上靠前且实验消耗的候选是双证加强;实验消耗但榜上无名的,提示侦查有盲区;榜上有名但实验纹丝不动的,回查选择压力是否真正触达了该靶标的工作情境。裸排序丢掉的全部是这种交叉信息。
办案手记(要点回顾)
- 一轮排查 = 向导库 × 低复数 × 选择压力 × 测序读出,四个开关各有质控位;
- 向导级读数聚合到基因级,多向导一致是采信的最低门槛;
- 消耗与富集两类读数分别指向依赖机会与抑制机会,必需基因要用对照剔除;
- 阳性质控(必需基因)与阴性质控(安全位点)是每轮排查的标配;
- 覆盖度、复数、背景选择是三大翻车点,预算与耐心都不能省;
- 下一站 5.2:换个方向收网——不问嫌疑人是谁,先找能纠正现场的分子。