5.4 遗传学验证:孟德尔随机化定因果
5.4 遗传学验证:孟德尔随机化定因果
本节摘要:实验收网证明"扰动它有效",孟德尔随机化(MR)用人群里的天然实验证明"它的高低真的改变疾病"。本节讲工具变量三条件、MR 的估计逻辑与一段演算、共定位怎么防区域混淆,以及动物模型在验证链条上的交接位置。它是定案报告里证据等级最高的一章,PCSK9 案例贯穿全节。
细胞实验再漂亮,也回答不了一个终极问题:在真实人群里,这个靶标的活性高低是否真的改变疾病进程?MR 用基因变异做"天然工具"回答它。本节是收网的因果定章——筛选与药理证据在这里接受最严格的质证。
用天生实验定因果
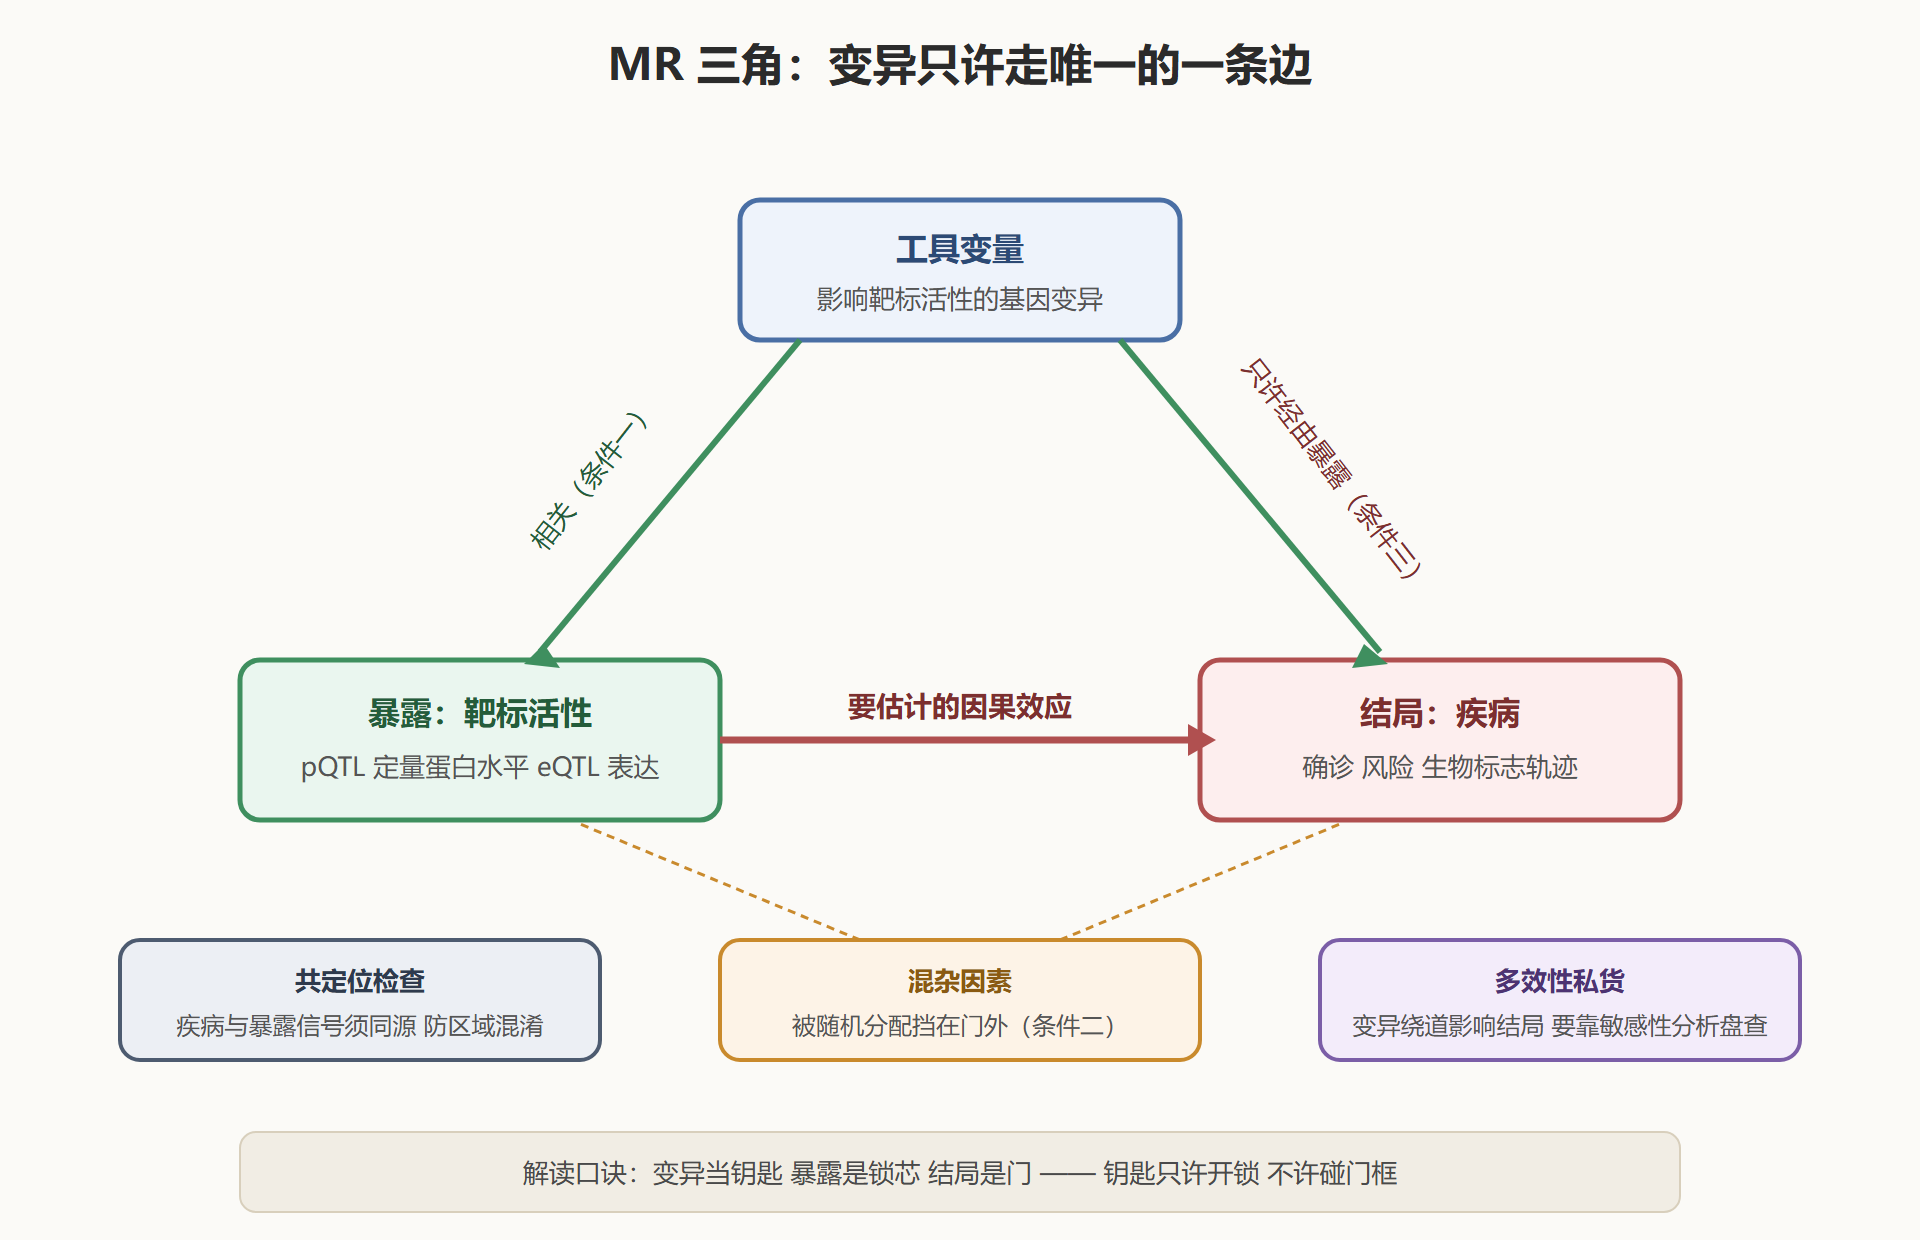
MR 的直觉是借用随机对照试验的结构。药物试验的随机性是研究者给的;MR 的随机性是减数分裂给的——等位基因传给下一代随机分配,出生时已定型,不受环境、行为、反向因果的污染。结构上,工具变量(基因变异)站在 exposures(靶标活性,比如某蛋白的血液水平)旁边,通过它推断 exposure 对 outcome(疾病)的因果效应。
这个推断成立要满足工具变量三条件:
- 相关:变异确实影响暴露(靶标活性或水平)——可用 pQTL、eQTL 数据直接检验;
- 独立:变异不受混杂因素影响——出生随机性保证这一点,前提是控制住人群分层(祖先背景);
- 排他:变异只经由暴露影响结局,不夹带私货(多效性)——这是 MR 最脆弱的一环,需要敏感性分析反复盘查。
估计方法里最直白的是比值法(Wald 比值):变异-暴露的效应除以变异-结局的效应。多个变异时用加权汇总(逆方差加权),并配一排敏感性分析(MR-Egger 检查定向多效性、留一法检查单个变异的绑架效应)。下面的演算走一遍单变异比值法与稳健性检查的核心逻辑。
# 孟德尔随机化玩具演算:比值法 + 敏感性检查 import math, random random.seed(3) # 设定真实效应(仿真实验用):靶标蛋白水平每降 1 单位,疾病风险比降 8% TRUE_EFFECT = 0.92 variants = { # 变异: (效应对暴露 beta_exposure, 效应对结局 log-odds beta_outcome) "rsA": (-0.50, 0.042), # 与真实效应一致 "rsB": (-0.32, 0.026), "rsC": (-0.21, 0.017), "rsD": (-0.44, 0.001), # 疑多效性:对暴露有作用 对结局几乎无作用 } def wald(be, bo): return bo / be estimates = {v: wald(be, bo) for v, (be, bo) in variants.items()} print("单变异 Wald 估计(每降1单位暴露的 log-odds 变化):") for v, e in estimates.items(): print(f" {v}: {e:+.3f}") vals = list(estimates.values()) ivw = sum(vals) / len(vals) # 简化逆方差加权(等权示意) lof = [e for v, e in estimates.items() if v != "rsD"] print(f"\n全部变异 IVW:{ivw:+.3f}") print(f"剔除疑多效变异后:{sum(lof)/len(lof):+.3f}") print(f"MR-Egger 与留一法:真实项目必跑,用于盘查 rsD 这类私货变异") print(f"剔除 rsD 后对应的风险变化(每降1单位暴露):{math.exp(sum(lof)/len(lof)):.3f}") # 解读:剔除 rsD 前后估计差异显著 -> rsD 私货明显(工具变量条件三存疑), # 稳健结论以剔后估计为准;真实项目里还要跑留一法与异质性检验。
图 5-3:孟德尔随机化的三角结构
共定位:防止"同街区撞名"
MR 用到全基因组层面的汇总数据时,有个必须做的体检:变异对暴露的关联与对结局的关联,可能只是因为两个信号恰好同在一个连锁不平衡街区(3.1 的老朋友)。两人同街区不等于同一人——共定位分析检验"两个关联是否由同一个因果变异驱动",只有共定位后验概率足够高,MR 的三角才真正闭合。共定位失败时,正确动作是换工具变异或换暴露读数(比如从 eQTL 换 pQTL——药物干预蛋白活性的场景里,蛋白水平的变异比 mRNA 水平的更对口),而不是硬着头皮下结论。
PCSK9:从验证到预言
把本章逻辑放回 PCSK9 案,能看到遗传验证在真实项目里的完整时序。立项前,功能缺失突变证据(1.2、3.1)本质就是一次人工版 MR:携带者天然低 PCSK9 活性、天然低冠心病风险。立项后、药物上市前,单抗的 III 期结果与遗传预测的幅度做对照——LDL 降幅换算的心血管事件减少率,与孟德尔模型按"一生暴露差"外推的预测在同一量级。这桩案子从此改写了行业流程:大型药企的靶标评审会上,MR 报告成为标配材料;"人类遗传学预测值与临床实测值的对账"成为验证科学的常规动作。
反例同样值得记:某些靶标实验数据全线飘绿,MR 却显示基因敲低与疾病风险无因果——后来临床失败。事后复盘里,MR 早就把答案写好了,只是没人把它放进定案报告。这就是本节的位置意义:它是收网证据链上成本最低、却最能预言临床的一环。
动物模型的交接位置
严格说动物模型不属于遗传学,但验证链条上它与 MR 互补:MR 的弱项是"暴露"模拟不了药物式的强干预(基因效应普遍温和),动物模型恰好能做强干预与组织水平的机制观察(基因敲除、条件性敲除、人源化模型)。合理的分工是:动物模型回答"机制上怎么发生、干预后组织怎么变",MR 回答"人身上值不值得干预";只有动物数据没有人群因果证据的项目,立项文书中必须显式标注这一空栏。此外还要记住物种折扣——小鼠实验转移人体的失败率不低,动物数据按证据等级应排在人类遗传证据之后。
遗传验证的常见疑问
没有可用的工具变异怎么办?
三步排查。换暴露读数:同一基因的 eQTL、pQTL、蛋白丰度变异是不同侧面,药物干预的是蛋白活性,pQTL 通常最对口。换数据层次:国内队列覆盖不足的位点,跨人群汇总数据可补样本量,但祖先异质性要重查。降级为"参考证据":确实无变异可用时(基因贫变异区、多效性区),把 MR 栏位记为"不可用",靠共定位、动物模型与药理证据合力补位——并把这个空栏写进定案报告,供后续评审复核。
MR 结果与细胞实验矛盾,信谁?
先看矛盾的类型再谈信谁。方向矛盾(遗传说低活性致病、实验说抑制有效):多见于"暴露形态不同"——基因变异是终身温和差异,药物是急性强抑制,中间的代偿机制完全不同,这时两边可能都对,只是各自的适用范围不同。幅度矛盾(方向一致但差几个量级):先查工具变量强度(弱工具会系统性低估效应)。MR 的角色是"人群因果的方向盘",它否决的是方向,不是幅度;幅度由药理与临床剂量探索负责。
共定位要看到多强才放心?
经验门槛是后验概率高位(通行的判定区间在 0.8 以上算支持、0.95 以上算强支持),但比阈值更重要的是共定位失败的解读:失败不代表 MR 作废,只说明两个信号可能不同源,要换工具变异或换暴露读数重试。共定位分析本身依赖参考人群与疾病队列的匹配度,人群错配会把真信号判成假、也把假信号判成真——报告里写清所用参考数据的来源与人群构成,是这条证据链的最后一环。
MR 报告的必填项
一份经得起评审的 MR 报告至少含六项:暴露与结局的读数定义(活性还是丰度、哪个数据库版本)、工具变异数与强度(F 统计量一类弱工具诊断)、主估计与各敏感性分析的并列结果、共定位证据与参考人群、异质性诊断、以及"证据空栏"声明(哪些环节做不到)。六项里最后一项最重要——MR 报告的可信度不来自结果多漂亮,来自它对自己边界的诚实。评审时看到六项俱全的报告,即使结论是阴性,也值得进讨论;五项缺一的阳性报告,反而要多留个心眼。
办案手记(要点回顾)
- MR 借减数分裂的随机性做天然实验,免疫于反向因果与环境混杂;
- 工具变量三条件中排他性最脆弱,敏感性分析与留一法是标配动作;
- 共定位检查防止"同街区撞名",信号不同源时 MR 结论不成立;
- pQTL 通常比 eQTL 更对准药物干预的暴露形态;
- PCSK9 案展示遗传验证可以定量预言临床幅度,MR 报告已是评审标配;
- 动物模型与 MR 分工互补,物种折扣决定了证据排序;
- 下一站 5.5:最后核对武器——工具化合物是否特异性、脱靶是否可控。