2.1 整体架构设计
2.1 整体架构设计
本节摘要:JMeter 分 GUI 和核心引擎两部分,核心引擎跑测试,GUI 只是编辑和查看。本节讲它的分层架构,帮你理解 GUI 和 CLI 的关系。
先说结论
阅读完本节,你应当能够:
- 概述 JMeter 的分层架构
- 区分 GUI 和非 GUI 模式
- 理解引擎、测试计划、监听器的关系
概念脉络
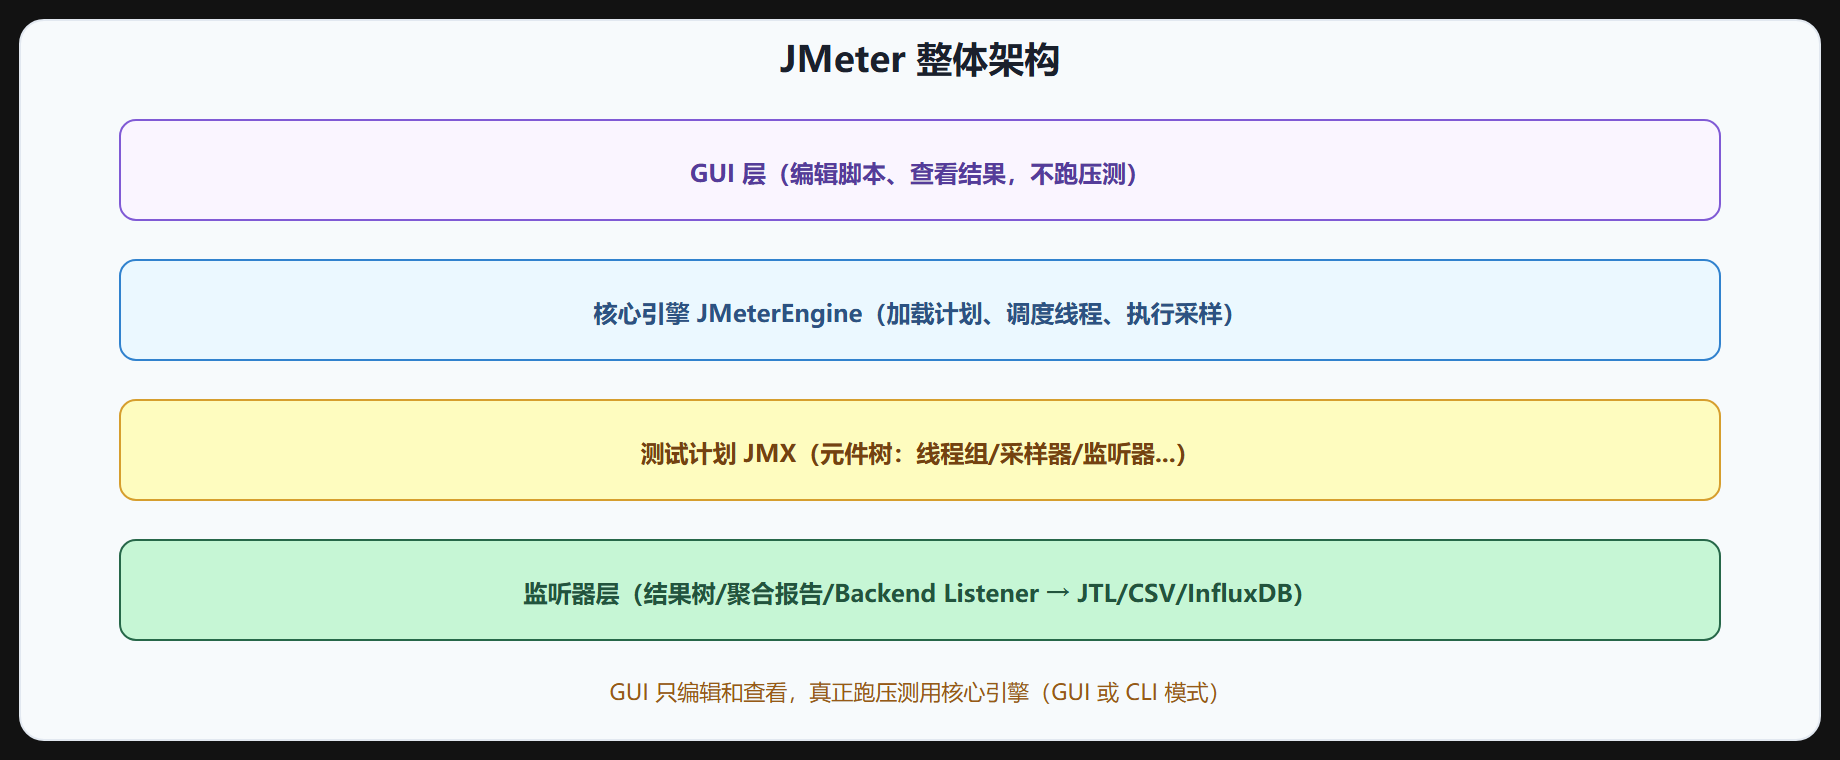
一、分层架构
JMeter 在逻辑上分几层:
- GUI 层:图形界面,编辑脚本、查看结果树,不参与压测执行
- 核心引擎:JMeterEngine,加载测试计划、调度线程、执行采样器
- 测试计划:JMX 文件,元件树的持久化
- 监听器层:采集结果,写文件或推外部系统
图 2-1 整体架构
二、GUI 模式 vs 非 GUI 模式
| 模式 | 用途 | 资源 | 适合 |
|---|---|---|---|
| GUI | 编辑调试脚本、查看结果树 | 占内存多 | 开发调试 |
| 非 GUI(CLI) | 跑压测 | 占资源少 | 正式压测 |
# 非 GUI 模式跑压测(生产推荐) jmeter -n -t test.jmx -l result.jtl -e -o report/ # -n 非 GUI,-t 脚本,-l 结果文件,-e 生成报告,-o 报告目录
⚠️ 常见坑:用 GUI 模式跑大压测——GUI 占内存、影响结果准确性。正式压测一定用非 GUI 模式。
三、引擎执行流程
- 加载 JMX 测试计划
- 解析元件树,初始化线程组
- 按 Ramp-up 逐步启动线程
- 每个线程循环执行采样器
- 采样结果交给监听器
- 监听器写文件或推外部系统
四、JMX 文件
JMX 是 XML 格式的脚本文件,保存整棵元件树。可版本管理、可手工编辑(但不推荐,复杂)。团队协作时把 JMX 放 Git。
💡 关键直觉:JMeter 分 GUI(编辑查看)和核心引擎(执行)。GUI 不跑压测,正式压测用非 GUI 模式。JMX 是 XML 脚本,可版本管理。
重点提炼
- 分层:GUI 层(编辑查看)→ 核心引擎(执行)→ 测试计划 JMX → 监听器层(结果)。
- GUI vs CLI:GUI 调试,非 GUI 跑压测,正式压测用 CLI 省资源保准确。
- 执行流程:加载 JMX→解析线程组→Ramp-up 启动线程→循环采样→监听器出结果。
- JMX:XML 脚本,可版本管理,团队协作放 Git。
下一节讲线程调度模型——线程数、Ramp-up、循环怎么配合。
架构层次
JMeter 的架构可理解为三层:核心引擎层(线程调度、采样执行、结果收集)、元件模型层(线程组、采样器、断言等可组合元件)、界面/CLI 层(GUI 编辑与命令行执行)。这种分层让 JMeter 既可在 GUI 中可视化搭建,也可在无界面环境用 CLI 大规模执行,两种模式共享同一套测试计划文件(.jmx)。
线程模型
JMeter 为每个线程维护独立的上下文(变量、cookie、连接),线程按线程组配置并发执行采样器。线程生命周期:启动 → 按逻辑控制器顺序执行采样 → 通过断言 → 记录结果 → 循环或结束。理解线程模型有助于评估脚本开销:每个线程持有独立的 HTTP 连接池与变量表,线程数过大时内存占用显著。
架构优势与局限
优势:元件可组合、脚本可移植、支持多协议;局限:纯 Java 的线程模型在高并发下内存开销较大,脚本执行效率低于代码化工具(Gatling 的异步模型)。架构理解是排查"压测机自身成为瓶颈"问题的前提。
架构示意图
JMeter 架构 ├── GUI 模式(编辑测试计划) │ └── 树形元件模型 ├── CLI 模式(无界面执行) │ └── 命令行参数 + 测试计划文件 └── 核心引擎 ├── 线程调度器(启动/停止虚拟用户) ├── 采样执行器(按逻辑执行采样器) ├── 断言引擎(校验响应) ├── 结果收集器(生成 jtl/CSV) └── 变量/属性管理器(参数传递)
模式选择
GUI 模式适合脚本编辑与调试(可视化、直观),但不适合大规模压测(界面渲染消耗资源);CLI 模式适合生产执行(低开销、可脚本化、可并行)。工程实践标准做法:GUI 编辑脚本,CLI 执行压测,两者共用同一 .jmx 文件,保证一致性。
JMeter 的插件机制建立在核心引擎之上:所有元件(采样器、断言、监听器)通过统一的接口注册,这也是为什么第三方插件能无缝集成。理解这一设计,你就知道为什么 JMeter 的扩展如此容易——任何实现标准接口的 Java 类都可以成为 JMeter 的一部分。
架构与性能的关系
架构设计直接影响压测能力:树形模型让测试计划易于组织,但过于庞大的树(上千节点)会拖慢 GUI 渲染与 CLI 解析;线程模型简单可靠但内存开销大。工程实践中,用合理粒度的测试计划(单个计划 50 个节点以内)与 CLI 执行模式,能兼顾可维护性与性能。