4.3 分布式测试架构
4.3 分布式测试架构
本节摘要:单机 JVM 扛不住几千并发,要多机协同。本节讲 JMeter 分布式主从架构、怎么搭、怎么跑——把压测规模提上去。
你能学到什么
阅读完本节,你应当能够:
- 理解主从分布式架构
- 搭建分布式压测环境
- 避免分布式常见坑
概念脉络
一、为什么需要分布式
JMeter 单机基于 JVM,每线程占内存,单机模拟几千并发就吃力,再高 JVM 自己先崩,结果不准。分布式把负载分到多台机器,每台跑一部分线程,合起来模拟大规模并发。
二、主从架构
图 4-3 分布式主从架构
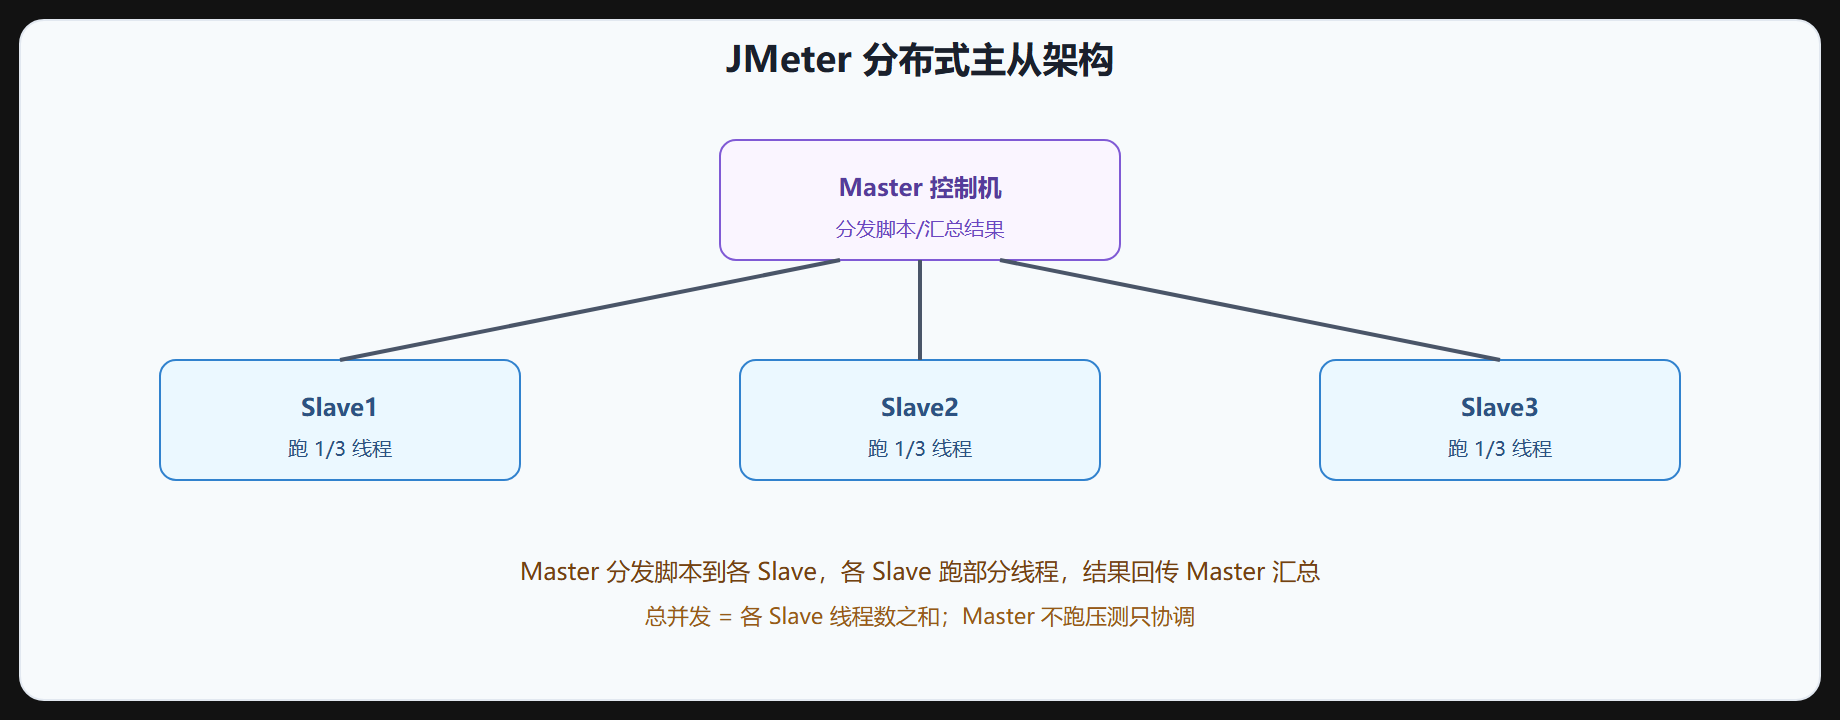
- Master(控制机):分发脚本、启动/停止、汇总结果,不跑压测
- Slave(执行机):跑实际线程发请求,回传结果
三、搭建步骤
- 各 Slave 启动 jmeter-server:
# Slave 机上 cd %JMETER_HOME%\bin jmeter-server.bat # Windows ./jmeter-server.sh # Linux
- Master 配置 remote_hosts:
# jmeter.properties remote_hosts=192.168.1.101,192.168.1.102,192.168.1.103
- Master 启动并远程启动所有:
jmeter -n -t test.jmx -l result.jtl -r # -r 启动所有远程 Slave
四、注意事项
- 网络互通:Master 和 Slave 互通,开放 RMI 端口(默认 1099)和动态端口
- 时钟同步:各机时钟要同步(NTP),否则时间戳错乱
- 脚本一致:各 Slave 上脚本和参数文件路径要一致,或用相对路径
- Slave 资源:每 Slave 别超自己 JVM 承受,按机器内存定线程数
- Master 不跑压测:Master 只协调,否则自己负载影响汇总
五、容器化分布式
用 Docker/K8s 跑分布式更方便:官方 JMeter 镜像 + 编排脚本一键起多 Slave。K8s 可动态扩缩 Slave 数量。
⚠️ 常见坑:Master 也跑线程——Master 自己负载高影响结果汇总。分布式时 Master 只协调不跑压测。
💡 关键直觉:分布式把负载分多机,Master 分发汇总不跑压测,Slave 跑线程回传结果。网络互通、时钟同步、脚本路径一致是关键。
本章回顾
- 目的:单机 JVM 扛不住高并发,多机分担。
- 架构:Master(分发汇总,不跑压测)+ 多 Slave(跑线程回传)。
- 搭建:Slave 启 jmeter-server,Master 配 remote_hosts,
-r远程启动。 - 注意:网络互通、时钟同步、脚本路径一致、每 Slave 别超 JVM 承受。
- 容器化:Docker/K8s 一键起多 Slave,可动态扩缩。
下一节讲自定义扩展——JMeter 不够用时怎么扩展。
分布式架构
JMeter 分布式测试由控制机(Master)与执行机(Slave)组成:Master 下发测试计划并汇总结果,Slave 执行采样并回传结果。部署方式:所有机器安装 JMeter,Slave 启动 jmeter-server,Master 通过 -R 参数指定远程节点执行。
部署步骤
- 在所有机器安装相同版本 JMeter 与 JDK
- 各 Slave 启动 jmeter-server(默认端口 1099)
- Master 用 jmeter -n -t plan.jmx -R slave1,slave2 执行
- 关闭 Master 自身的采样(-r 与 -R 的区别)
- 检查防火墙与端口连通性
注意事项
分布式执行的关键注意:脚本中的 CSV 数据文件需分发到各 Slave(或使用共享存储);结果回传量大会拖慢 Master,建议各 Slave 本地写结果再汇总;时间同步(NTP)保证测试同时开始;各 Slave 配置一致(相同线程模型与 JVM 参数),否则并发分布不均。分布式不等于无限扩展,实际并发受总带宽与目标系统限制。
分布式排查清单
分布式测试常见问题排查:Slave 无法连接(检查 jmeter-server 启动与防火墙 1099 端口);结果缺失(确认 -R 与 -r 参数差异,-r 表示远程启动全部已配置节点);数据文件缺失(CSV 需同步到各 Slave,或使用共享存储);时间不同步(配置 NTP);版本不一致(所有节点版本与插件完全一致)。
性能估算
估算分布式规模的经验法则:单台 8 核 16G 机器可支撑约 1000-3000 并发(视脚本复杂度);脚本越复杂(大量断言、提取器)单机并发越低。先测单机能力,再按目标并发线性扩展节点数,并预留 20% 余量。监控各 Slave 的 CPU 与内存,避免个别节点过载拖慢整体。
分布式测试的替代方案:单机高并发(脚本精简、异步执行、减少监听器);云压测服务(免运维弹性扩容);代码化压测工具(Gatling 异步模型单机并发更高)。方案选择基于规模、成本与团队能力,分布式并非唯一答案。
结果一致性
分布式结果的一致性保障:各 Slave 使用相同线程模型与数据;Master 汇总时注意时间戳对齐;结果文件按 Slave 分段保存便于追溯;对比各 Slave 的指标确认负载均衡(若某 Slave 明显偏高,可能是数据或脚本差异)。
总结:分布式架构突破单机并发上限,但也引入部署、数据、结果一致性的新复杂度。理解 Master/Slave 职责、掌握部署排障清单、合理估算节点规模,是分布式压测从"能跑"到"跑得稳"的关键。