5.4 结果分析与报告生成
5.4 结果分析与报告生成
本节摘要:压测跑完看数据出结论。本节讲关键指标怎么看、怎么定位瓶颈、怎么生成报告——把数据变成可决策的结论。
本节导读
阅读完本节,你应当能够:
- 看懂关键性能指标
- 定位性能瓶颈
- 生成可读的压测报告
概念脉络
一、关键指标
| 指标 | 含义 | 关注 |
|---|---|---|
| 响应时间(RT) | 单请求耗时 | P90/P95/P99,不只平均 |
| 吞吐量(TPS/QPS) | 每秒处理请求数 | 是否达目标 |
| 错误率 | 失败请求占比 | 应接近 0 |
| 并发数 | 同时在跑的虚拟用户 | 是否达目标并发 |
| Apdex | 用户满意度指数 | 0-1,越高越好 |
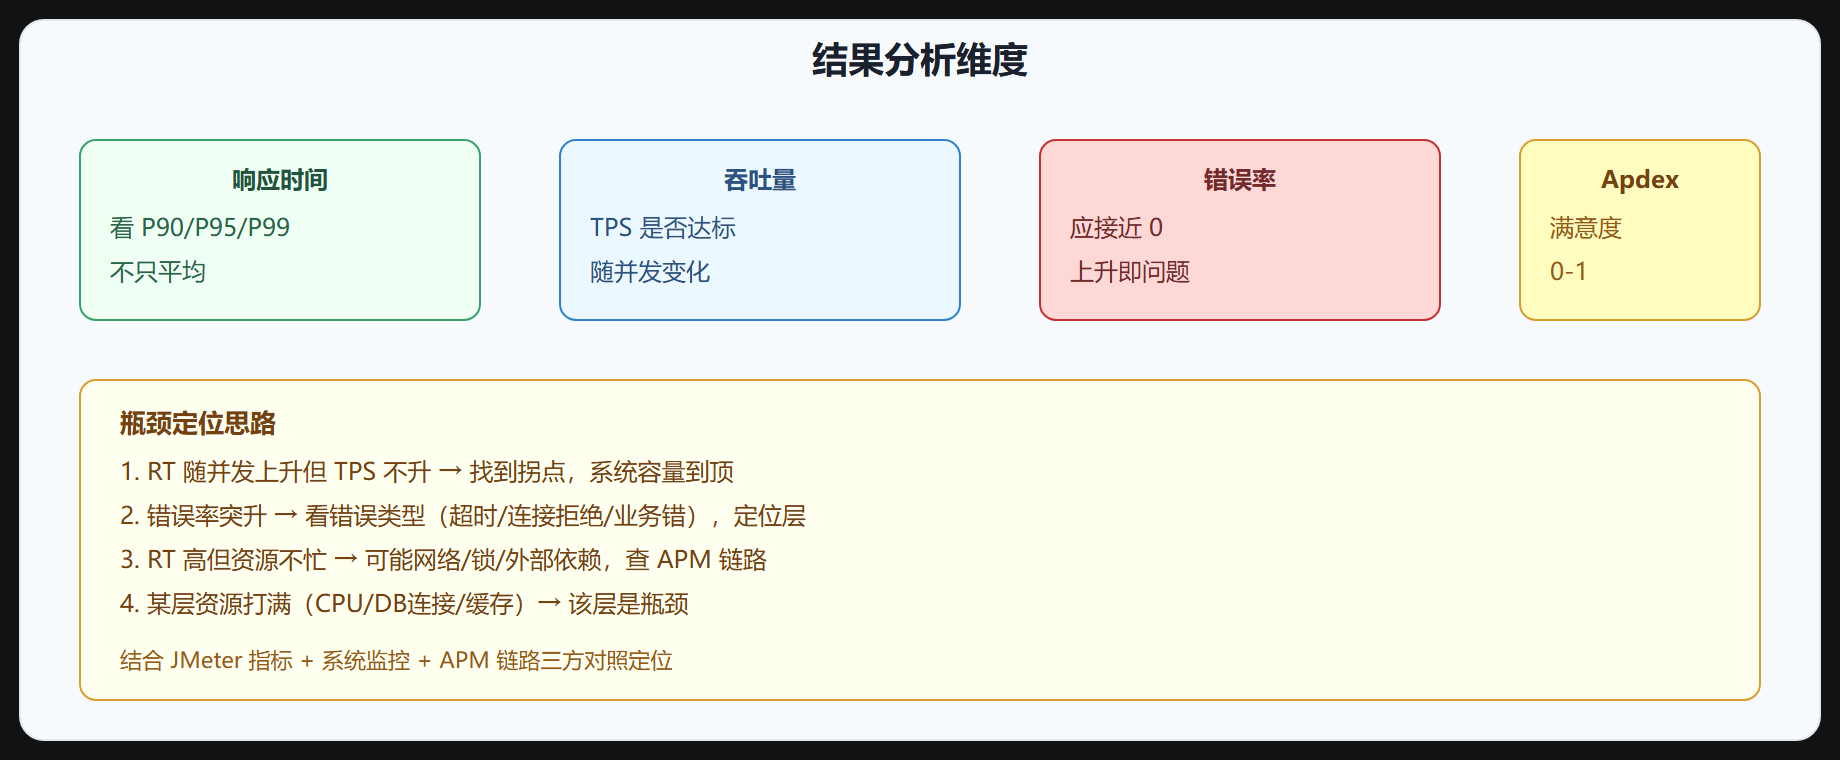
图 5-4 结果分析维度
二、为什么看 P90/P99 不只平均
平均响应时间会被大量快请求拉低,掩盖慢请求。100 个请求 99 个 10ms、1 个 1000ms,平均 19.9ms 看着不错,但那个 1000ms 的用户感知很差。P90/P99 反映尾部,更接近真实用户体验。
三、瓶颈定位思路
- RT 上升 TPS 不升:到拐点,系统容量到顶
- 错误率突升:看错误类型(超时/连接拒绝/业务错),定位层
- RT 高但资源不忙:可能网络/锁/外部依赖,查 APM 链路
- 某层资源打满:CPU/DB连接/缓存打满,该层是瓶颈
结合 JMeter 指标 + 系统监控 + APM 链路三方对照定位。
四、生成 HTML 报告
jmeter -n -t test.jmx -l result.jtl -e -o report/ # 或已有 jtl 后生成 jmeter -g result.jtl -o report/
报告含:响应时间分布、P90/P95/P99、吞吐量、错误率、Apdex、随时间变化曲线、各采样器统计。
五、报告要点
- 结论先行:是否达标、瓶颈在哪、建议优化什么
- 数据支撑:关键指标数据 + 趋势图
- 可复现:附脚本、环境、数据说明,别人能复现
- 可对比:与上次基线对比,看优化效果
⚠️ 常见坑:只看平均响应时间——慢请求被平均掩盖。看 P90/P95/P99 才能发现尾部问题。
💡 关键直觉:看 P90/P99 不只平均,RT+TPS+错误率+资源对照定位瓶颈。报告结论先行、数据支撑、可复现可对比。
本节速览
- 关键指标:RT(看 P90/P99)、TPS、错误率、并发数、Apdex。
- 看 P90/P99:平均掩盖慢请求,尾部指标反映真实体验。
- 瓶颈定位:RT 升 TPS 不升到拐点;错误突升看类型;RT 高资源不忙查链路;资源打满该层瓶颈。
- HTML 报告:
-e -o生成,含分布/百分位/吞吐/错误/Apdex/趋势。 - 报告要点:结论先行、数据支撑、可复现、可对比基线。
第 5 章结束。下一章讲生态集成——把 JMeter 融入工具链。
结果分析框架
结果分析遵循"分层定位"思路:先看整体(总吞吐、平均响应时间、错误率)→ 再按接口分层(哪个接口最慢、错误最多)→ 再看时间趋势(是否随时间劣化)→ 结合系统监控(CPU、内存、GC、连接池)定位瓶颈。
报告要素
一份合格的性能测试报告应包含:测试目标与结论(明确达标与否);测试环境(硬件、版本、网络);场景与参数(线程、时长、数据);结果数据(响应时间分布、吞吐、错误率);系统监控数据(资源使用率曲线);瓶颈分析与建议(优化方向)。
常用分析维度
| 维度 | 指标 | 问题信号 |
|---|---|---|
| 响应时间 | 90%/99% 分位 | 分位远高于平均 |
| 吞吐量 | TPS/QPS | 提前拐点下降 |
| 错误率 | Error % | 随时间上升 |
| 资源 | CPU/内存 | 持续高位或波动 |
| GC | GC 频率/时长 | 频繁 Full GC |
报告建议用图表呈现趋势(响应时间曲线、吞吐曲线),结论要可执行(给出明确的优化建议与验证方案)。
报告自动化
结果报告的自动化生成:JMeter 5.x 内置 HTML 报告生成(jmeter -g 结果.jtl -o 报告目录),产出包含概览、图表、统计的静态站点;结合 Jenkins 插件可自动归档历史报告并绘制趋势。建议将报告生成纳入 CI 流水线,每次压测自动产出可共享的 HTML 报告,替代手工整理。
结论撰写模板
性能结论的撰写模板:被测对象与版本;测试环境与参数;核心指标结果(响应时间分布、吞吐、错误率);对比基线结论(达标/未达标、劣化幅度);瓶颈定位(结合系统监控);优化建议(具体可执行);验证计划(优化后复测方案)。结论必须基于数据、给出明确判断,避免模棱两可的表述。
性能瓶颈的常见层次:客户端(压测机资源);网络(带宽/延迟/丢包);Web 服务器(连接数/线程池);应用服务(CPU/内存/GC/线程池);数据库(连接池/慢查询/锁);外部依赖(第三方接口/中间件)。逐层排查并排除该层问题后进入下一层,是定位瓶颈的经典方法。
报告复盘
报告输出后的复盘:与研发、运维共同评审结果;确认瓶颈归属与优化优先级;制定优化计划(谁、何时、如何验证);优化完成后复测对比,验证效果并更新基线。性能优化是闭环过程,报告只是其中一环。