7.1 常见问题诊断
7.1 常见问题诊断
本节摘要:压测中常见问题——脚本跑不通、结果异常、连不上、错误率高。本节讲这些问题怎么定位和解决。
先说结论
阅读完本节,你应当能够:
- 诊断脚本错误
- 排查结果异常
- 解决连接问题
概念脉络
一、先定位是哪层的问题
压测出问题先分清是哪层:
- 脚本层:脚本配置错(变量没取到、断言失败)
- 网络层:连不上、超时(防火墙、DNS、端口)
- 被测层:被测系统返回错(业务错、限流、5xx)
- JMeter 层:JMeter 自己崩(OOM、资源不够)
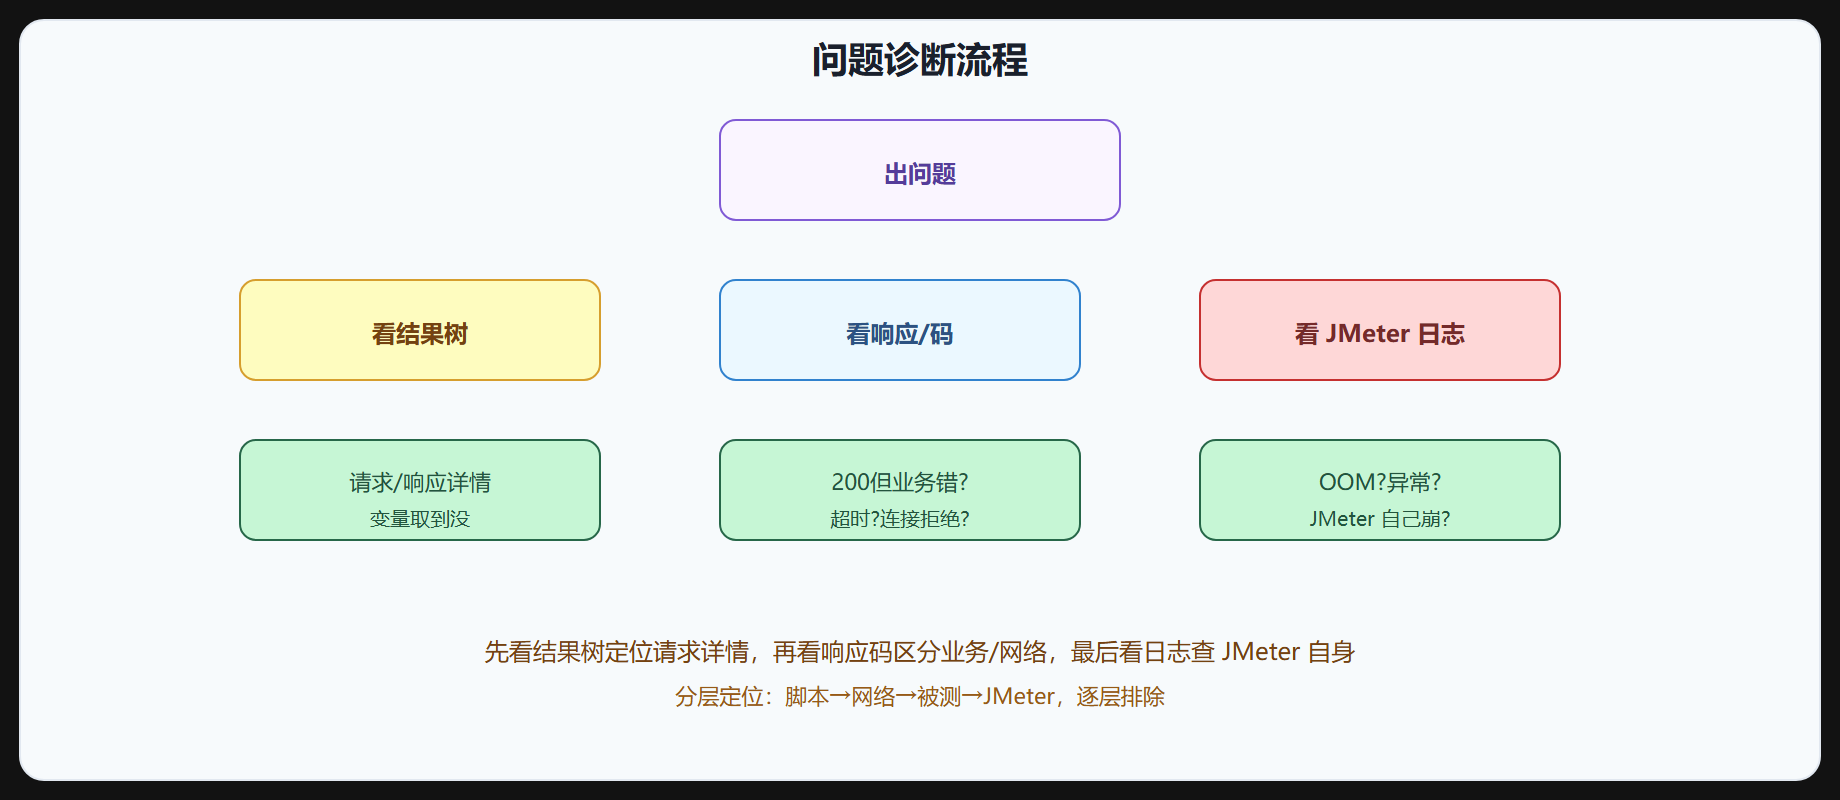
图 7-1 问题诊断流程
二、脚本错误
- 变量没取到:
${变量}原样显示,检查提取器配置、作用域 - 断言失败:看断言期望和实际响应,可能业务返回结构变了
- CSV 没读到:检查文件路径、分隔符、变量名
三、结果异常
- 错误率高:看错误类型——超时(网络/被测慢)、连接拒绝(被测连接池满)、业务错(参数错/限流)
- TPS 上不去:可能是 JMeter 自己瓶颈(CPU/内存打满),或被测到瓶颈
- RT 突然升高:被测 GC、锁等待、DB 慢查询,查 APM 链路
四、连接问题
- 连不上:防火墙、DNS、端口、HTTPS 证书
- 超时:网络延迟、被测响应慢、JMeter 超时设置太短
- HTTPS 证书错:用 SSL Manager 信任证书,或测试环境忽略
五、JMeter 自己崩
- OOM:线程太多、开结果树、JVM 堆不够,调大堆或分布式
- CPU 打满:Beanshell 脚本慢、线程太多,换 Groovy 或分布式
- 响应慢:监听器太多、结果树开着,关调试元件
⚠️ 常见坑:错误率高就怪被测系统——可能是脚本参数错、限流、或 JMeter 自己瓶颈。先看响应码和详情分清层。
💡 关键直觉:先定位是哪层问题(脚本/网络/被测/JMeter),看结果树看详情、看响应码分业务/网络、看日志查 JMeter 自身。分层逐层排除。
核心回顾
- 分层定位:脚本层、网络层、被测层、JMeter 层,逐层排除。
- 脚本错误:变量没取到、断言失败、CSV 没读到。
- 结果异常:错误率高看类型、TPS 上不去查瓶颈、RT 升高查 APM。
- 连接问题:防火墙/DNS/端口、超时、HTTPS 证书。
- JMeter 崩:OOM(调大堆/分布式)、CPU 打满(换 Groovy/分布式)、监听器太多关调试元件。
下一节讲 JMeter 自身性能调优。
高频问题
JMeter 常见问题:脚本报错(断言失败、提取器取不到值);压测机自身瓶颈(CPU 打满、内存溢出、连接耗尽);结果异常(响应时间虚高、错误率异常);分布式问题(Slave 掉线、结果丢失)。诊断思路:先看错误日志(jmeter.log 与采样器日志)→ 复现最小场景 → 检查环境与配置。
问题定位表
| 现象 | 可能原因 | 排查方法 |
|---|---|---|
| 响应时间虚高 | 压测机资源不足 | 观察压测机 CPU/内存 |
| 错误率突增 | 连接池耗尽/限流 | 检查服务器日志 |
| 提取器取不到值 | 表达式错误/动态内容 | 用 View Results 查看响应 |
| 内存溢出 | 结果缓存过大 | 启用流式写入/调大堆 |
| Slave 掉线 | 网络/防火墙/版本 | 检查端口与日志 |
诊断方法论
诊断遵循"从外到内":先确认压测链路(脚本→压测机→网络→被测系统)哪个环节异常;再分层排查(网络层用 ping/traceroute,系统层看监控,应用层看日志);最后做对照实验(降低并发是否正常、换数据是否正常)缩小范围。系统化的诊断方法比盲目试错高效得多。
实战排查案例
案例一:压测中响应时间突增 10 倍。排查路径:先看压测机 CPU(打满则压测机瓶颈)→ 再看目标服务器 CPU/连接数(满则服务器瓶颈)→ 检查网络(延迟升高则网络问题)→ 最终定位为数据库连接池耗尽。案例二:脚本间歇性报错。查看结果树发现偶发超时,排查为压测机线程数过多导致 GC 停顿,减少并发后恢复。系统化的排查路径让问题快速收敛。
日志分析方法
JMeter 日志分析要点:jmeter.log 记录引擎级错误(脚本错误、连接失败);采样器日志记录业务错误(通过 log.error 输出);结合时间戳对齐系统监控日志。日志级别可在 bin/log4j2.xml 调整(生产环境建议 INFO,排查时临时 DEBUG)。
命令行示例
诊断路径: 1. 压测机资源(CPU/MEM)是否打满 2. 网络层(延迟/丢包) 3. 目标服务器(CPU/连接/GC) 4. 数据库与中间件(连接池/慢查询) 5. 应用日志(错误/超时)
诊断工具
结合压测机监控(top/vmstat)、网络工具(ping/iperf)、服务器监控(Prometheus)与应用日志(ELK)四个数据源交叉定位,比单一视角更快收敛问题。