第1章 · 高并发方案定位与演进
第 1 章 · 高并发方案定位与演进
章节摘要:动手做高并发之前,先把“高并发到底是什么、怎么衡量、怎么演进”讲清楚。这一章定义高并发的本质——它不是单一指标,而是一组相互制约的指标的平衡;建立核心指标体系(QPS、RT、吞吐量、错误率、可用性);并梳理从“加机器扛流量”到“全局治理流量”再到“AI 辅助运维”的三阶段演进。读完你会用工程师的语言描述自己系统的并发能力。
学习目标
阅读完本章,你应当能够:
- 用 QPS、RT、吞吐量、错误率等指标量化系统的并发能力
- 解释这些指标之间的相互制约关系
- 区分吞吐量优先和延迟优先两类系统的设计取向
- 复述高并发方案从扛流量到治流量到智能运维的三阶段演进
- 判断自己的系统处在演进的哪个阶段、下一步该补什么
核心概念速览
高并发不是把 QPS 拉到多高,而是在目标 QPS 下把 RT、错误率、成本都控制在可接受范围——它是一组指标的平衡,不是单一数字。
子章节导航
1.1 高并发的本质与核心指标
把“高并发”从一个模糊形容词,变成一组可量化的指标。讲清 QPS、RT、吞吐量、错误率、可用性各自的含义,以及它们之间为什么相互制约——想提吞吐往往牺牲延迟,想降错误率往往要降并发。建立这套指标体系,是后面所有手段的基础。
1.2 从扛流量到治流量的演进
顺着时间线看高并发方案怎么进化:早期“加机器扩带宽”的朴素阶段,到“限流熔断降级”的疏导阶段,再到“全局流量治理”和“AI 辅助运维”的智能阶段。理解这条线,才能看清自己处在哪、往哪走。
子章节之间的逻辑关系
1.1 给你一把量尺(指标体系),1.2 给你一条时间线(演进脉络)。先用尺子量清现状,再看时间线知道往哪走。
1.1 量化(指标体系) ──► 1.2 演进(往哪走)
前置知识与后续延伸
- 前置知识:基本的 Web 后端开发经验(写过接口、用过数据库)。
- 后续延伸:本章建立指标和演进认知。第 2 章会钻进系统架构,看流量从入口到数据层怎么分层治理。
延伸:三套主流演进路径的对比
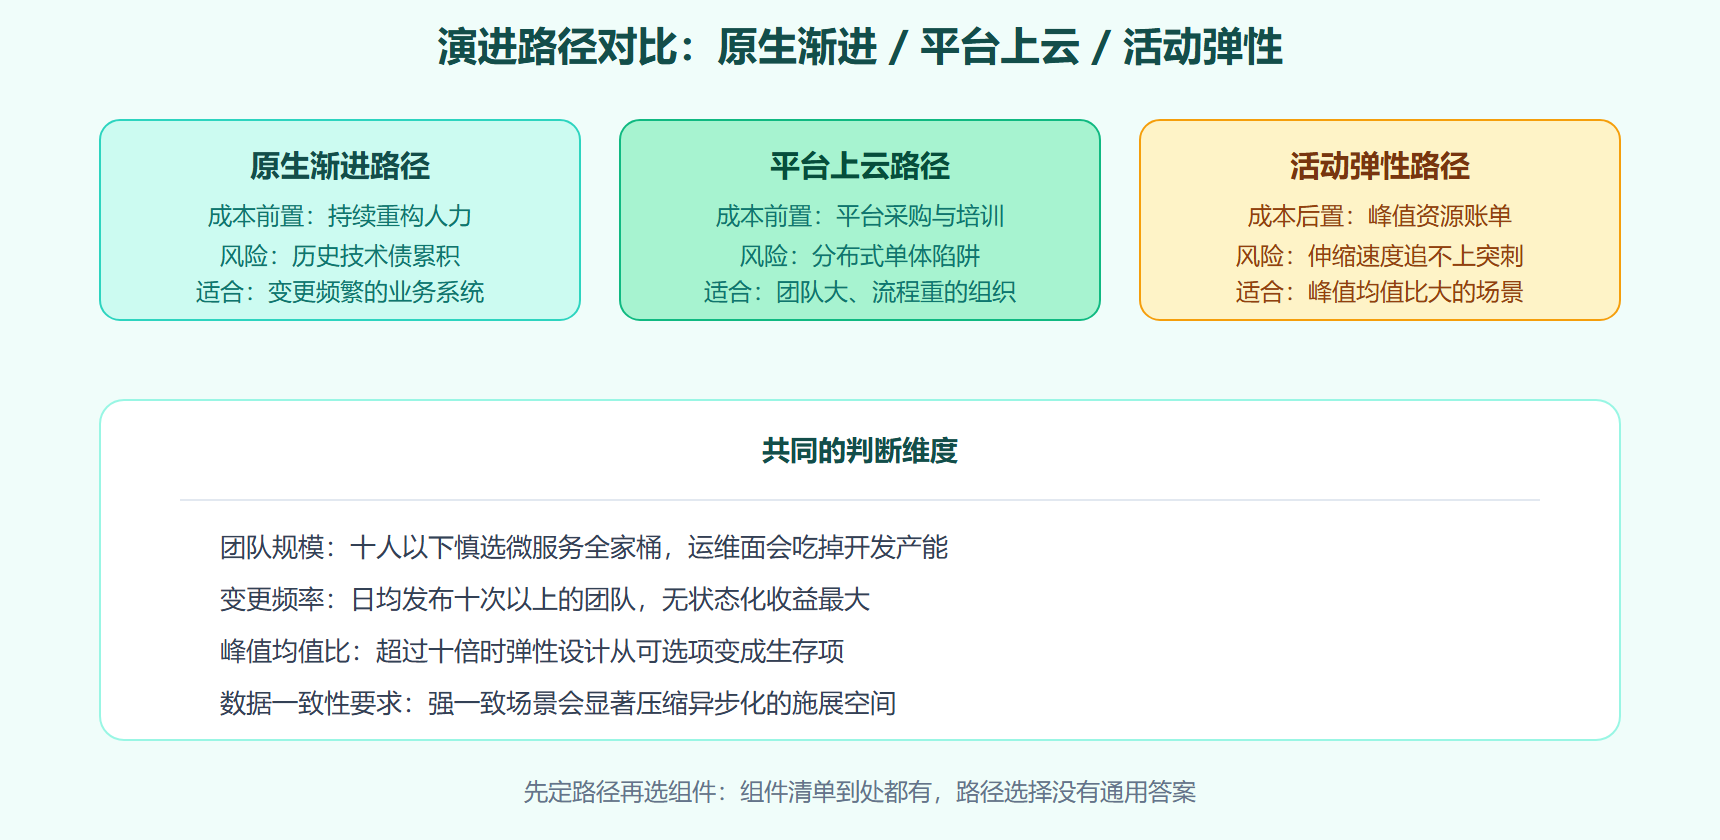
同样是"扛高并发",不同起点的团队走的路径差别很大,对比着看能避免生搬硬套。互联网原生团队多从"单体加缓存"起步,痛点驱动逐步拆分,优势是每一步都有真实流量验证,劣势是容易背上历史包袾示的技术债。传统企业上云团队常直接从微服务起手,用平台化的容器和中间件开局,优势是起点规范,劣势是团队心智没跟上时,微服务变成"分布式单体"——拆了服务却共享数据库,故障域一点没缩小。还有一种"活动驱动"路径,典型如电商大促,按峰值租用弹性资源,平时缩容,这要求架构在一开始就为无状态和快速伸缩设计。
三条路径没有优劣,但成本结构完全不同:原生路径的人力成本前置在重构上,上云路径的成本前置在平台采购和学习曲线上,活动路径的成本在弹性资源的峰值账单里。选路径前先看清自己的约束——团队规模、变更频率、峰值与均值流量比,这三个变量基本能锁定适合的路径。下面的对比图把三条路径的关键差异铺开,可以作为团队内部讨论的底稿。
图:三条演进路径的成本与风险对比
顺带说明本章和后续各章的分工:本章负责"为什么、什么时候",后面各章负责"怎么做"。读本章时不必纠结具体组件的参数,把注意力放在判断框架上——量级感知、演进节奏、指标口径这三样是贯穿全书的地基。学完后面章节再回看本章,你会对"每个技术动作对应哪个量级问题"有更立体的把握,这也是我们把定位与演进单独成章的原因:工具会换,判断力不会过期。
最后补一句心态提醒:量级判断会随业务增长过期,去年成立的容量结论今年可能已经踩线。把本章的判断框架连同当前量级一起写进架构文档,每半年复核一次,让"我们是什么量级的系统"始终有一个最近更新的答案——这个看似琐碎的习惯,能在无数次方案评审里替你挡下拍脑袋的决定。
再补充一个本章自测清单:读完 1.1 你应该能不查资料说出自己系统的峰值 QPS、P99 和可用性数字;读完 1.2 你应该能画出系统从单体到当前形态的演进时间线,并标注每次演进的真实触发事件。两样都做得到,定位与演进的功课就扎实了;做不到的话,数字去监控里查、时间线去变更记录里翻——查找的过程本身就是一次有价值的盘点。
这两个自测不只是练习,更是团队知识管理的起点:峰值数字汇入容量档案,演进时间线汇入架构决策记录,两份文档持续更新下去,一年后就是新成员培训和晋升答辩里最有分量的素材。