第1章 · 对抗机器学习基础理论
第 1 章 · 对抗机器学习基础理论
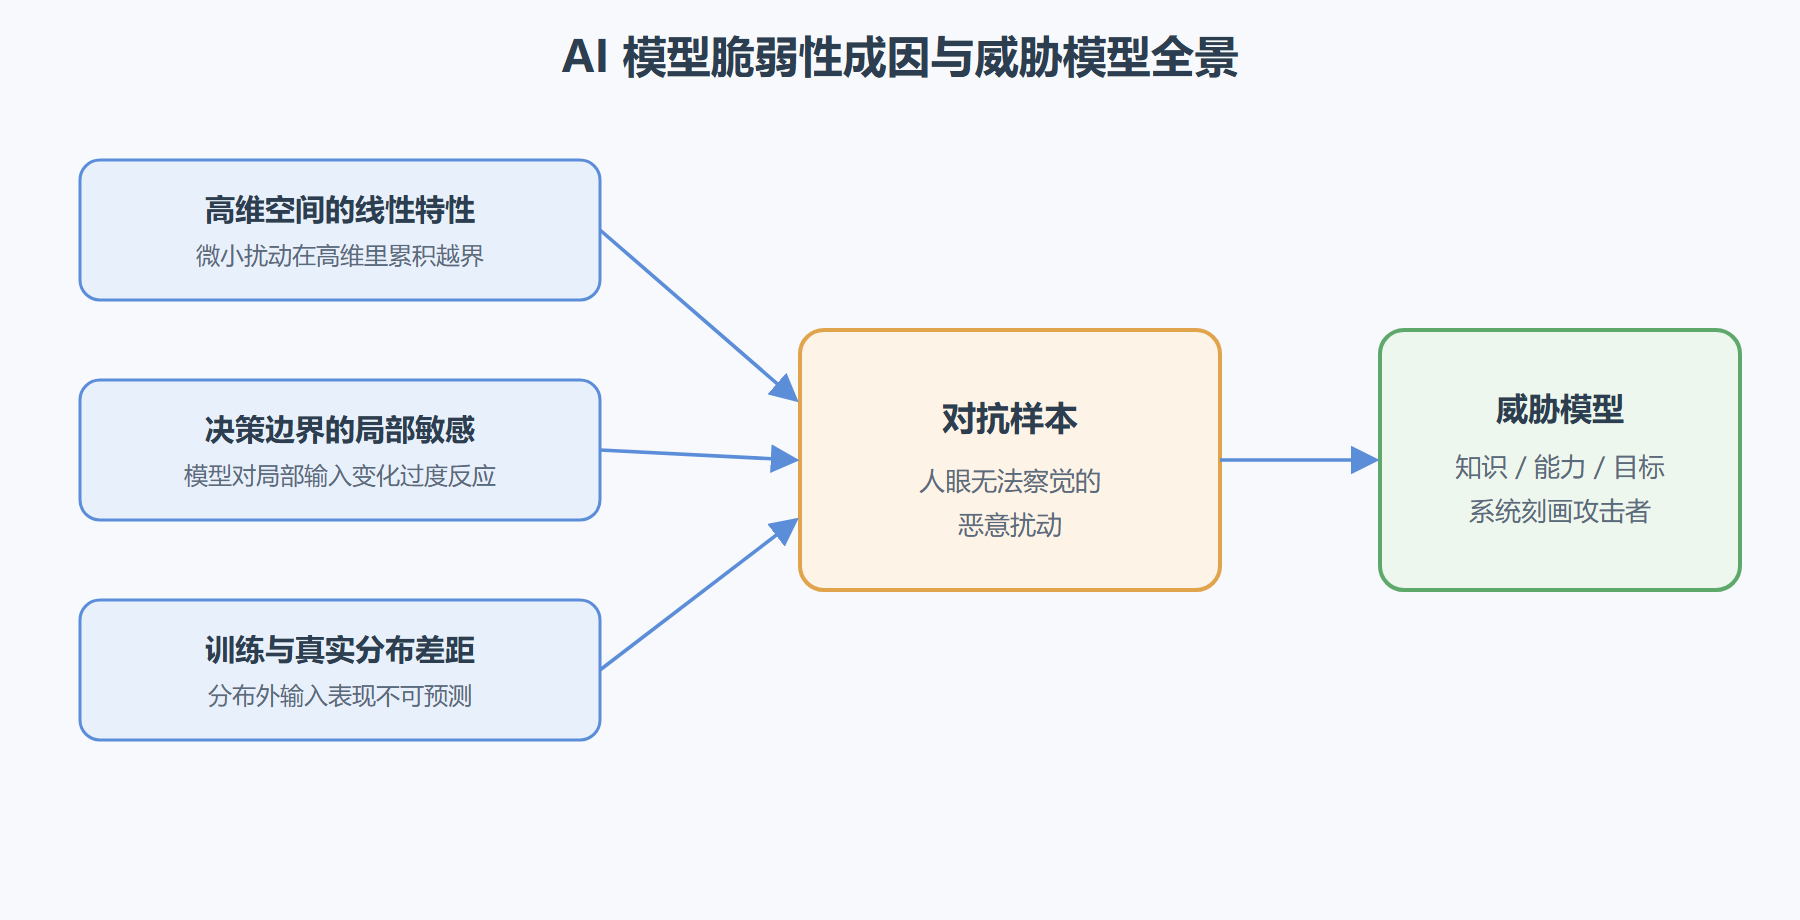
章节摘要:在讲具体攻防技术前,先建立对"模型脆弱性"的根本认知。这一章讲两件事:一是 AI 系统为什么会被对抗样本欺骗——根源在于高维空间的线性特性、模型的局部敏感、以及训练分布与真实分布的差距;二是怎么系统地描述威胁——威胁模型(攻击者知道什么、能做什么、目标是什么)是评估和防御的前提,攻防分类(白盒/黑盒/灰盒、定向/非定向、毒化/逃避)帮助我们理解不同攻击的全貌。建立这套认知后,后面章节看具体攻防技术就有框架可依。
阅读收获
阅读完本章,你应当能够:
- 解释对抗样本现象的几个理论根源(线性假设、高维空间、局部敏感)
- 说清为什么"测试集高准确率"不等于"模型鲁棒"
- 描述威胁模型的三个维度(知识、能力、目标)
- 区分白盒、黑盒、灰盒攻击的攻击者能力假设
- 用攻防分类框架描述一个具体攻击
这五条目标层层递进:前两条建立"问题在哪、为什么"的认知,中间两条建立"怎么描述、怎么分类"的框架,最后一条要求你能把框架用起来分析真实案例。如果读完还能拿一个公开的攻击案例(比如某次自动驾驶被对抗贴纸欺骗的新闻)准确说出它落在哪个分类象限,说明这章真的吃透了。
核心概念速览
对抗机器学习的第一原则:模型不是"被攻击才有漏洞",而是"本来就有漏洞,攻击只是暴露了它"。理解漏洞的根源,比记住几个攻击算法更重要。
图 1-1:AI 模型脆弱性成因与威胁模型全景
子章节导航
1.1 AI系统的脆弱性根源
讲深度学习模型为什么会被对抗样本欺骗。从高维空间的线性特性、决策边界的局部敏感、训练分布与真实分布的差距三个角度,解释脆弱性的理论根源。这一节会打破"模型准确率高就等于理解了任务"的错觉,让你看清高准确率背后藏着的脆弱统计依赖。
1.2 威胁模型与攻防分类
建立系统描述威胁的框架。威胁模型从知识(白盒/黑盒/灰盒)、能力(能改输入还是能改训练数据)、目标(定向/非定向)三个维度刻画攻击者;攻防分类把林林总总的攻击归到几个清晰的类别。这套框架是后续所有具体攻防技术的坐标系,没有它,论文和新闻里满篇的"白盒""黑盒""迁移攻击"会让你无从对照。
子章节之间的逻辑关系
先理解"为什么脆弱"(1.1,根源),再建立"怎么描述威胁"的框架(1.2,分类)。前者回答"问题从哪来",后者回答"怎么系统地看待问题"。两者合起来是对抗机器学习的基础认知。
1.1 脆弱性根源 ──► 1.2 威胁模型与分类 (为什么有漏洞) (怎么描述漏洞)
贯穿本章的关键问题
读这一章时,建议带着三个问题去找答案,这样比平铺直叙地读完收获更大。
第一,"模型的准确率和高维空间的线性有什么关系?"这个问题会引出 Goodfellow 的线性假说——高维空间里,即便每个维度的扰动很小,累积起来也足以把输入推出决策边界。理解这一点,你就明白为什么对抗样本不是玄学,而是高维几何的必然结果。
第二,"测试集准确率为什么不等于鲁棒性?"测试集只覆盖了自然分布,而对抗样本恰恰来自自然分布之外的方向。一个在测试集上 99% 的模型,可能在这些"没见过的方向"上脆弱得不堪一击。这个认知会让你在评估模型时多一个心眼:别被漂亮的成绩单骗了。
第三,"威胁模型三个维度(知识、能力、目标)的组合怎么对应到现实攻击?"比如攻击一个公开 API,通常对应黑盒加逃避加非定向的组合;而内部人员植入后门,对应的是灰盒加投毒加定向。把抽象维度映射到具体场景,威胁模型才不会停留在纸面。
前置知识与后续延伸
前置知识与后续延伸
- 前置知识:对深度学习的基本概念(神经网络、训练、损失函数、梯度)有了解即可。
- 后续延伸:本章是总论。第 2 章具体讲攻击者怎么利用这些脆弱性(攻击算法),第 3 章讲怎么防御。
读这一章最容易踩的几个坑
基础理论部分有几个反复让人栽跟头的认知误区,提前点出来能少走弯路。
坑一:以为对抗样本是"bug"而非"特性"。 很多人第一反应是把对抗样本当成模型实现的缺陷,觉得"修一下就好了"。但后续章节会反复说明,对抗脆弱性根源在于高维线性几何和学习目标本身——只要模型还在用梯度下降学统计模式,这种脆弱性就难以根除。把它当成"要修的 bug"会导致防御思路跑偏(总想找捷径),而把它当成"要管理的特性"才会走向正确的对抗训练路线。
坑二:把威胁模型当成贴标签。 威胁模型的真正价值不在分类本身,而在于它逼你想清楚"我的资产是什么、攻击者是谁、后果多重"。如果一个团队只会在报告里写"我们采用了黑盒威胁模型"却说不清为什么是这个模型、有没有漏掉灰盒和投毒场景,那这个框架就成了摆设。
坑三:混淆"对抗样本"和"数据噪声"。 普通的标注噪声或传感器噪声是随机的,模型对它们本来就有一定容忍度。对抗样本的可怕之处在于它是精心构造的、有方向性的,专门针对模型的弱点。两者从统计性质到防御方法都完全不同,别因为"我的模型对加噪挺鲁棒"就以为它扛得住对抗攻击。