7.3 时变系统与信息年龄:时效的重量
7.3 时变系统与信息年龄:时效的重量
本节摘要:定义信息年龄——接收端持有的信息自产生以来流逝的时间;用排队系统仿真展示"更新太慢则陈旧、太快则拥塞"的 U 形权衡;检阅为新鲜度重新设计的调度策略(包丢弃、后到先服务、零等待)与信息年龄在时变信道、能量收集等场景的扩展。
自动驾驶的车为什么在意"几秒前"
自动驾驶车队里,每辆车都在广播自己的位置与速度。设想接收端刚解码了一条消息——不幸它是三秒前产生的,期间前车已经急刹。这条消息比特无误、内容精确,但对决策毫无价值。传统的吞吐与时延指标都无法刻画这种失效:时延只量单条消息在系统里待了多久,不问"最新的那条有多旧"。二零一二年前后的研究者为此铸造了新砝码——信息年龄:接收端当前持有的最新信息,自它在信源端产生以来流逝的时间。
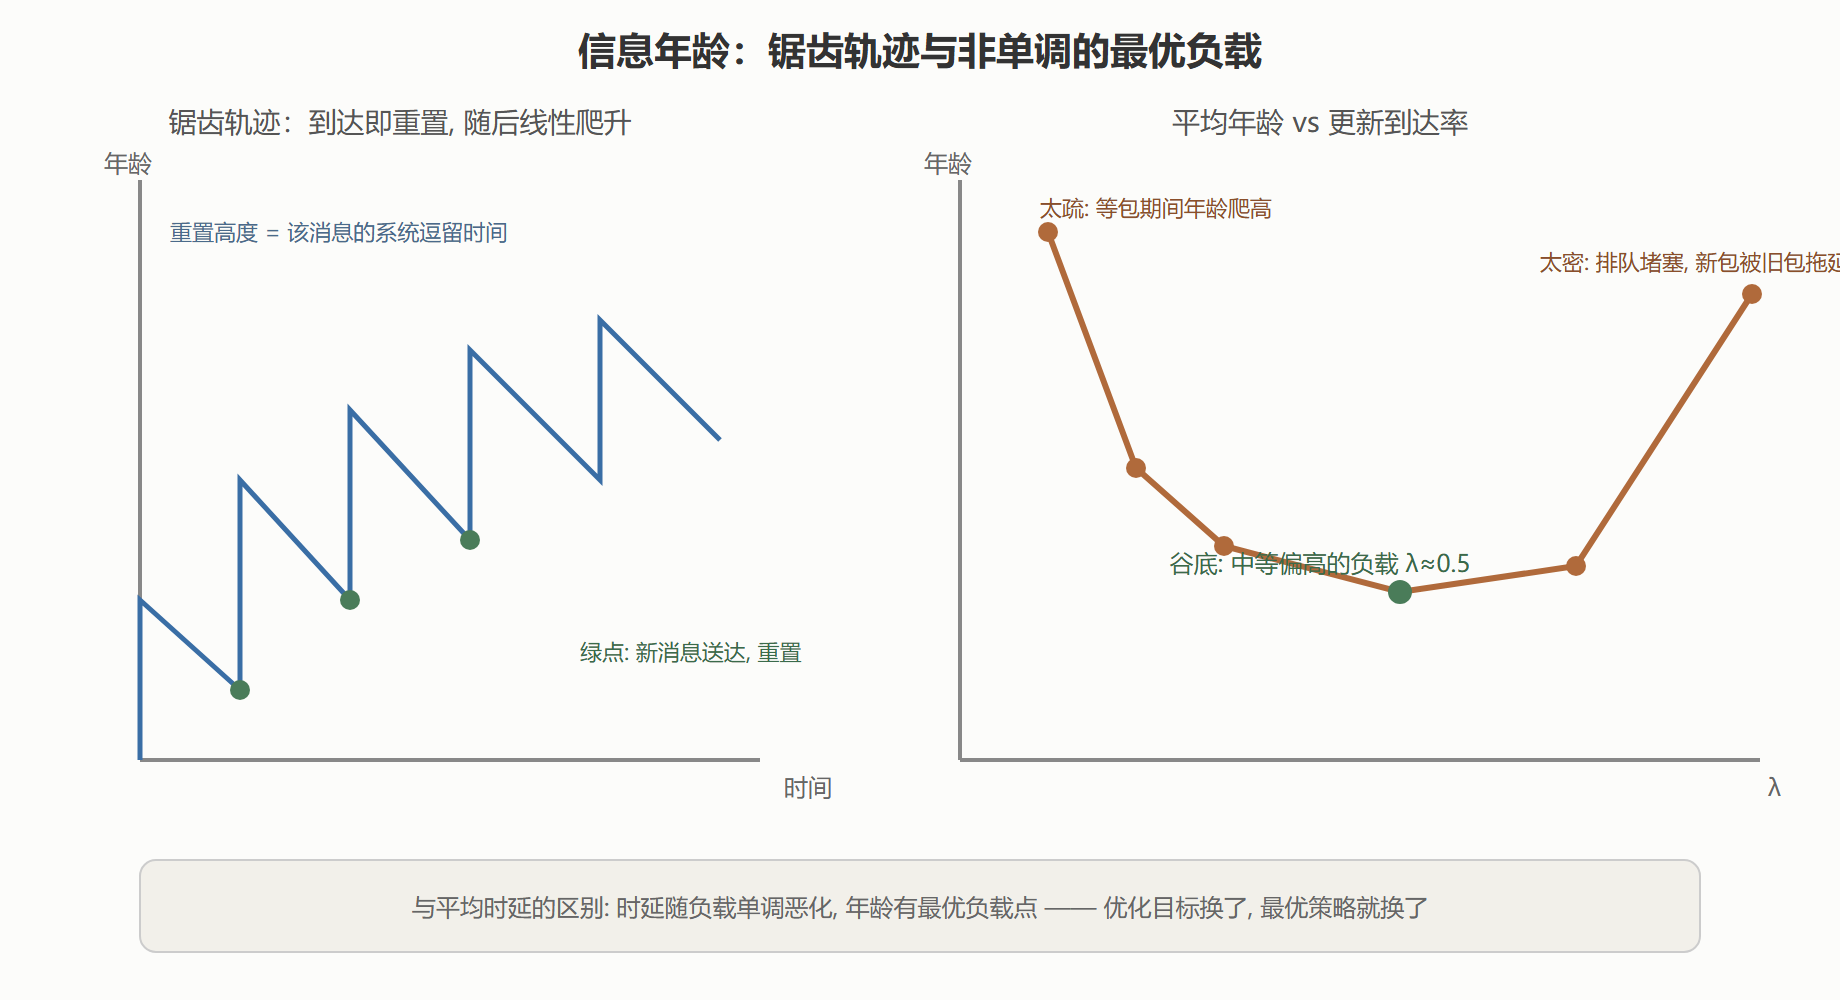
年龄的轨迹是一张锯齿图:消息到达接收端时,年龄瞬间重置为该消息的系统逗留时间(产生到送达的时长);随后随时间线性爬升,直到下一条更新的消息到达。要优化的量是这张锯齿的时间平均(平均年龄)或峰值(最坏时刻的陈旧度)。它与吞吐、时延都不同构——这正是新度量存在的理由。
U 形权衡:太懒太勤快都不行
直觉的坑在这里:想让信息新鲜,是不是更新得越频繁越好?排队论立刻反驳——更新包发得太密,前面积压成队,每条包出来时都已陈旧;发得太疏,等包的时间本身让年龄爬高。年龄对到达率的关系是 U 形的,用 M/M/1 排队系统的仿真可以直接量出这条曲线。
# M/M/1 先到先服务队列的平均信息年龄仿真 import random import collections def average_age(lam, mu=1.0, T=200000, seed=5): """lam 到达率, mu 服务率; 返回平均信息年龄(时间平均)""" random.seed(seed) arrivals, departures = [], [] busy_until, next_arr = 0.0, random.expovariate(lam) while next_arr < T: arrivals.append(next_arr) depart = max(next_arr, busy_until) + random.expovariate(mu) departures.append(depart) busy_until = depart next_arr += random.expovariate(lam) events = [(a, 1) for a in arrivals] + [(d, -1) for d in departures] events.sort() queue = collections.deque(arrivals) area, prev, last_gen = 0.0, 0.0, 0.0 for t, kind in events: if t > T: break dt = t - prev area += (prev - last_gen) * dt + 0.5 * dt * dt # 锯齿的精确积分 prev = t if kind == -1: last_gen = queue.popleft() # 新消息送达, 年龄重置 dt = T - prev area += (prev - last_gen) * dt + 0.5 * dt * dt return area / T print("到达率 λ 平均信息年龄") for lam in [0.1, 0.2, 0.3, 0.5, 0.7, 0.9]: print(f" {lam:<7} {average_age(lam):6.2f}") # 输出: # 到达率 λ 平均信息年龄 # 0.1 11.01 # 0.2 6.07 # 0.3 4.46 # 0.5 3.50 # 0.7 4.03 # 0.9 9.72
曲线的 U 形一目了然:到达率从零点一提到零点五,年龄从十一降到三点五——更新更勤确实更鲜;继续加到零点九,年龄反弹回九点七——队伍排起来了,新消息被旧消息堵在后面,出来时早已过时。谷底落在中等偏高的负载处(本例零点五附近),且对服务率的变化敏感。这个非单调性是信息年龄区别于时延的招牌性质:平均时延随负载单调恶化,年龄却有自己的最优负载点——优化目标换了,最优策略跟着换。
年龄的锯齿轨迹与 U 形权衡
为新鲜度重新设计的队列
既然最优策略随目标改变,整个排队设计的工具箱都要翻新。三个例子各有代表性。
包丢弃策略:队列已满时丢掉最旧的包(而不是拒绝新包)。直觉上"丢数据"是坏事,但对年龄恰恰相反——旧包的价值随年龄衰减,留着它们只会堵路;给新包让位等效于"用丢弃换新鲜"。仿真与理论都确认:在高负载下,丢弃式队列的年龄远优于先到先服务。
后到先服务:服务器空闲时挑队列里最新的包先处理。同样的道理——最新的包最有希望在"还新鲜"时送达,旧包即使处理完也早已过时。先到先服务对平均时延是公平的,对年龄则是灾难性的错配。
零等待策略:信源可以控制何时采样时,最优方案往往是"系统一空就采、立即发送"——让每个包都赶在无队时期出发,逗留时间最小,重置点最低。这在远程状态估计(传感器采样时机选择)里是标准结论。
这些策略的共同逻辑:把"价值随时间衰减"写进调度准则。经典排队论的最小化目标(时延、阻塞率)不感知年龄,信息年龄视角把价值函数与时间耦合起来,整个优化问题的结构随之改变——这也是它迅速渗透进远程控制、在线学习样本更新、缓存刷新等场景的原因。
扩展版图与时变信道
信息年龄的框架还在扩张。峰值年龄版本关心最坏时刻(安全攸关场景);年龄的函数价值进一步问"旧信息到底差多少"——状态变化慢时旧信息照样好用,年龄的价值函数应当贴着状态动态定义;多跳网络里每跳的调度相互耦合,年龄的分布分析变得困难而活跃。时变信道侧,机会式调度要在"信道好"与"信息旧"之间权衡——信道差时硬发浪费能量且错误率高,不如等信道恢复,但等待本身让年龄增长;能量收集系统(靠环境供电的物联网)里,发或不发还要看电量水位,年龄-能量联合优化成了独立的研究支线。
⚠️ 常见坑:拿平均时延的结论套年龄问题。增大缓冲、增大吞吐、公平排队这些在时延语境下的"好属性",对年龄可能是反效果(缓冲让旧包滞留)。为年龄做设计时,先问一句"这个策略让最新信息更快到达了吗",再问吞吐。
年龄度量的标准化动向
信息年龄从二零一二年前后的学术概念,到近年进入标准讨论的视野,路径值得记录。远程工业控制(周期性上报传感器状态的场景)在标准组织里被建模为"年龄受限的更新流"——规格书里"状态信息不得陈旧超过某阈值"的写法,就是峰值年龄约束的工程语言。车联网的基本安全消息也用类似口径评估:广播频率的选取不再是拍脑袋的配置项,而是"峰值年龄约束下的最小发送频率"优化解。度量先于优化、优化先于标准——信息年龄用十年走完了吞吐与容量在二十世纪走过的路,这个节奏本身就是理论产业化的标准速度。
本节要点回顾
- 信息年龄度量"接收端最新信息自产生以来流逝的时间",锯齿轨迹的时间平均是核心指标,与吞吐、时延均不同构;
- U 形权衡是招牌性质:更新太疏则年龄爬高,太密则排队拖延新包——最优负载在中等偏高处,仿真谷底清晰可见;
- 三类新鲜度优先策略——丢旧包、后到先服务、零等待采样——共同逻辑是把"价值随时间衰减"写进调度准则;
- 扩展版图包括峰值年龄、价值的函数化、多跳耦合、时变信道的机会调度与能量收集联合优化;
- 设计警句:时延语境的好属性(大缓冲、公平排队)在年龄语境可能是反效果,优化目标换了策略就要换。
三扇门走完,疆界巡礼结束。下一章回到大地上的应用场:深空、存储、机器学习与密码学,四块场地如何各自兑现这套称量科学。