9.2 设计最佳实践与实验基准
9.2 设计最佳实践与实验基准
本节摘要:把"先称后做、以差验收"的循环落成守则——上限预算与余量科目化的设计纪律、蒙特卡洛的置信区间速查、基准曲线的三个必读区(瀑布、地板、收敛);附一张设计检查清单与仿真卫生守则。
先算上限,再画方案
信息论工程师与其他工程师的分界线,在于动手前是否先算理论读数。设计一条链路,第一步不是选调制方案,而是把香农-哈特利上限算出来贴在方案首页——所有后续方案的成绩都以"离上限几分贝"计价。同样,设计一个压缩器,先估信源熵率(第 9.1 节的工具),压缩比的验收线就是实测码长对熵率的比例;设计纠错方案,先算当前信道容量,码率的可行域立即显形。这一步的成本是几分钟的演算,收益是把"感觉不错"翻译成"差多少"——没有上限的设计评审只是品味讨论。
余量科目化是上限纪律的下半句。理论与实现的差距不是笼统的"打个折",而是可拆解的科目:信道估计误差、实现损耗(滤波器非理想、量化精度)、编码余量(有限码长对渐近极限的距离)、衰落余量(对抗小尺度衰落的储备)、干扰余量(非白噪声环境)。每科目各自定值、各自验证——验收时哪一科目超支,改哪一科目,而不是整体加功率了事。第 8.1 节链路预算里"理论上限八点七、实际六到七"的差距,正是这几个科目的合计。
仿真的置信区间纪律
蒙特卡洛仿真是信息论工程的主要实验手段,它的可信度由统计纪律保证。核心是置信区间宽度速查:估计一个概率为 p 的量(误码率、中断率),N 次独立试验下估计值的标准差约为根号下 p 乘一减 p 除以 N——要可信地报告一个千分之一量级的误码率,需要多少样本?
# 蒙特卡洛置信区间宽度速查(估计误码率 p = 0.001) from math import sqrt p = 0.001 for N in [10_000, 100_000, 1_000_000, 10_000_000]: half_width = 1.96 * sqrt(p * (1 - p) / N) # 95% 置信区间半宽 print(f"N = {N:>10,}: 95% 置信区间 ± {half_width:.5f}" f"(相对误差 ± {half_width / p * 100:.1f}%)") # 输出: # N = 10,000: 95% 置信区间 ± 0.00062(相对误差 ± 61.9%) # N = 100,000: 95% 置信区间 ± 0.00020(相对误差 ± 19.6%) # N = 1,000,000: 95% 置信区间 ± 0.00006(相对误差 ± 6.2%) # N = 10,000,000: 95% 置信区间 ± 0.00002(相对误差 ± 2.0%)
速查表藏着一个残酷事实:估计再小的概率,相对误差只由"期望事件次数"决定。万次试验期遇十次事件,相对误差约六成;百万次试验期遇一千次事件,相对误差仍有百分之六——想让相对误差降到百分之二,期遇事件数要上万。低误码率曲线(十的负六次方以下)靠直接仿真代价高昂,工程上的出路是重要性采样(人为放大错误事件再加权还原)或外推法(高误码率区拟合瀑布斜率再外推)——知道边界在哪,才不会把外推当实测。
⚠️ 常见坑:报告单点数字不报区间。两个仿真结果差百分之十五,在期遇事件数不足时完全是噪声波动,却被当成方案优劣写进结论。纪律只有一条:每个数字旁边写上它的置信区间,区间重叠的比较不作数。
基准曲线的三个必读区
纠错方案的标准成绩单是"误码率对信噪比"的曲线(对数纵轴)。读这张图要分三段,每段回答一个不同的问题。
误码率曲线的三段式读法
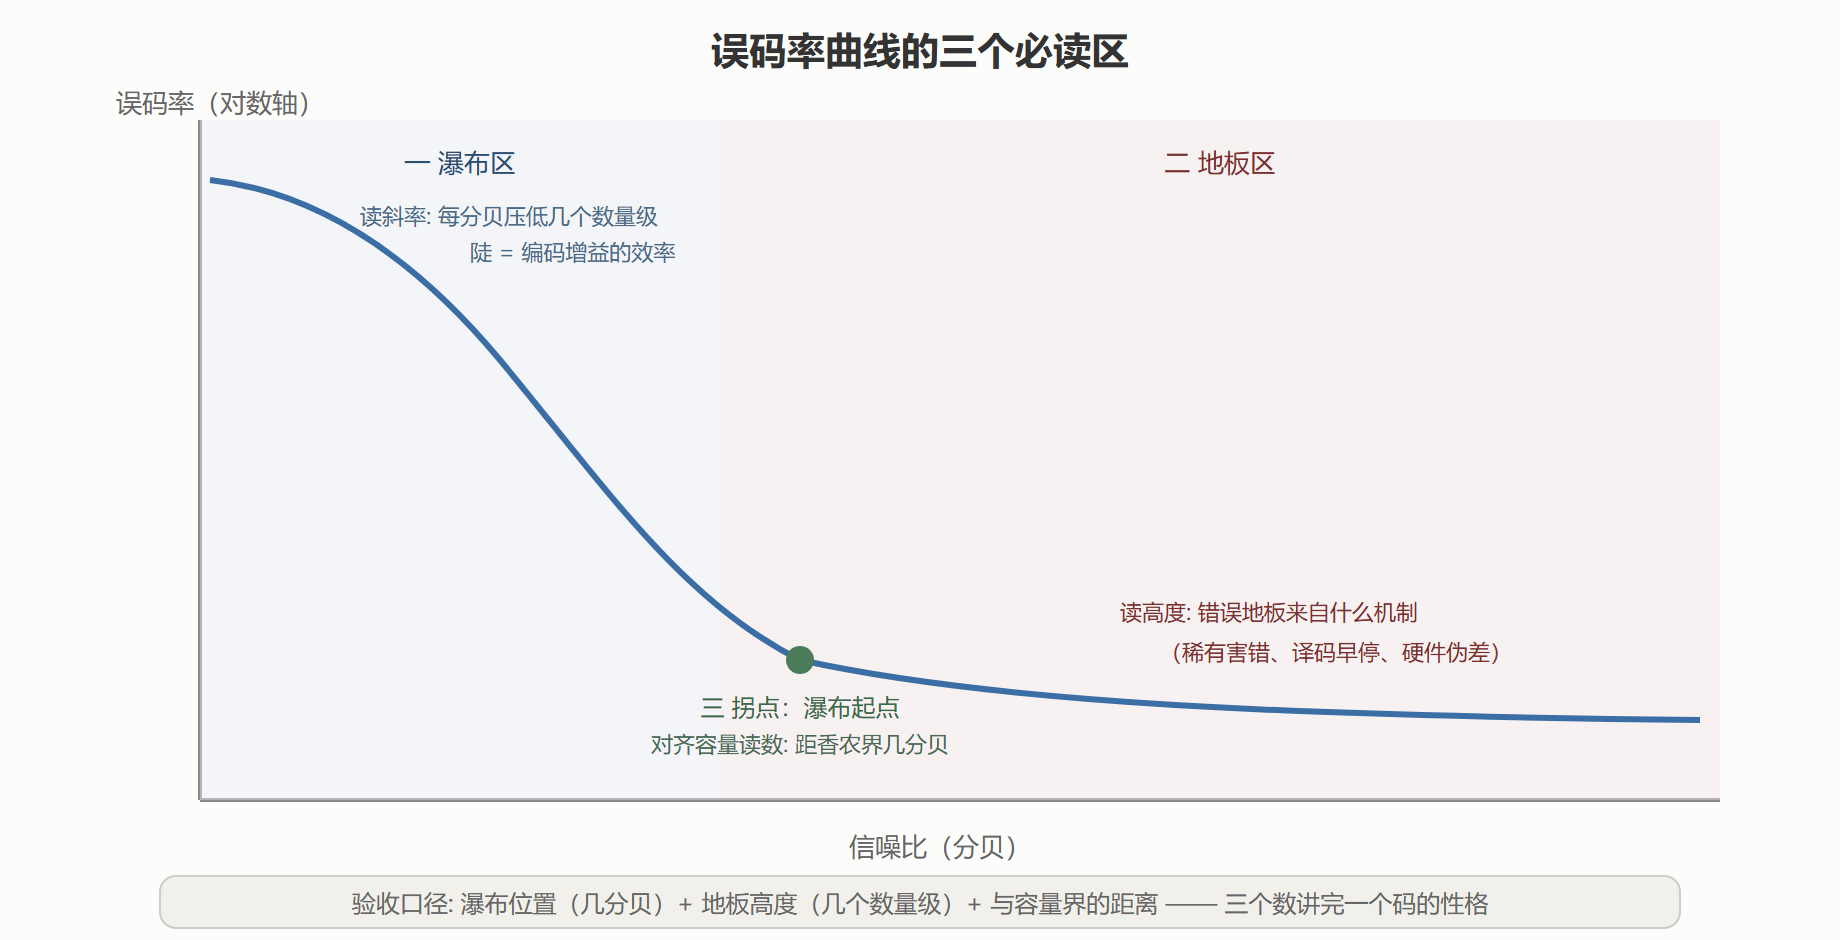
瀑布区回答"增益效率":曲线每分贝压低多少个数量级的误码率,陡峭程度反映迭代译码的收敛锋利度——turbo 与 LDPC 的招牌就是近乎垂直的瀑布。拐点位置回答"离极限多远":瀑布起点相对容量界需要几分贝——这是与理论对话的锚点,第 4 章那场"逼近容量"的六十年赛跑,记分牌就是这几分贝。地板区回答"最坏情况":曲线在高信噪比区趋平不再下降,来自稀有害错序列、译码早停或实现缺陷——地板高度决定方案能否用于要求极低误码率的场景(存储、光纤),也常是论文实验图与产品规格表打架的地方。
基准实验的另一条纪律是控制变量:比较两个方案时,码长、码率、信道模型、译码迭代数、甚至随机种子集合都要对齐——任何一项不对齐,曲线间的差距就归因不了。多种子重复并报告方差(上一节的区间纪律),是最后一块拼图。
设计检查清单
| 阶段 | 检查项 | 不过怎么办 |
|---|---|---|
| 立项 | 理论上限已算出并写进方案(容量/熵率/失真界) | 补演算,没有上限不开工 |
| 预算 | 余量分科目(估计误差/实现损耗/编码余量/衰落/干扰) | 拆不开的余量重新审 |
| 方案 | 操作点在上限下方留安全距离 | 贴线方案重估风险 |
| 仿真 | 每个数字附置信区间;边界自检通过 | 加样本或换方法 |
| 基准 | 瀑布位置、地板高度、与容量界距离三个数齐全 | 补齐再评审 |
| 验收 | 实测与预算的差距能归因到具体科目 | 归因不了就回去测 |
这份清单浓缩自本册各章:第 4 章的容量纪律、第 5 章的余量与自适应、第 8 章的预算科目、第 9.1 节的估计偏差与自检。它不保证方案成功,但保证失败时知道挂在哪一科——工程成熟度的标志从来不是不出问题,而是问题出现时能定位。
低误码率的仿真经济学:三种提速手段
置信区间纪律宣布了直接仿真的高价之后,工程实践长出了三条降价路线,各有适用前提与代价。
重要性采样:人为提高错误事件的发概率(给噪声加偏置),跑出足够样本后按权重还原真实概率。诀窍是"把算力花在稀有事件上"——对瀑布区极陡的码,加速比可达几个数量级;代价是偏置分布的设计依赖对错误机理的理解,设计不当反而引入难以察觉的偏差。它适合验证"机制已知"的稀有错误。
外推法:在可负担的误码率区间(比如十的负三次方到十的负五次方)拟合曲线族的形状参数,再按拟合外推到十的负八次方。前提是误码机理在两个区间不切换——瀑布区外推通常可靠(同一译码失败机制主导),跨过错误地板再外推则纯属迷信。外推结果在报告里必须显式标注为外推,与实测点分开画线。
半解析法:把有闭式解的部分解析算掉(比如条件误码率对噪声分布的积分),只对随机性残余(交织、衰落)做仿真。适用于结构规整的系统,能把仿真维度砍掉一半以上。
三条路线共同的纪律是标定:先在可直接仿真的区间验证方法本身(重要性采样在中等概率区还原真实值、外推线穿过已有的实测点),再向低概率区推进。没有标定的加速方法比慢更危险——它给出"看起来精确"的错误数字。
基准实验的完整清单:从种子到结论
把散落各处的纪律收拢成一份可以照着做的操作单。事前:固定并记录所有超参数(码长、码率、迭代数、信道参数、随机种子集合);对齐比较基线(相同码率下比较,或按频谱效率归一);预注册判读标准(哪个指标、什么阈值算优)。事中:每组配置至少五个种子;边界自检先行(零信噪比无误码为零、高信噪比无误码收敛);长跑任务断点续跑。事后:区间与方差随数字附上;曲线族分清实测与外推;差距归因到科目(实现、估计、编码、余量)。这份清单多数条目来自本册的教训集合——每一条都对应一类真实发生过的事故。
本节要点回顾
- 先算上限再设计:容量、熵率、失真界先贴在方案首页,一切成绩以"离上限多少"计价;
- 余量科目化:估计误差、实现损耗、编码余量、衰落、干扰各自定值各自验收,超支改科目而不是加功率;
- 蒙特卡洛相对误差由期遇事件数决定:期遇十次事件误差约两成,降到百分之五需要期遇上万次;低误码率用重要性采样或外推,且不把外推当实测;
- 基准曲线三段读法:瀑布区看增益效率、拐点对齐容量界、地板区看最坏情况——三个数讲完一个码的性格;
- 控制变量与区间纪律是基准实验可信度的底线,单点无区间的比较不作数。
守则交毕。下一节看向正在发生的变化:当接收端是模型、资源按任务计价时,通信的度量衡如何从比特迁往含义。