9.4 开放问题与未来趋势
9.4 开放问题与未来趋势
本节摘要:清点信息论尚未称出的东西——网络与干扰信道的容量难题、量子容量的计算困境、语义信息的公理化缺口、高维互信息估计的统计难关、新介质与新拓扑带来的信道建模问题;每个问题附一句"难在哪",并给出一幅前沿雷达图与三条趋势判断。
尚未称出的东西:一张分领域清单
一套科学的生命力最诚实的指标,是它还没解决的问题的质量。本册讲到的每个"目前只解决了特殊情形",都是一张待兑付的支票。
网络信息论的两大钉子户。一般中继信道的容量:物理退化情形有解(第 6 章),一般情形悬置至今——难点在于中继的收发在同一节点耦合,"听到的"与"要发的"相互纠缠,经典的单向信息流分析工具失效。干扰信道的容量区域:两个收发对互相干扰,已知最好方案与最好界之间仍有缝隙——多用户信息论的"容量区域"语言在这里写不出闭式。量子侧的算不动。一般量子信道的容量计算是非凸优化,已知结论集中在退化与对称信道;容错量子计算的错误率阈值已从理论走向工程,但"阈值究竟能放宽到哪"随码与硬件共同演进——理论要追着实验跑。语义侧的没定义。语义熵的等价类构造依赖任务与知识库,普适刻度缺位(上一节的软肋);"信息的价值"要嫁接决策论,但决策论与信息论的度量体系尚未真正合账。统计侧的估不准。高维低样本下的互信息估计没有无偏低方差的一揽子方案——深度学习理论急需这个工具(第 8 章的信息瓶颈分析受制于此),估计理论与表征理论在互相等待。新介质的新信道。分子通信(纳米机器间以化学浓度传信)的噪声模型与容量、可重构智能表面(给无线环境"装上反射镜")的信道建模、无人机群的时变拓扑——每换一种介质,容量-失真-约束三张答卷都要重答(第 8.2 节 DNA 存储的演习逻辑在此放大)。
把这份清单再展开一层,几个"缝隙"值得点名。反馈容量的非沉默:第 5 章说无记忆信道反馈不扩容量,但有记忆信道(比如带状态的信道)的反馈容量可以严格大于无反馈——最优反馈策略的显式刻画至今只在少数模型上完成,"状态信息什么时候值得反馈"是自适应系统的理论根基。有限块长信息论:渐近定理给的是极限读数,现实系统的块长有限(低时延场景尤其短),有限块长的最大可达速率有近似公式(_dispersion 展开系数_决定"距容量的惩罚随块长平方根倒数衰减"),但多用户与非理想信道下的有限块长刻画远未完成——这恰是五 G 超可靠低时延通信设计每天要用的工具。信息论与因果:互信息不辨方向(第 2 章),因果推断另起炉灶——两个"度量关联"的体系至今没有公认的合账方式,谁先打通谁就补上一块版图。
前沿雷达:五个方向的位置与成熟度
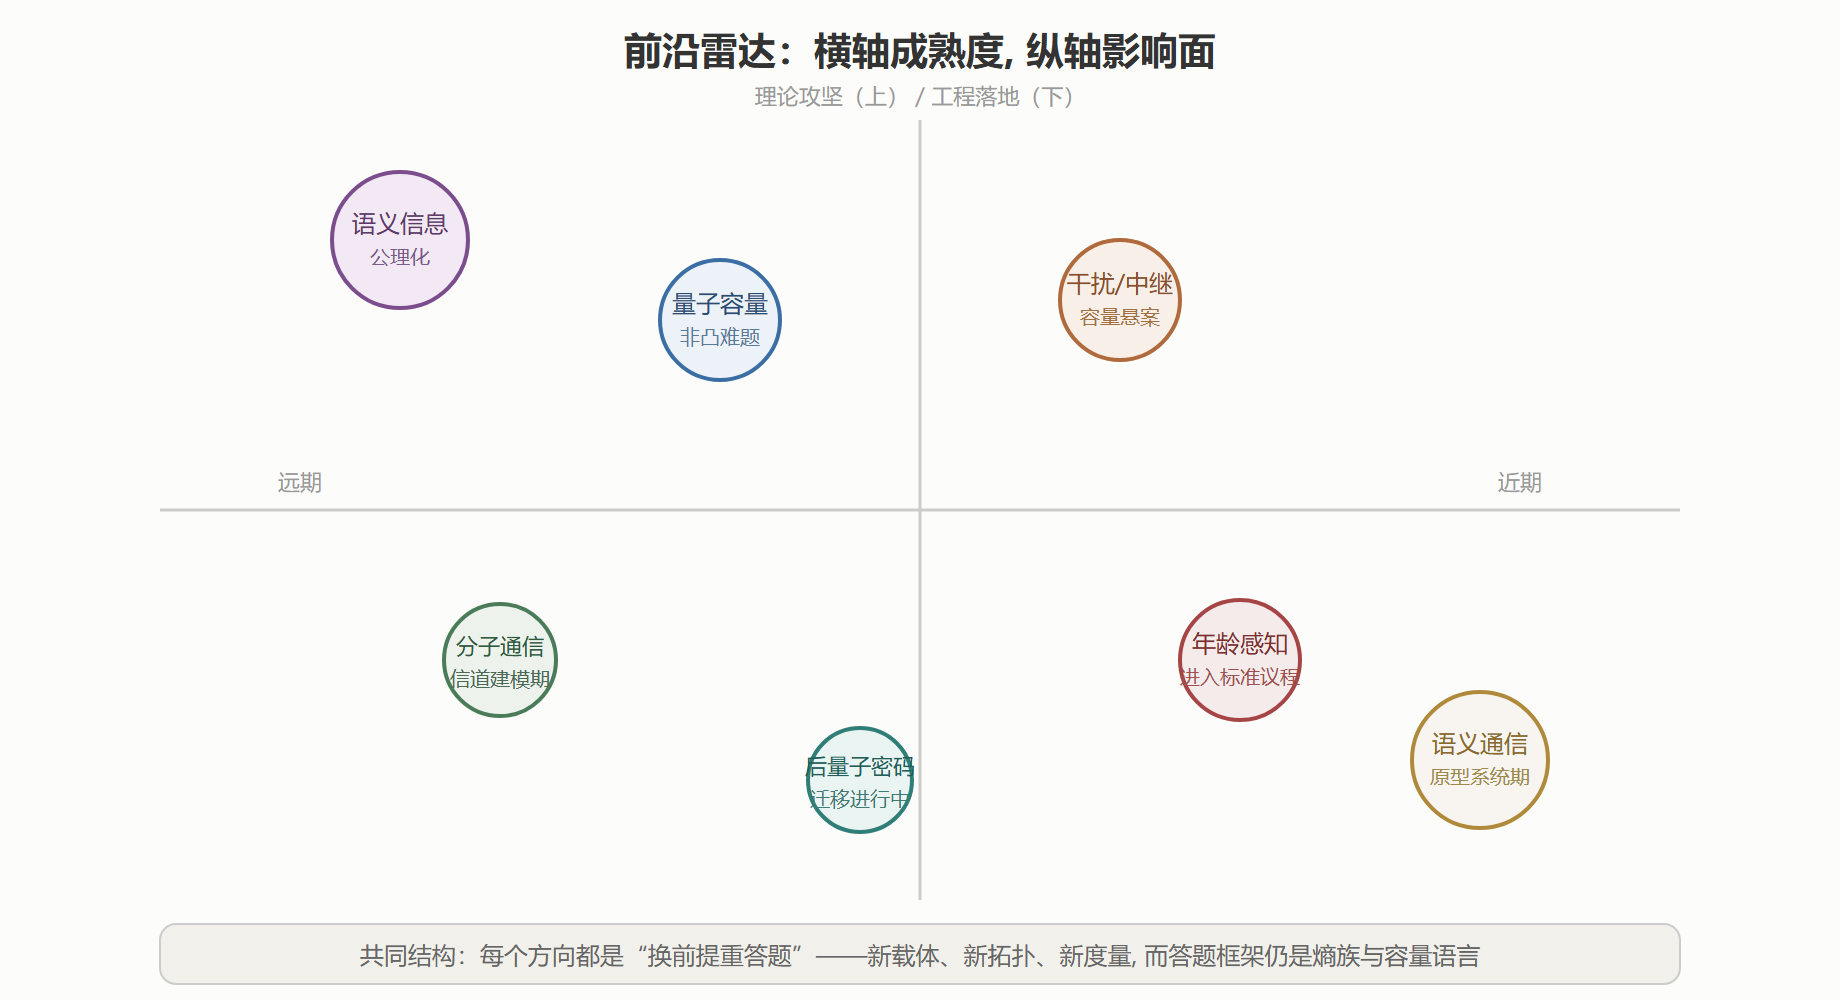
雷达图的横轴是成熟度(右为近期可落地),纵轴区分理论攻坚与工程落地。位置会移动,但共同结构不变:每个前沿方向都是一次"换前提重答题"——换载体(量子、分子)、换拓扑(中继、干扰、时变)、换度量(语义、年龄、任务效用)——而答题的框架始终是本册反复演练的熵族量具与容量语言。这正是第 7 章结论的复现:信息论的资产是"先定义被称量对象、再问极限"的方法论。
三条趋势判断
**趋势一:度量多元化不可逆,但比特刻度不会退役。**信息年龄、任务效用、语义等价类正在加入度量家族——被称量对象从"内容"扩展到"时效、价值、含义"。但每个新度量最终都要与比特刻度合账(第 9.3 节的两层秤):任务效用再高,超出容量预算就是空谈。未来的信息系统将同时挂多杆秤,工程师的工作从"最大化一个数"变成"在多个读数之间做透明的取舍"。
**趋势二:信息论与机器学习进入双向输血期。**信息论给机器学习输送了交叉熵、互信息、信息瓶颈(第 8 章);机器学习开始反哺——用神经网络的表征能力逼近难算的容量与率失真函数、用数据驱动的方式估计信道与语义熵。"学习出来的编码器"与"证明出来的定理"之间的对账(什么时候可以相信学出来的方案)是未来十年理论侧的主戏之一。高维互信息估计的统计难关(本节清单第五条)是这条双向管道里最窄的阀门。
**趋势三:极限意识从链路层扩散到系统层与可持续性。**能量约束(绿色通信、能量收集)让"每比特能耗"成为与"每赫兹比特"并列的一级指标;语义与年龄的引入让"每个决策的信息贡献"进入计价体系。香农式的提问方式——这个指标的物理或数学上界是多少、我们离它多远——正在从通信工程师的手里传到系统架构师、算法工程师乃至政策制定者手里。会问"上界在哪"的人,在任何资源受限的领域都自带罗盘。
收束:把天平带走
全册从"为什么信息也可以称出重量"的问题出发,到这张开放问题清单收尾,中间铸了砝码、建了车间、测了承重、连了秤网、巡了疆界、跑了应用场。清单上每个未解问题都在提醒:这台天平还没称完世界。而它真正值得带走的,是那套反复演练的动作——定义对象、找到砝码、算出极限、丈量差距。下一个要称的东西出现时,你知道从哪里开始。
给想进入前沿的工程师:一张入场路线
前沿清单看着宏大,入场路径却可以很具体。按"已有工具的延伸"排序,难度递增大致是:第一级,把本册的量具用到一个没有公开读数的系统上——你手头的日志流(估熵率、测可压缩空间)、你维护的链路(算容量上限、量余量)、你训练的模型(画中间层与标签的互信息轨迹)。这一级产出的常常是"原来我们离极限这么远/这么近"的量化认知,本身就是工程价值。第二级,复现一篇综述里的经典结果——比如在仿真里复现多址容量区域与时分可达线的对比、或者把极化码的信道极化现象画出来。复现会逼你把第 4、6 章的每个细节真正走通。第三级,挑清单上的一个开放问题读近三年的论文,找到"已知最好方案"与"已知最好界"之间的缝隙——缝隙就是你选题的地方。信息论方向的论文有个对新人友好的特点:多数理论论文的核心实验可以在一台笔记本上跑完,不需要数据集与算力集群,数字演算就是实验。
阅读路线上,香农一九四八年的原始论文至今是最值得通读的一手文献——不到六十页装下了整个学科的地基,且写作清晰得惊人;此后按本册各章的"里程碑"倒查原始文献(霍夫曼一九五二、加拉格一九六三、贝内特与布拉萨德一九八四、塔什比二零一五),能亲眼看到每个概念诞生时的原始形态。读原始文献的额外收益是免疫二手转述的失真——信息论的科普与教材转述里,"香农证明了噪声可以完全消除"这类夸张并不少见,读过原文的人自带抗体。
三条被反复问到的判断
"信息论还值得新入场者投入吗?" 值得,但投入方式变了。纯理论突破(新容量公式、新极限定理)的窗口确实变窄,但"理论工具的搬运工"严重短缺——能把熵、容量、率失真用到机器学习、系统设计、甚至生物与金融数据上的人,市场缺口远大于纯理论岗。本册的全部训练都是在为这个缺口储备。
"会不会被机器学习取代?" 不会互相取代,会互相收编。信息论给学习理论提供的是"不可再压缩"的极限语言,机器学习给信息论提供的是"难算量的可学习近似"。十年后的从业者大概率两边都要会——用信息论问"上界在哪",用学习工具逼近它。
"这套知识多久会过时?" 熵与容量的框架已稳定运行七十余年,是工程科学里最抗折旧的资产之一。会过时的是具体工艺(某代编码标准、某代压缩格式),而框架只在"换前提"时扩展、从不作废——第 7 章的三扇门与本章的雷达图讲的都是这个故事。
本节要点回顾
- 开放问题清单:一般中继与干扰信道容量(多用户耦合难解耦)、量子容量的非凸计算、语义信息的公理化缺口、高维互信息估计的统计难关、新介质新拓扑的信道重建模;
- 前沿的共同结构是"换前提重答题"——载体、拓扑、度量在换,熵族量具与容量语言的框架不变;
- 趋势一:度量多元化不可逆,但比特刻度不退役——多杆秤并存,工程变成透明的多目标取舍;
- 趋势二:信息论与机器学习双向输血,学出来的方案与证出来的定理如何对账是主戏,互信息估计是最窄阀门;
- 趋势三:极限意识扩散到能耗与决策贡献的计价——"上界在哪、离它多远"这套问法本身就是最耐用的工具。