第2章 · 感知与空间理解
第 2 章 · 感知与空间理解
章节摘要:感知是感知-行动闭环的输入端,机器人得先看懂环境才能行动。这一章讲三块:多模态感知与传感器融合(视觉加触觉加本体感觉怎么合起来用)、SLAM 同步定位与建图(机器人在未知环境怎么知道自己在哪、环境长什么样)、场景图与语义空间理解(不光知道有什么,还知道它们什么关系、什么含义)。读完你会理解机器人是怎么“看懂”物理世界的。
上手前先明确
阅读完本章,你应当能够:
- 说清视觉、触觉、本体感觉等传感器各自的特性和局限
- 理解多模态传感器融合的原理和价值
- 说清 SLAM 解决的核心问题和基本思路
- 区分几何地图和语义地图
- 理解场景图在空间理解中的作用
核心概念速览
单一传感器都不够用,融合才有完整感知;定位建图是行动基础;语义理解让感知能指导决策。
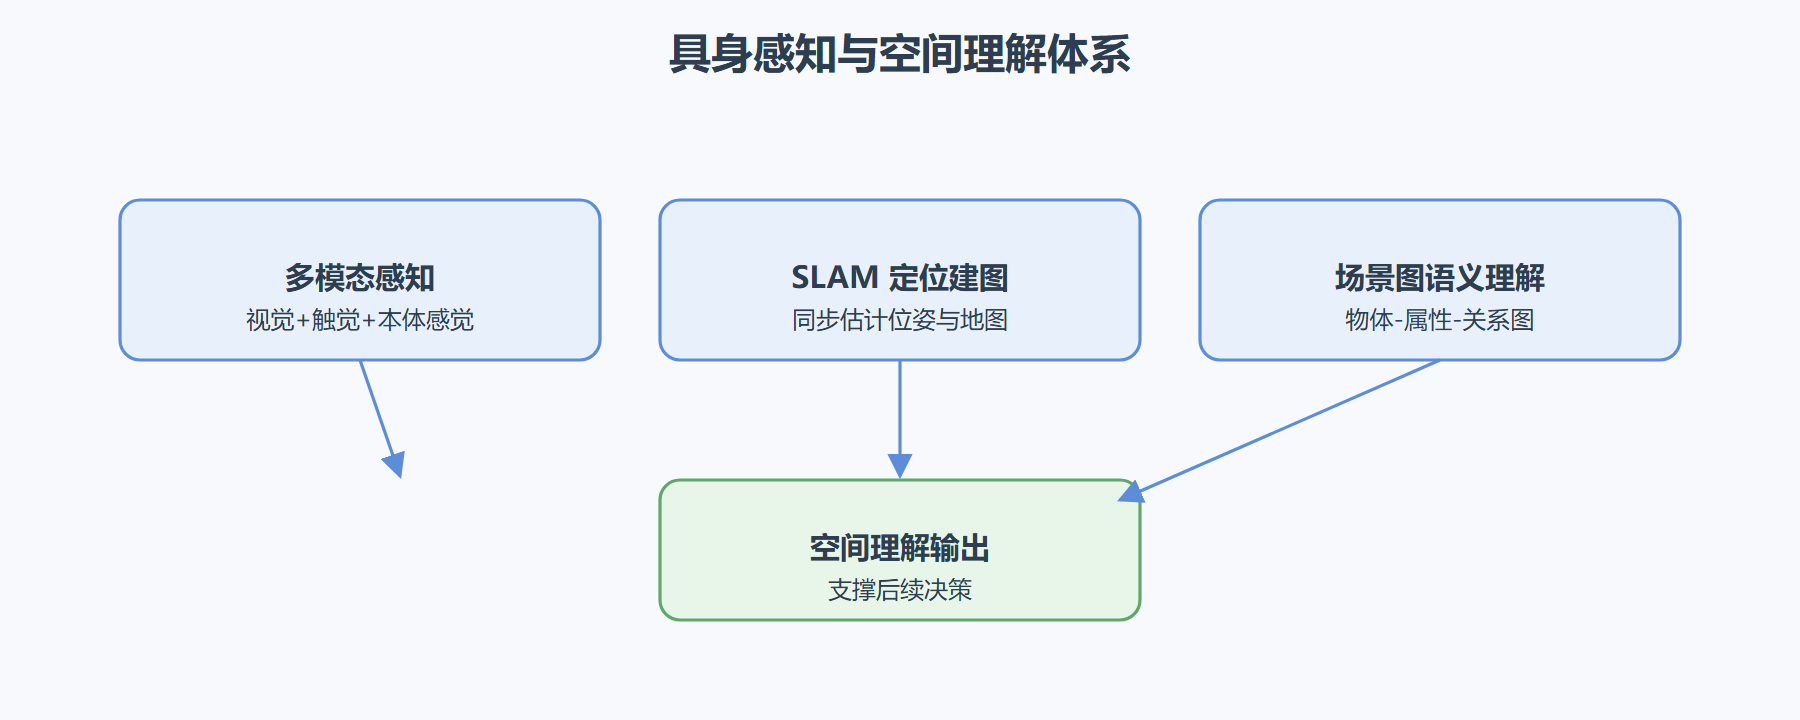
图 2-1:具身感知与空间理解体系
子章节导航
2.1 多模态感知与传感器融合
讲各种传感器(相机、激光雷达、力觉、本体感觉)各自的优缺点,以及为什么单靠一种不够、要把多种融合。重点讲融合的层次(数据级、特征级、决策级)和典型方法。
2.2 SLAM 同步定位与建图
机器人进到一个陌生房间,怎么知道自己在哪、房间长什么样?这就是 SLAM 解决的问题。讲它的基本原理(同时估计自身位姿和环境地图)、主流方法(基于滤波、基于图优化)和应用场景。
2.3 场景图与语义空间理解
光知道环境里有什么物体还不够,还得知道它们什么关系、什么属性(这个杯子是易碎的、那个桌子可以放东西)。讲场景图的构建和它在语义理解、任务规划中的作用。
子章节之间的逻辑关系
2.1 讲感知的输入(多传感器融合),2.2 讲把感知组织成空间地图(SLAM),2.3 讲给地图赋予语义(场景图)。从原始数据到可用表征,层层递进。
2.1 传感器融合(原始数据)──► 2.2 SLAM(空间地图)──► 2.3 场景图(语义理解)
前置知识与后续延伸
- 前置知识:第 1 章的感知-行动闭环概念。
- 后续延伸:感知提供了环境信息,第 3 章讲机器人怎么基于这些信息做认知和决策。
评论区
(0)
U