第3章 · 认知决策与大脑模型
第 3 章 · 认知决策与大脑模型
章节摘要:感知给了机器人环境信息,认知决策负责基于这些信息决定“做什么”。这一章讲两块:具身基础模型(特别是视觉-语言-动作模型 VLA,怎么用大模型能力做机器人决策)、任务规划与记忆系统(怎么把复杂任务分解成动作序列、怎么用记忆处理长程任务)。这是把大模型的“理解能力”转化为机器人“行动能力”的关键一层。
读前必看
阅读完本章,你应当能够:
- 理解具身基础模型的概念和价值
- 说清视觉-语言-动作模型(VLA)的架构
- 区分任务规划的不同层次
- 理解记忆系统在长程任务里的作用
- 说清大模型在具身智能里该用在哪一层
核心概念速览
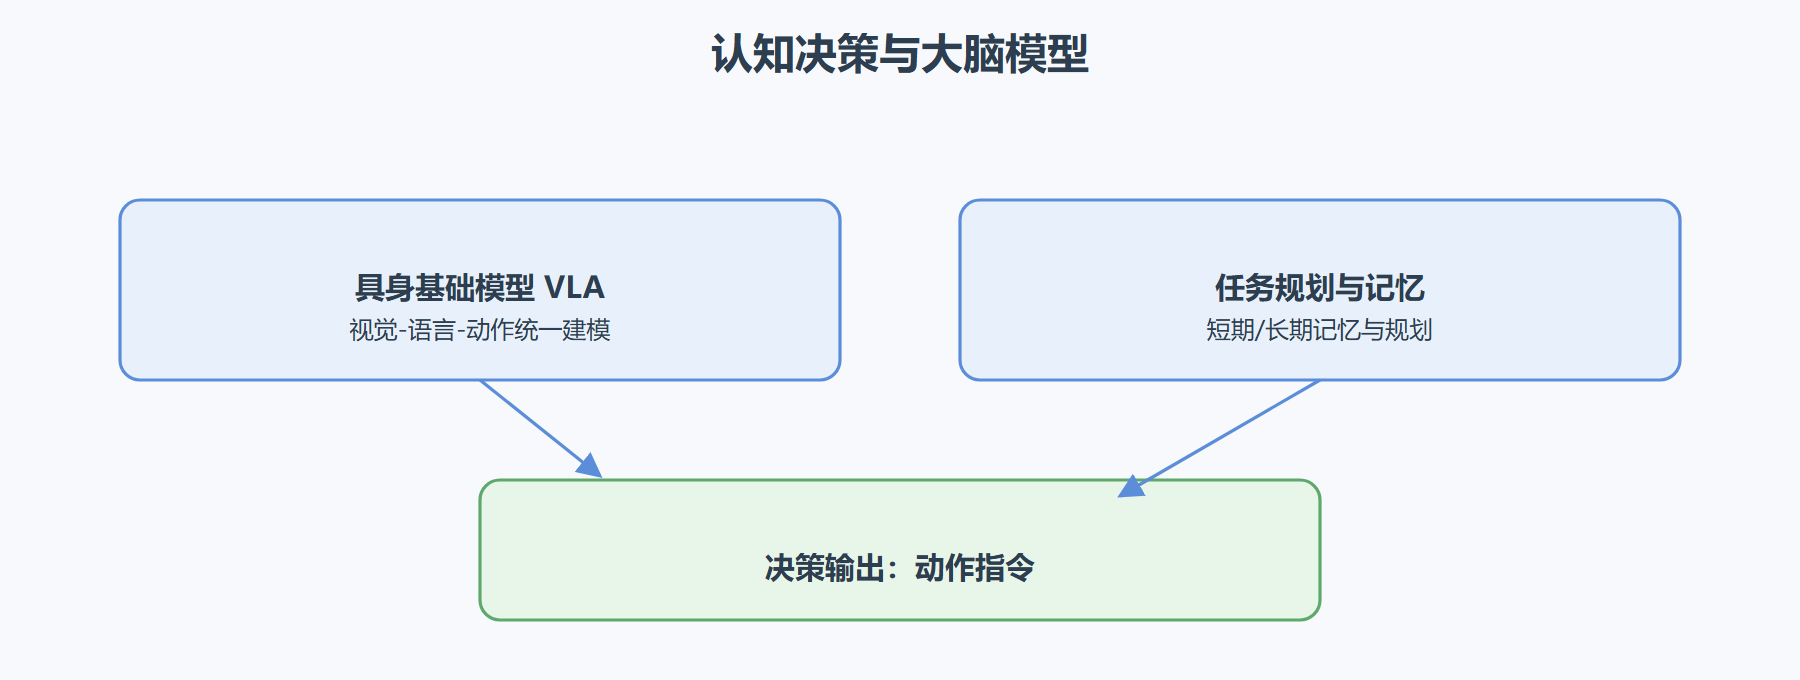
大模型擅长高层理解,但要落地到动作,得通过 VLA 这类具身基础模型,把语言和感知转化为可执行的动作。
图 3-1:认知决策与大脑模型
子章节导航
3.1 具身基础模型与 VLA
讲怎么把大模型的能力迁移到机器人——视觉-语言-动作模型(VLA)怎么同时处理图像、语言指令、输出动作。这是具身智能最前沿的方向,也是让机器人理解开放指令的关键。
3.2 任务规划与记忆系统
讲怎么把复杂任务(“收拾厨房”)分解成动作序列,以及记忆系统(短期工作记忆、长期情景记忆)怎么支持跨越较长时间的长程任务。
子章节之间的逻辑关系
3.1 讲单个动作决策怎么做(VLA),3.2 讲多个动作怎么组织成任务序列(规划加记忆)。前者是原子能力,后者是组合能力。
3.1 VLA(单动作决策) + 3.2 规划与记忆(动作序列组织)
前置知识与后续延伸
- 前置知识:第 2 章的感知与空间理解。
- 后续延伸:决策输出的是动作指令,第 4 章讲这些指令怎么变成精确的物理运动。
章节脉络
本章按"决策模型 → 任务规划 → 记忆系统"三层展开:先介绍具身基础模型如何把视觉、语言与动作统一到一个网络里,让机器人"看懂了就能做";再讲任务规划如何把高层指令逐步分解为可执行的子任务与动作序列;最后讲记忆系统如何支撑长程任务——工作记忆保存当前任务上下文,场景记忆保留环境布局,经验记忆沉淀过往成功策略。三者的配合决定了机器人在开放环境中的自主作业能力。
与相邻章节的联系
第2章解决了"感知"问题(看到什么),本章解决"决策"问题(做什么、怎么做),第4章负责"控制"(如何动起来)——感知-决策-控制的闭环是具身智能系统的骨架。本章的 VLA 模型直接消费第2章的视觉表征,其输出的动作序列交给第4章的控制器执行;记忆系统则贯穿全流程,为感知提供先验、为决策提供上下文、为控制提供示范经验。