1.1 一次请求的太空之旅
1.1 一次请求的太空之旅
本节是全册的起点:把"低轨卫星互联网"这个名词拆成一段一段可观察的旅程。它上承导读的知识地图,下通 1.2 节的轨道对比——走完这趟旅程你会发现,每个环节的形态都是由"卫星在动、距离不近、链路共享"这三条物理事实决定的。
从大副点开视频通话说起
回到导读里那位远洋货轮的大副。他在平板上点开视频通话,应用做的第一件事是域名解析,而这一次 DNS 查询本身就要先上太空。终端的调制解调器把查询报文打包成射频信号,经相控阵天线抛向头顶约 550 公里处一颗正在过境的卫星——这一抛就是用户链路。卫星不是镜子,它收到信号后解调、解码,把报文从射频波形还原成 IP 包,查星载路由表,发现目标地面站不在自己脚下,于是把包交给下一颗卫星。数据就这样在星间链路上一棒一棒传过去,直到某颗卫星的视野里出现能连接互联网的信关站,包顺着馈电链路落地,进入运营商网络,找到 DNS 服务器,拿到答案再原路(或换一条更优路)返回终端。
整个过程里大副什么都看不见,他只感知到两件事:画面通了、延迟比家里光纤略高。而调度台的大屏上,这几十毫秒被分解成传播时延、处理时延、排队时延和接入时延四类账目。本册后面所有章节,本质上都在压缩这张账单上的某一栏。
端到端接力路径全景
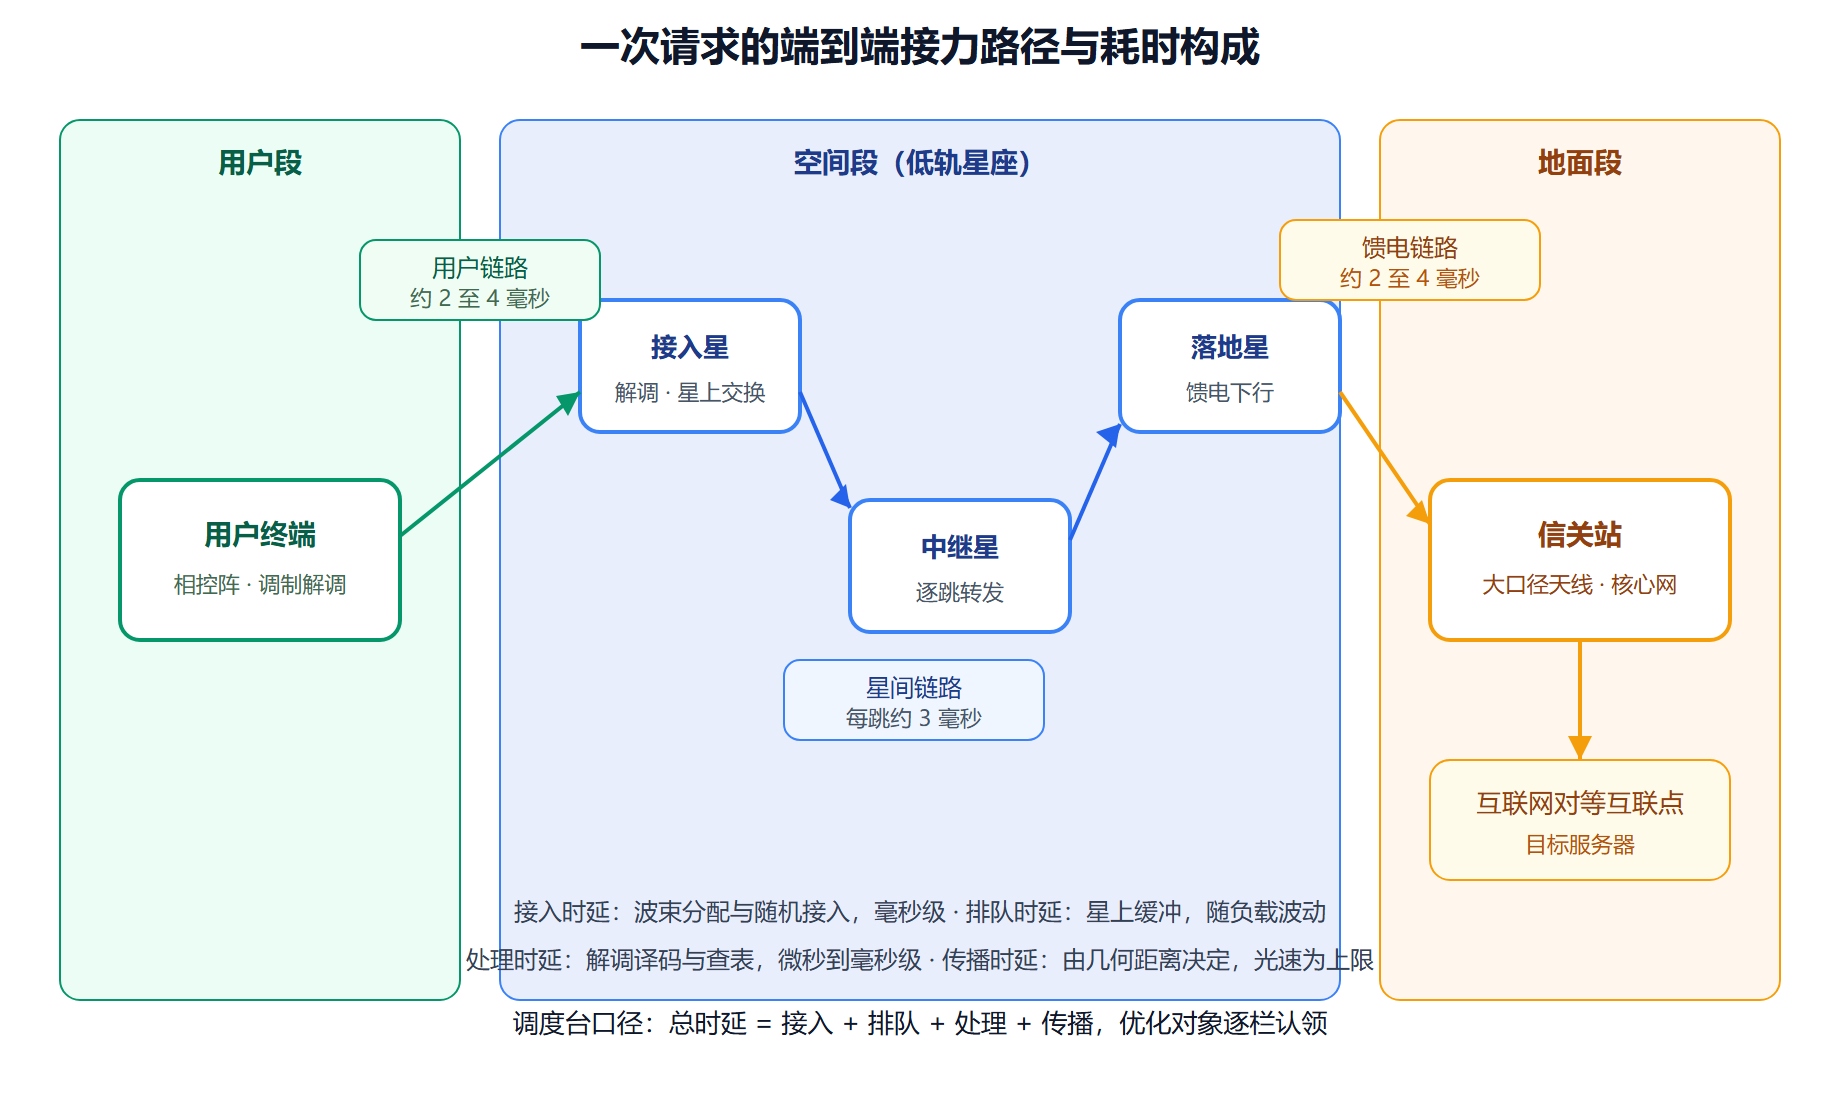
逐段拆账:每棒到底花掉多少时间
把这段旅程按调度台的账目格式列出来,数字会说话。下表以一次典型的低轨宽带往返(用户到信关站经两跳星间转发)为参照:
| 环节 | 发生位置 | 耗时量级 | 由谁优化 |
|---|---|---|---|
| 随机接入与波束分配 | 用户链路 | 5 至 30 毫秒 | 第 4 章多址接入 |
| 用户链路传播 | 终端到接入星 | 约 2 至 4 毫秒 | 轨道高度决定 |
| 星上解调与交换 | 每颗卫星 | 每跳不足 1 毫秒 | 星载处理能力 |
| 星间链路传播 | 卫星到卫星 | 每跳约 3 毫秒 | 第 5 章选路跳数 |
| 馈电链路传播 | 落地星到信关站 | 约 2 至 4 毫秒 | 信关站布局 |
| 信关站与核心网转发 | 地面 | 1 至 5 毫秒 | 第 9 章部署 |
| 排队与调度 | 全路径 | 随拥塞上升 | 第 6、7 章 |
几个工程直觉值得现在就建立。第一,低轨单跳传播时延只有几毫秒,但星间接力跳数会累积它,跳数每多一级,往返时延近似增加两级(去程加回程);第二,接入时延在空闲时几乎为零、在拥塞时会吃掉几十毫秒,这也是为什么实测延迟曲线呈长尾分布;第三,整条链路上唯一无法压缩的是传播时延,它是几何问题而不是算法问题——这正是"调度台"存在的理由:既然光速改不了,那就改路径、改时刻、改负载分布。
弯管与再生:两种抛棒手法
同样把包送上太空,历史上存在两种根本不同的做法,理解它们的差别等于理解了低轨星座的技术分水岭。弯管(透明转发)模式下,卫星只做放大和变频,把上行频率搬到下行频率原样发回地面,所有的智能都在地面站;这要求用户和信关站必须被同一颗卫星同时看见,跨洋流量只能先落地再走地面网。再生(星上处理)模式下,卫星把信号解调还原成比特甚至 IP 包,在星载交换机里查表转发,配合星间链路,数据可以全程留在太空直到最优落地点。
| 维度 | 弯管转发 | 再生处理加星间链路 |
|---|---|---|
| 星上复杂度 | 低,转发器即可 | 高,需要星载计算与交换 |
| 落地要求 | 每颗服务星都要看见地面站 | 星座整体有少量信关站即可 |
| 跨洋时延 | 先落地再上星,绕行明显 | 星间直传,接近大圆距离 |
| 波束灵活性 | 地面配置,更新慢 | 星上可编程,秒级重配 |
| 代表系统 | 早期高轨宽带 | 现代低轨星座 |
这个差别直接解释了为什么低轨星座偏爱极轨道:极轨星间链路可以把两极上空"没有地面站"的流量沿轨道面接力传到有人居住的纬度再落地,弯管架构在这种场景下根本无法工作。
把账单跑一遍:调度台的第一段脚本
口说无凭,调度台见数。下面这段 Python 把上表的量级编成一段可运行的演算:给定轨道高度、星间跳数与各环节的典型耗时区间,输出一次往返的总时延与各栏占比。你可以改动参数感受每个杠杆的分量——这正是后续章节所有优化的"实验台雏形"。
C = 299792.458 # 光速,公里每秒 def trip(height_km, hops, access_ms=(5, 30), queue_ms=(0, 8), gw_ms=(1, 5), slant_factor=1.3): """估算一次低轨往返时延:传播用几何算,其余用典型区间。""" uplink = 2 * slant_factor * height_km / C * 1000 # 用户链路,去程加回程 islid = hops * 4500 / C * 1000 * 2 # 星间每跳按约 4500 公里 feeder = 2 * slant_factor * height_km / C * 1000 # 馈电链路 prop = uplink + islid + feeder lo = prop + 2 * (access_ms[0] + queue_ms[0] + gw_ms[0]) + 2 * 0.5 hi = prop + 2 * (access_ms[1] + queue_ms[1] + gw_ms[1]) + 2 * 2.0 return prop, lo, hi for h, hops in [(550, 0), (550, 2), (550, 4), (1150, 2)]: prop, lo, hi = trip(h, hops) print(f"高度 {h:>4} 公里 · 星间 {hops} 跳 | " f"传播 {prop:5.1f} 毫秒 | 总时延 {lo:5.1f} ~ {hi:5.1f} 毫秒") # 输出(典型运行结果): # 高度 550 公里 · 星间 0 跳 | 传播 10.4 毫秒 | 总时延 25.4 ~ 96.4 毫秒 # 高度 550 公里 · 星间 2 跳 | 传播 16.4 毫秒 | 总时延 31.4 ~ 102.4 毫秒 # 高度 550 公里 · 星间 4 跳 | 传播 22.4 毫秒 | 总时延 37.4 ~ 108.4 毫秒 # 高度 1150 公里 · 星间 2 跳 | 传播 21.9 毫秒 | 总时延 36.9 ~ 107.9 毫秒
三个观察直接可读。其一,跳数与高度的量级相当:四跳星间对传播的贡献约等于把轨道从 550 抬到 1150 公里,第 5 章省一跳等于免费降轨。其二,总时延的区间宽度远大于传播项本身——接入与排队这两栏在拥塞时贡献了长尾,说明"延迟体验"是网络管理问题而不只是物理问题。其三,即使最差情况,低轨往返也稳定在 100 毫秒量级,与高轨的 500 毫秒以上拉开了一个身位,这正是 1.2 节资格赛的核心计分项。
一个完整案例:三分钟视频通话里的四次切换
把旅程落到实处。假设大副的通话持续三分钟,而接入星的可见窗口只有几分钟,这段时间里终端至少经历一次卫星切换,大概率是两次以上。第一次切换发生在接入星仰角降到门限以下时,终端测量到邻星信号更强,发起切换请求,网络侧把会话锚点从旧星迁到新星,期间 TCP 连接靠第 6 章的切换管理保持不断。切换完成后,路由路径整体重构,原来经两跳星间的流量可能变成一跳直达,RTT 从 38 毫秒跳到 29 毫秒——大副完全无感,调度台日志里则是一次完整的交接记录。回程方向还有个容易被忽略的细节:响应包不一定原路返回,星座会按当时拓扑重新选路,这叫路由非对称,是后面第 5 章的重要内容。
收班笔记
- 一次请求等于多段接力:用户链路抛棒、星上处理接棒、星间链路传棒、馈电链路落地,四段缺一不可。
- 时延账本分四栏:接入、排队、处理、传播,前三栏可优化,第四栏由几何决定。
- 跳数是时延放大器:星间每多一跳,往返多几毫秒,选路算法的价值就在省跳。
- 弯管与再生是分水岭:星上处理加星间链路让数据留在太空,才有了真正的"天基互联网"。
- 切换是常态而非异常:几分钟一次的换星贯穿整个会话生命周期,终端无感靠的是整条管理链路。
下一节把镜头从"链路怎么走"转向"卫星在哪":三代轨道系统像三批选手打了一场持续几十年的资格赛,低轨为什么能在这一轮胜出,答案藏在轨道高度与它带来的物理代价里。