5.2 干扰与网络效应
5.2 干扰与网络效应
本节摘要:SUTVA 假设个体结果不依赖他人的处理分配,但疫苗、口碑、市场补贴、平台推荐全面违反它。本节给出干扰下效应量的重新定义(直接/间接/总/溢出效应四元组)、暴露映射的构造、整群随机与两阶段随机两种设计解法,以及平台实验里的常见失真与修正思路。
SUTVA 在哪里失守
第 1.2 节把 SUTVA 一笔带过,现在正面拆它。反例俯拾皆是:一人接种疫苗,邻居感染概率下降(传染动力学);一家店降价,竞争对手客流被抢走(商业竞争);信息流里给用户 A 曝光新品,A 的转发影响 B 的购买(网络传播)。在这些场景,个体 i 的潜在结果要写成 Y_i(x_i, x_{−i})——依赖全网的分配向量,标准 ATE 的定义本身失效。
失守的图形状也值得画一次:处理 → 邻居结果 ← 邻居处理 → 自身结果,处理效应沿社会网络绕行回到自己。经典 A/B 实验把网络切片成互不相扰的群组时无意间消除了这条环;不做切片时就撞上它。
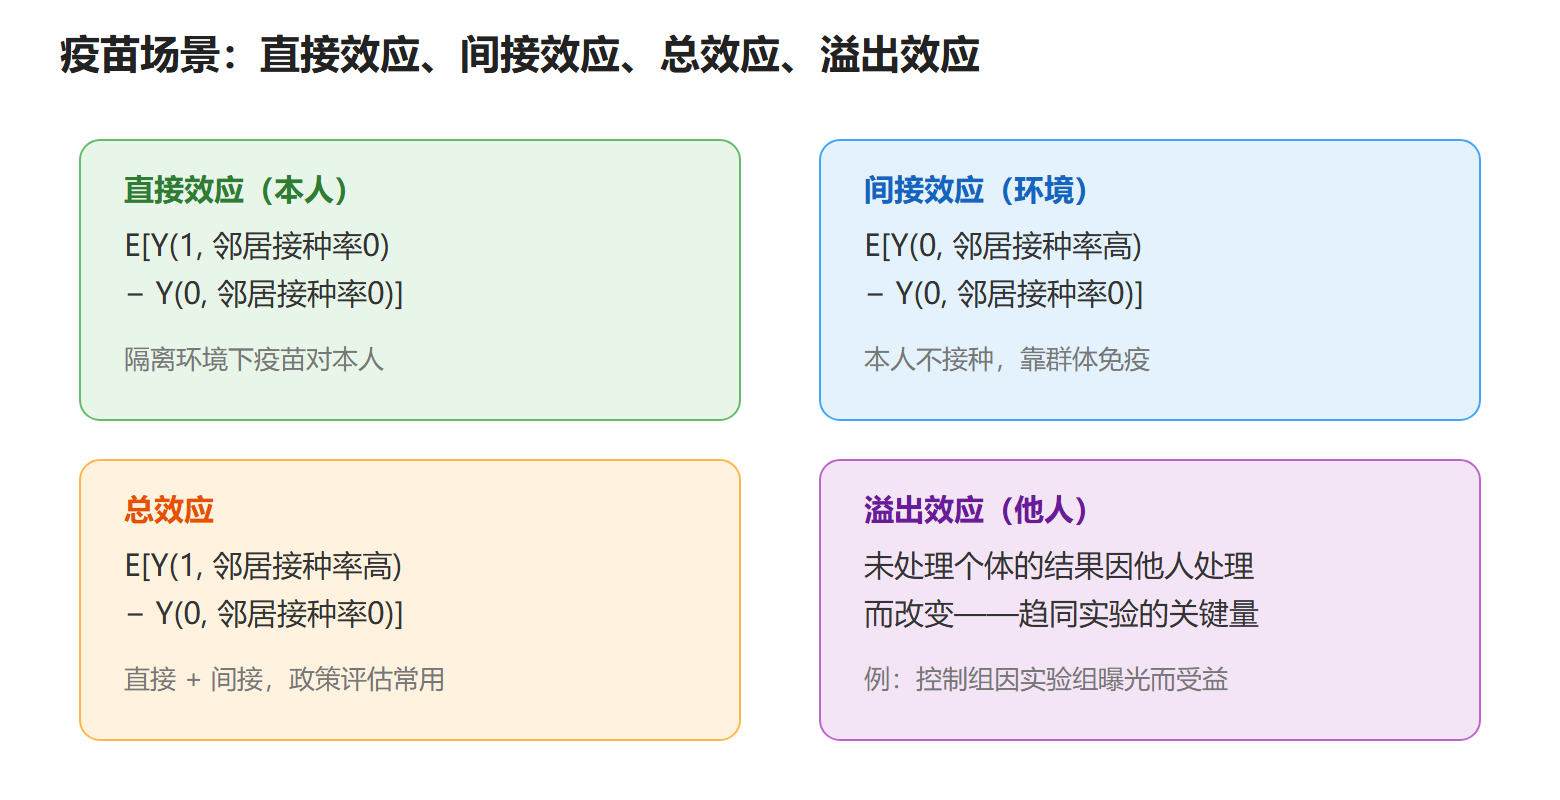
图:干扰下的四种效应分解
暴露映射:给干扰一个可估的参数化
干扰的一般定义不可操作(邻接矩阵上任意函数),实践靠暴露映射(exposure mapping)压缩:给每个个体定义有限个暴露状态,如"自身接种 × 邻居接种比例是否过半"四状态,效应定义为状态间潜在结果之差。压缩的代价是假设(邻居结构已知、映射形式正确),收益是四状态各自有可估的均值——前提是设计配合。常用的两种设计:
整群随机。把互相影响的个体绑成群(村庄、学校、社群集群),群内统一分配、群间视为独立。估计的是群级效应(含群内溢出),干净的代价是有效样本量变成群数,方差膨胀按设计效应 DEFF ≈ 1+(m−1)ρ 计(m 为群均大小,ρ 为群内相关)——不做这个换算会把置信区间做得过于乐观。
两阶段随机(趋同/switchback 实验)。第一阶段随机一部分群到高接种率、其余到低接种率;第二阶段群内再随机个体。由此可分离直接效应(同环境下接种与未接种之差)与间接效应(不同环境间未接种者之差)。平台实验里对应的形态是:地理分桶做市场级实验,或时间切片轮换(switchback,同一市场在不同周轮换处理状态),把溢出锁在桶/期内部。
平台实验的三个失真与修法
低估效应:处理组用户的好友在对照组里看到转发内容,对照组被"污染",组间差缩水。修正:网络切片聚类(按社交图切互不相交的社区)、或度量溢出后把总效应 = 直接 + 溢出补回。
抢蛋糕( cannibalization):补贴让用户从商家 A 流向商家 B,平台总 GMV 不变而单商家实验显示大赚。修正:以市场/品类为实验单元,或设置负控指标(同市场未补贴商家)观察转移量。
挤出长期效应:短期实验的提升来自提前透支需求。修正:延长观察窗、switchback 长期留出 holdout 市场。这三类问题的共性是"实验单元小于干扰半径",修法都是把单元撑到不漏的尺度——识别问题的答案最后总是设计,而非估计器。
干扰估计的数值直觉与检查清单
给干扰偏倚一个量级感。设直接效应 5 个点、溢出效应 2 个点(对每个邻居)。个体级实验把邻居随机分到两组:对照组个体平均有一半邻居在处理组,吃到约 1 个点溢出;处理组个体同样。测得的组间差 ≈ 5 + (处理组内溢出差异),系统性低估总效应(直接+溢出=7)的幅度取决于网络密度与分配比例——密度越高、低估越狠。城市级实验则把两种效应都收进组间差,测的是 7。这就是"单元决定效应口径"的数值版。
上任何干扰敏感的场景前过一遍检查清单:一、处理的影响半径是什么(社交一跳?市场全城?品类全量)?二、实验单元是否≥影响半径?三、若单元做不到≥半径,能否度量溢出(对照组邻居的处理暴露)并报告总效应=直接+溢出?四、指标是存量还是增量(GMV 转移还是新增)?五、有没有 holdout 单元校准长期效应?五问都答清,干扰至少不会偷袭你。
溢出效应的估计设计补充
当单元升级不可行(市场就一个、网络无法切片)时,还有部分设计可用。弧级实验:把曝光连接(而非用户)随机化,同一用户的社交边部分在处理侧,估计溢出沿边的传导。阶梯设计(stepped wedge):所有单元分批进入处理,每批的切换时点随机,单元内先后对照吸收部分干扰。暴露探测:给对照组个体按"邻居处理密度"分层,用密度梯度估计溢出剂量反应。三种设计的共同前提是能观测或重构干扰网络——这也是为什么因果工程团队总在推动"关系数据入仓":没有网络数据,干扰只可假设不可估计。
从 SUTVA 到网络的一页决策
把本节压缩成一个决策路径:第一步,回答"我的处理会改变别人结果吗",不确定时先做小规模溢出探测(对照组的邻居处理密度与结果的回归)。第二步,若干扰存在,测量影响半径(一跳社交、同城市场还是全品类),并把实验/识别单元升到半径之上。第三步,单元升不动时,选择度量方案:暴露映射四态估计、弧级设计或阶梯设计。第四步,报告永远拆开直接与溢出,两者的政策含义完全不同——补贴的直接效应要看,但平台总增量看的是两者之和,而长期留存往往被溢出的二阶效应主导。四步走完,"SUTVA 违反"从一句免责声明变成一组可管理的工程参数。
补充:干扰假设的审稿级表述
写方法部分时,干扰假设值得三行明确:第一行声明实验单元与理由(以城市为单元,因为补贴信息跨城传播可忽略);第二行声明暴露映射(单元内全覆盖、单元间零溢出);第三行声明违反时的后果方向(若存在跨城溢出,估计为总效应下偏)。三行字换来评审少一轮往返,也让后来的读者知道边界画在哪里。多数干扰争议的根源不是没做处理,而是处理了却没写清楚假设的形状与失效方向——把失效方向写出来,等于给了读者一份自行校准的说明书。
本节要点回顾
- 定义失效:干扰下潜在结果依赖全网分配,ATE 要换成直接/间接/总/溢出四元组。
- 暴露映射:把无限干扰压缩成有限状态,是可估性的来源,也是新增假设。
- 设计解法:整群随机(注意设计效应 DEFF≈1+(m−1)ρ)与两阶段随机(分离直接与间接)。
- 平台三失真:污染、抢蛋糕、挤出——根因是单元小于干扰半径,解法在实验设计层。
- 下一节:多重与连续治疗,SUTVA 的另一半推广。