7.2 经济学与政策评估
7.2 经济学与政策评估:自然实验家族
本节摘要:经济学的可信度革命把因果识别推到方法核心:双重差分利用政策的时间-地区差异,断点回归利用规则门槛,工具变量利用制度设计。本节复盘最低工资与移民两个经典研究,拆解 DID 的平行趋势假设与事件研究图,并讨论合成控制法与政策评估的一般工作流。
DID:差掉两个维度的不变项
双重差分(difference-in-differences)的逻辑:政策只在部分地区(处理组)某时刻后实施。处理组前后之差里既有政策效应也有时间趋势;对照组前后之差只有时间趋势;两者再相减即效应。它同时对"地区间固定差异"与"全国性时间冲击"各差掉一次。
案例复盘:Card 与 Krueger 的最低工资研究(1994)。新泽西 1992 年上调最低工资,相邻宾州没有。两州快餐店(受最低工资约束最强的行业)就业在政策前后各测一轮。结果:调薪州就业未降反微升,冲击"最低工资消灭就业"的教科书预测。这个研究的方法学遗产是把"自然发生的政策差异"当成准实验来设计——先明确处理组、对照、时间窗,再谈回归。
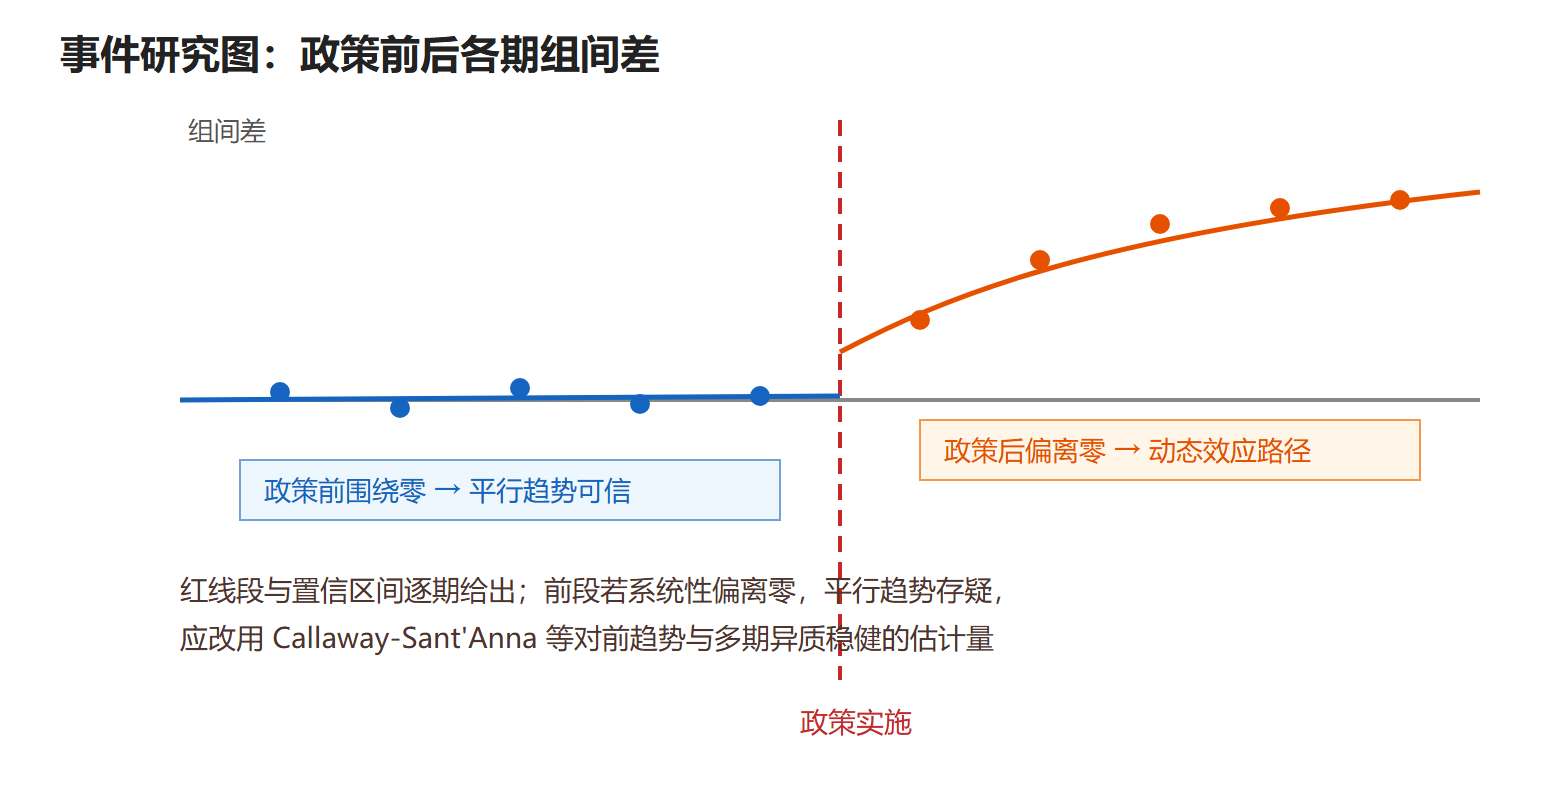
DID 的命门是平行趋势假设:若无政策,两组的趋势本会平行。不可直接检验,但有两个标准动作:事件研究图——把政策前后每期的组间差画成时间序列,政策前各期应围绕零波动(前趋势检验),政策后逐步显现效应;安慰剂检验——在从未实施政策的日期虚构处理,估计"假效应"分布。近年的计量修正(Goodman-Bacon 分解、Callaway 与 Sant'Anna 的组-期异质稳健估计量)解决的是"多期多批次政策下,双向固定效应估计量会被已处理组当对照污染"的问题——旧式 TWFE 回归在 staggered adoption 下可能有偏,这已是政策评估的必查项。
图:DID 事件研究图的双读法
移民与制度工具:Card 的另一半遗产
2021 年诺贝尔经济学奖(Card、Angrist、Imbens)表彰的正是这套"自然实验 + 工具变量"范式。Card 利用 1980 年马里埃尔船运事件(迈阿密短期内涌入古巴移民,劳动供给骤增约 7%)估计移民对本地低技能工资的冲击——结论是几乎无影响,源于"马里埃尔时刻"对本地劳动力市场是外生冲击(第 4.5 节的外生性条件由历史事件背书)。Angrist 与 Krueger 的出生季度研究用"义务教育法 + 出生季度影响在校时长"作工具估计教育回报——同为 IV 三条件的教科书演示,也是弱工具讨论(第一阶段 F 值在部分规格中贴近临界线)的著名现场。这三个研究串起来正是第 4.4、4.5 节方法的应用源头。
**合成控制法(SCM)**是 DID 的"少样本对照"版:处理单元只有一个(如加州 anti-smoking 法案)时,用多个对照州的加权组合"合成"一个假想的加州——权重取正值且和为一,拟合目标是政策前多年的结果轨迹。效应 = 真实加州与合成加州在政策后的分叉。推断用置换检验(依次把每个州当"假处理州")。当处理组是单一聚合单元时,SCM 几乎是默认选择。
政策评估工作流
把本章与第 3、4 章缝成一个通用流程:第一,写"靶政策试验"方案(借用第 7.1 节七要素,把患者换成地区/企业);第二,识别策略按可得性排序——能随机就随机(发展经济学的分级随机补贴设计)、有门槛就 RDD、有政策分期分地就 DID/合成控制、有外生冲击就 IV、都没有则回到调整加敏感性分析;第三,报告时把识别假设的可信度证据(前趋势、密度检验、安慰剂)与效应估计并列呈现——经济学期刊与监管机构现在都默认要求这些"识别证据"而非只看系数星号。
FAQ 与报告规范
问题:平行趋势检验通过了就能放心用 DID 吗?
前趋势通过是必要非充分。它只排除"政策前趋势不同",排除不了"政策时刻恰逢处理组的额外冲击"(预期效应、同期配套政策)。补两个动作:安慰剂日期检验(虚构政策时点)与排他性事件排查(政策窗口内两组的其他差异清单)。DID 的可信度来自设计论证的完整度,不是前趋势图一张。
问题:staggered 政策下旧 TWFE 错在哪?
双向固定效应把"早已处理的组"也当对照混合估计。Goodman-Bacon 分解显示估计量是多个 2×2 对比的加权平均,其中"晚处理组对早处理组"的对比权重可能为负——效应异质时总估计甚至可偏离所有真实组效应的方向。修法:Callaway-Sant'Anna、Sun-Abraham 或 stacked DID,报告时注明估计量类型已是审稿标配。
合成控制的读图要点
合成控制的结果图有三条读法:第一,看政策前拟合段——真实单元与合成单元贴得越近,反事实构造越可信,前段分叉说明捐赠池不合格;第二,看政策后分叉的形状——即时跳变对应水平效应,渐次张开对应动态累积,两者对应不同的政策机制解读;第三,看置换分布——把每个捐赠单元轮流当"假处理",真实处理的分叉在假处理分布中的位置就是推断依据,p 值粗陋但诚实。三条都过,SCM 结论的分量不低于一个中等规模实验;前段都贴不住,后面再显著也只是拟合游戏。
政策评估的汇报句式
给决策者的因果汇报有三句式模板。效应句:"该政策使处理组人均收入提高约 X(95%CI),效应在政策后第 Y 年显现"。归属句:"该效应属于门槛附近/分批首批接受政策的群体,外推到全体需假设效应齐性"。稳健句:"平行趋势检验通过(前五期系数均不显著),假处理检验最大 p 值 0.3,未测混杂需同时与政策落地和收入各相关 Z 倍以上才能翻案"。三句式分别回答多大、属于谁、多可信——比一张回归表更接近决策语言,也倒逼分析者把第 3、4、6 章的功课做完。
本节要点回顾
- DID 双差结构:差掉组固定差异与时间冲击;平行趋势用事件研究图与安慰剂检验支撑;多期政策注意 TWFE 污染,换组-期稳健估计量。
- 自然实验三案例:最低工资(DID)、马里埃尔(事件研究外生冲击)、出生季度(IV 与弱工具现场)。
- 合成控制:单一处理单元时用加权对照单元合成反事实,置换检验推断。
- 工作流:靶试验方案 → 识别策略排序 → 识别证据与效应并列报告。
- 下一节:商业与科技场景——实验文化的便利与干扰结构的麻烦。