8.1 DoWhy与EconML:核心软件库
8.1 DoWhy 与 EconML:核心软件库
本节摘要:因果推断工具链的各库对应流水线的不同工位:DoWhy 管识别与反驳、EconML 管异质性估计、causal-learn 管结构发现。本节给出工具对照表、DoWhy 四步的概念代码、EconML 的估计器选择逻辑,以及库与库之间组合的接缝。
工位对照表
| 库 | 流水线工位 | 核心能力 | 典型入口 |
|---|---|---|---|
| DoWhy | 建模、识别、反驳 | 因果图输入、自动识别策略枚举、安慰剂/替换处理等反驳检验 | CausalModel、identify_effect、refute_estimate |
| EconML | 异质性估计 | DML、DR-Learner、因果森林、双稳健 IV、 ort ML | LinearDML、CausalForestDML、DRIV |
| causal-learn | 结构发现 | PC、GES、LiNGAM 等 | 命令式 API,输出 CPDAG |
| dowhy + EconML | 全流程 | DoWhy 的接口可直接挂 EconML 估计器 | estimate_effect 的 method_name |
| CausalML(Uber) | uplift 运营 | T/S/X-learner、TwoModel、Qini 评估 | uplift 度量与分桶工具 |
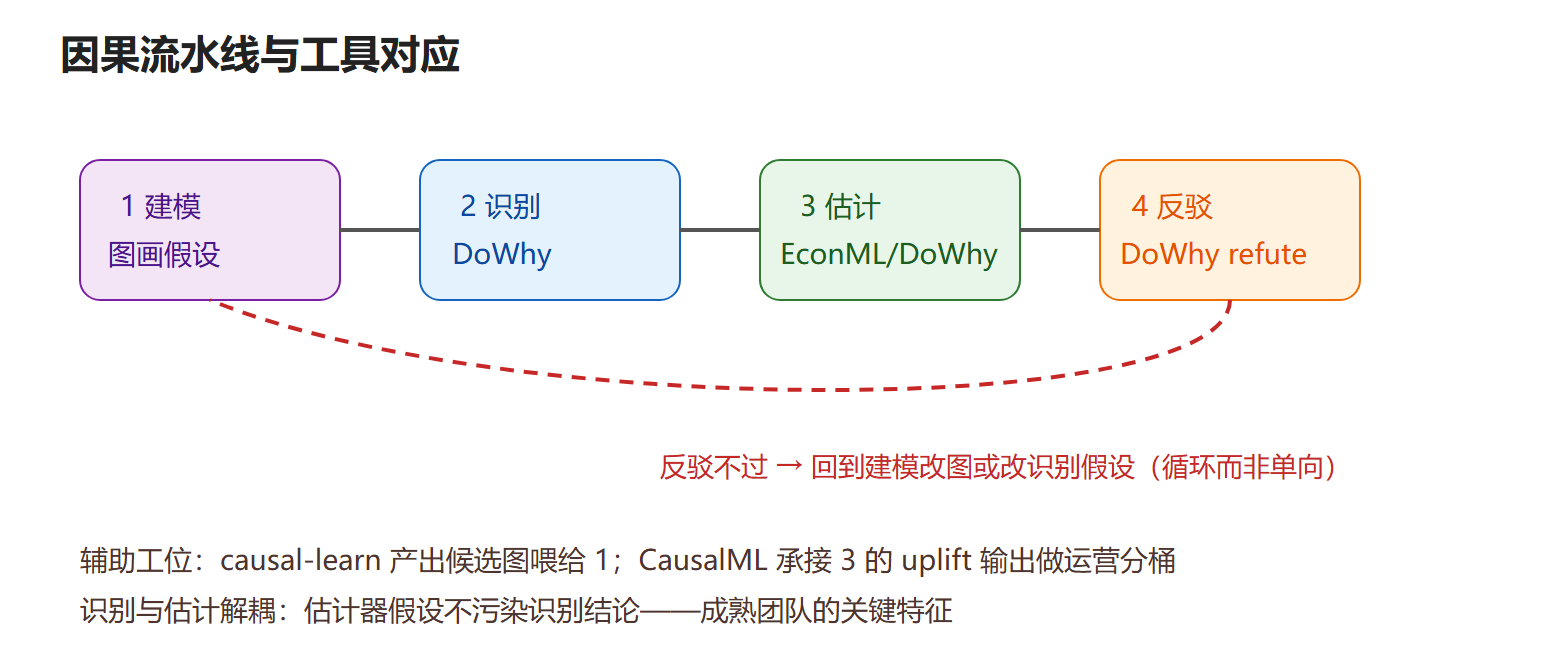
理解"工位"比记 API 重要。识别(第 3 章)与估计(第 4 章)在工具上的分离是有意设计:识别器输出的调整表达式可以被任意估计器消费;估计器的假设(线性、带宽、交叉拟合折数)不污染识别结论。评估一个团队的因果工程成熟度,看它是否把这两层显式分开就能猜出大半。
图:工具链在流程上的接缝
DoWhy 四步的概念代码
# 概念流程:DoWhy 建模-识别-估计-反驳(示意,参数名以官方文档为准) from dowhy import CausalModel import pandas as pd model = CausalModel( data=df, treatment="使用新功能", outcome="次月留存", common_causes=["活跃度", "设备档次", "注册时长"], # 图的口语输入:后门变量 ) # 识别:枚举所有可行调整策略 estimand = model.identify_effect(proceed_when_unidentifiable=True) print(estimand) # 输出后门调整/前门/IV 各策略与所需条件 # 估计:挂一个倾向得分匹配估计器 estimate = model.estimate_effect( estimand, method_name="backdoor.propensity_score_matching" ) print(estimate.value) # 反驳:自动稳健性流水线(第 4.6 节的工程化) for ref in ["random_common_cause", "placebo_treatment_refuter", "data_subset_refuter", "add_unobserved_common_cause"]: print(model.refute_estimate(estimand, estimate, method_name=ref))
四个反驳器的含义各对应前文的稳健性动作:随机公共原因(加一个无关变量看结论晃不晃)、安慰剂处理(把处理替换成随机数,效应应归零)、数据子集(抽样重估)、加未测混杂(模拟第 4.6 节 E-value 式的扰动)。把 refute 的输出连同识别假设一起写进报告,是 DoWhy 提倡的"先证伪再相信"工作流。
EconML:估计器选择的决策逻辑
EconML 的估计器按两个维度选择。干扰模型能力:线性(LinearDML)够用时最稳;非线性强用 ForestDML/神经版;目标量:平均与 CATE 用 DML 族;有工具时用 DML-IV 或 DRIV(双稳健 IV);预算约束下逐点处理策略评估看 DeepIV/DR-Learner。两个实践参数值得知道:cv 折数默认 2 可调到 5 换稳定性(第 4.3 节交叉拟合);inference='statsmodels' 打开时输出逐点置信区间,CATE 决策(第 5.1 节分桶)没有区间等于裸奔。当处理是离散策略集或多值,把处理编码为类别后大部分估计器接口不变。
FAQ 与升级路线
问题:只想要一个快速可跑的组合,怎么起步?
最小可用栈:DoWhy(识别与反驳)+ EconML 的 LinearDML(估计)+ 自己画的图(三五个关键变量起步)。跑通"识别表达式打印出来、两种估计器对照、四个反驳器全过"的闭环,再考虑换更强估计器或引入 causal-learn。多数团队的瓶颈在图画得潦草,不在估计器不够新。
问题:这些库能直接处理时变处理吗?
部分。EconML 有 DynamicDML 处理面板型时变处理;更一般的 g-计算与边际结构模型要自己按第 5.3 节框架拼(公式直观,工程量在数据整形成"人-期"长表)。选择器上认准支持面板输入的估计器,避免把时变数据压扁成横截面喂给静态估计器——那是最常见的用法错误。
从识别输出到估计输入的接口
DoWhy 与 EconML 的组合接缝长这样:identify_effect 返回的识别表达式声明了需要估计的统计量(如后门调整下的条件期望差);estimate_effect 通过 method_name 挂载具体估计器(EconML 的估计器可直接以"dowhy 的估计器包装"形式调用)。工程上值得做的封装:把"识别表达式 + 估计器 + 反驳结果"三件套序列化存档,形成每次因果分析的不可变记录——它同时是可复现实验日志与审计材料。库版本也要锁定:因果库的 API 变动频繁,识别输出格式跨版本不保证稳定,这是管线化时最实际的坑。
本节要点回顾
- 工位观:DoWhy 识别与反驳、EconML 异质性估计、causal-learn 结构发现、CausalML uplift 运营——不是竞品是流水线。
- DoWhy 四步:建模(图)→识别(枚举策略)→估计(可挂任意估计器)→反驳(四类自动稳健性检验)。
- EconML 两维度:干扰模型容量 × 目标量形态;打开推断输出拿置信区间。
- 解耦原则:识别层与估计层显式分离,是因果工程质量的可检验标志。