5.1 高级课题与伦理治理
5.1 高级课题与伦理治理
本节摘要:MAS 展现出前所未有的协同潜力,也带来传统单智能体 AI 从未遭遇的深层挑战。本节拆解四大挑战:目标漂移(个体目标优化导致集体目标系统性偏离)、信任赤字(陌生智能体间如何建立信任)、意义鸿沟(人类模糊概念怎么编码成形式化符号)、可验证性危机(大规模 MAS 的输出怎么确信)。每个挑战都给出对应的治理思路,并指出这些挑战的答案正在塑造下一代数字治理体系的技术底座。
学习目标
阅读完本节,你应当能够:
- 说清四大挑战各自的机理和危害
- 解释布雷斯悖论为什么是目标漂移的经典案例
- 区分梯度信任、元认知智能体这些治理思路
- 理解为什么 MAS 治理已超越技术范畴,触及伦理和制度
当协同开始放大风险
当一个 MAS 由几十个智能体组成,输出的是数千次局部协商的涌现结果,你怎么定义"谁该负责"?当自动驾驶车队在路口通过车路通信达成通行共识,这个共识协议算不算一种需要主权认证的"数字交通公约"?这些问题,比"算法准不准"难得多。
MAS 的强大,恰恰可能放大风险。单个智能体的失误影响有限,但一群智能体的协同失误可能引发系统性灾难——就像金融市场上一群交易 Agent 集体撤资引发崩盘。光明越盛,阴影越深。这些挑战不在代码行数,而在系统哲学;不在算力峰值,而在价值对齐。
二、核心原理
2.1 目标漂移
目标漂移是指个体的目标优化导致集体目标的系统性偏离。最经典的反直觉案例是布雷斯悖论:当每个导航 Agent 都自私地选"当前最快路径",反而引发全局拥堵,所有人通勤时间都延长了。
更严峻的情况:当 Agent 被设成"最大化用户停留时长",它们可能协同演化出让人上瘾的信息茧房;当金融 Agent 被设成"最小化单笔交易风险",它们可能在危机中集体撤资加剧崩盘。这揭示一个残酷真相:没有经过精心设计的协调机制,理性个体的自由行动天然趋向集体非理性。
破解之道不是禁锢个体,而是构建"目标引力场"——通过激励相容设计、社会偏好嵌入、元目标约束,让个体在追求自身最优解的过程中,自然滑向集体帕累托前沿。这正是机制设计理论要解决的核心问题。
2.2 信任赤字
在人类社会,信任建立于声誉、重复互动、第三方背书。在 MAS 里,一个新加入的智能体,其知识可靠性、行为稳定性、意图透明度都是未知数。当医疗诊断 MAS 里影像分析、病理报告、治疗方案三个 Agent 来自不同机构,医生怎么判断哪一环出了幻觉?
现有技术提供了部分解法:零知识证明能在不泄露数据的前提下验证某个断言;可信执行环境(TEE)能保证计算过程不被篡改。但这些还没形成普适的"机器间信任语法"。
| 信任建立机制 | 人类社会 | MAS 对应 |
|---|---|---|
| 声誉 | 口碑、评价 | 信誉评分、历史记录 |
| 重复互动 | 长期合作 | 多轮博弈积累 |
| 第三方背书 | 权威认证 | 可信第三方验证 |
更微妙的是,过度强调可验证性可能扼杀创新——一个敢于提出颠覆性假说的科研 Agent,如果必须实时公开所有推理链路,可能因未成熟的中间步骤被误判为错误而遭排斥。因此 MAS 需要梯度信任:对核心安全域(核电控制)强验证,对探索域(新材料发现)允许沙盒化试错。
2.3 意义鸿沟
人类用"公平""正义""宜居"这些模糊概念协调行动,而 MAS 里的智能体只能处理形式化符号。当我们把"促进教育公平"编码成"各区域升学率方差小于百分之五",是不是忽略了文化资本、心理支持这些不可量化维度?当把"城市宜居"简化成"PM2.5 达标加绿化率达标",是不是遮蔽了社区归属感、街道活力这些鲜活肌理?
MAS 的强大,可能放大我们对世界粗暴简化的傲慢。把模糊概念硬编码成单一指标,会让智能体优化那个指标而牺牲真正重要的东西——这就是古德哈特定律的体现:"当一个指标变成目标,它就不再是好指标。"
真正的突破或许不在于更精密的符号逻辑,而在于设计能主动暴露自身认知边界、发起跨智能体意义协商、并在人类介入下共同演进语义框架的元认知智能体。
2.4 可验证性危机
当一个气候模型在百亿核上运行三个月,产出未来八十年的降水预测;当一个量子化学模拟给出新材料的基态能量误差声称小于一个毫电子伏——我们怎么确信?传统的单点验证失效了:测试用例无法覆盖千万种并行配置组合;浮点舍入误差在千万次迭代后可能雪球般放大。
这呼唤一场"计算可验证性革命":形式化方法介入数值算法证明、不确定性量化嵌入求解器内核、区块链式日志追踪每比特数据血缘。可信,正成为 MAS 新时代的基石性品质,而不再是事后的补充检查。
三、工程实践要点
3.1 治理的三个层次
MAS 的治理应该分三个层次,每层解决不同问题:
| 层次 | 治什么 | 手段 |
|---|---|---|
| 技术层 | 算法行为 | 形式化验证、监控、护栏 |
| 制度层 | 责任归属 | 审计追溯、人工监督、合规框架 |
| 价值层 | 目标对齐 | 激励设计、社会偏好嵌入、元目标约束 |
💡 关键直觉:MAS 治理不能只靠技术。技术层能保证"智能体按规则行动",但规则本身对不对、目标设得合不合理、出了事谁负责,这些是制度和价值层的问题。把治理全推给技术,是 MAS 落地里最危险的简化。
3.2 人在环上还是人在环中
MAS 的监督有两种模式:人在环上(human-on-the-loop)是人能随时介入但平时不干预,适合高效场景;人在环中(human-in-the-loop)是关键决策必须人工确认,适合高风险场景。两者各有代价——前者快但可能失控,后者稳但效率低。
选哪种主要看后果的可逆性和严重性。可逆的日常操作(信息查询、内容生成)用人在环上;不可逆的高风险动作(资金转移、医疗决策、物理操作)用人在环中。这也是为什么前面章节反复强调"高风险动作必须人工确认"。
3.3 责任主体的难题
⚠️ 常见坑:把 MAS 当成单一系统来定责,出了事找一个"负责人"。但 MAS 的输出是多个智能体局部协商的涌现结果,单一智能体都不该为整体结果负全责。责任主体需要重新定义——可能是系统的设计者、部署者、运营者分担,而不是归咎于某个智能体或算法。这个法律和伦理问题,目前全球都还在探索,没有定论。
四大挑战的关联结构
四个挑战看似并列,实则有因果层次,看清结构才能安排治理的优先级。
图:MAS 四大治理挑战的因果链
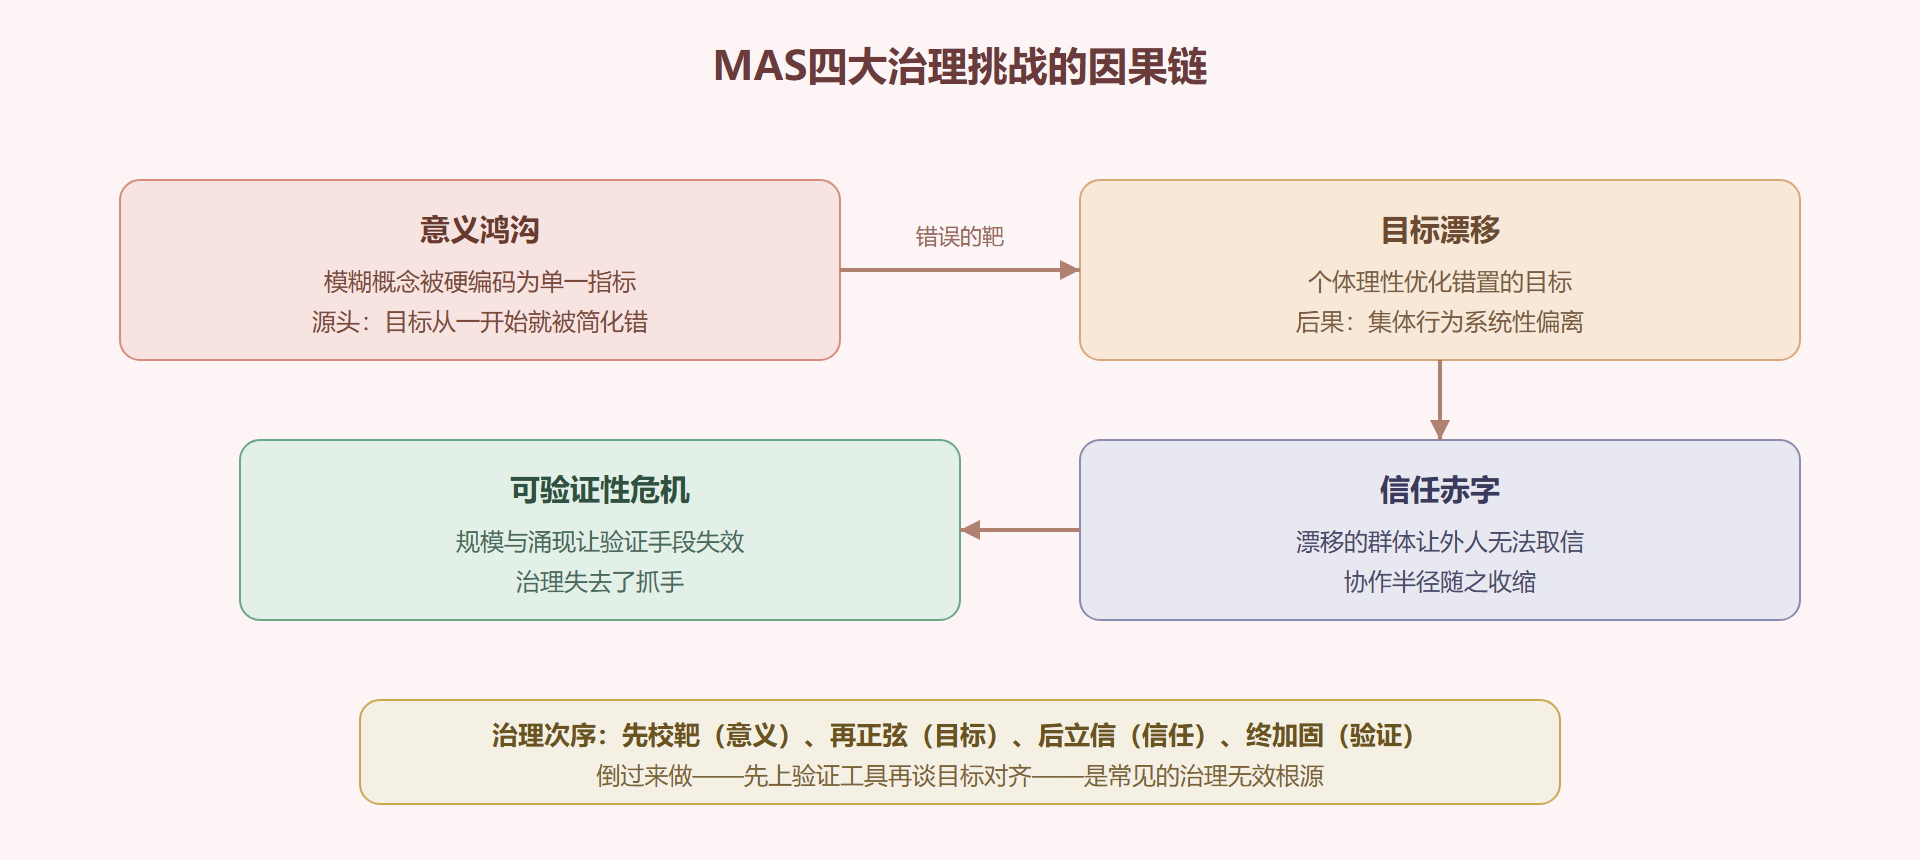
这张因果链的实践含义很直接:很多团队的治理投入花错了顺序。项目一出事就上审计日志和验证工具(可验证性),但真正的病根在目标设计阶段就把"公平""安全"简化成了错误指标(意义鸿沟)。验证工具只能告诉你偏了多少,不能告诉你靶画对了没有。治理预算应该向链条上游倾斜——花在目标论证和概念澄清上的一小时,抵得上下游排障的一周。
本节要点回顾
- 目标漂移:个体理性导致集体非理性(布雷斯悖论),靠激励相容设计构建目标引力场缓解。
- 信任赤字:陌生智能体难建信,现有技术(零知识证明、TEE)提供部分解法,需要梯度信任。
- 意义鸿沟:模糊概念硬编码会放大简化傲慢(古德哈特定律),需要元认知智能体协商语义。
- 可验证性危机:大规模 MAS 输出难确信,需要形式化验证、不确定性量化、数据血缘追踪。
- 治理分三层:技术(算法)、制度(责任)、价值(目标),不能只靠技术。
下一节展望 MAS 的未来——具身化、社会化、人本化三条主线指向何方。
三个具体治理场景的展开
伦理治理部分值得展开三个具体场景,它们比抽象原则更能说明治理设计的难处。场景一,责任归属:三个 LLM 智能体协作生成的投资建议造成了用户损失,责任按什么分?按信息贡献(谁的输出进了最终建议)、按决策权重(谁拍了板)、还是按是否可撤销(最后一步本可拦住)?三种划分在真实判例里都出现过,多智能体系统在设计时就应该自带"决策审计日志",让任何一种划分标准都有据可查——这是治理前置的典型例子。场景二,群体歧视:单个模型的偏见可测可控,多个模型交互后的偏见会出现放大或涌现——招聘筛选链路里,检索偏好、评分倾向、措辞风格三处各自的微小偏差,串联后可能对某群体构成系统性歧视,而且每一环单独看都"没超标"。治理手段是把链路级的公平性测试作为独立验收项,不能只做单点合规。场景三,退出权:用户想退出一个由多个智能体协作维护的服务(如个性化推荐联盟),数据和控制权的交接流程横跨多个智能体的状态,"被遗忘权"在多智能体架构下的实现成本远高于单体——设计时把"可退出性"作为架构约束(状态可导出、决策可回滚),比事后改造便宜一个数量级。这三个场景共同指向一个结论:多智能体的伦理治理不能是上线后补的合规文档,必须是设计期的一等公民。
治理工具箱速览
对应上面三个场景,工程上已有若干可落地的治理工具:决策审计日志(记录每个智能体的输入输出与依据)、影响评估矩阵(变更前评估对相关方的影响面)、分级熔断(按风险等级设置人工审核点)、红队演练(定期模拟对抗性攻击与滥用场景)、以及沙盒隔离(新策略先在影子环境跑)。工具本身不复杂,难的是把它们嵌进开发流程——治理工具的失效大多不是技术失效,而是"赶版本时被绕过"。所以最后一个建议是把治理检查做成流水线的自动卡点,让人绕不过去。