1.1 存储硬件演进与物理特性
1.1 存储硬件演进与物理特性
本节摘要:存储硬件决定了一切上层设计的物理边界。HDD 靠磁头机械寻道,顺序读写快、随机读写慢;SSD 用闪存消除了机械延迟,却引入写前擦除和写放大;NVMe 则用多队列协议把闪存的并行潜力释放出来。理解这三类介质在延迟、带宽、寿命上的数量级差异,是理解后面页缓存、WAL、LSM 树这些设计的起点。本节不背参数,而是讲清每种介质"最怕什么",以及这种恐惧如何一路传导到软件层。
学习目标
阅读完本节,你应当能够:
- 解释存储为什么必须分层,以及各层延迟的数量级关系
- 说明 HDD 的寻道与旋转延迟如何造成顺序读与随机读的鸿沟
- 说清 SSD 的页、块、写前擦除、写放大和擦写寿命
- 讲出 NVMe 多队列、命令精简相比 AHCI 的意义
- 判断一个负载是顺序型还是随机型,并据此预估它的硬件瓶颈
一、问题与直觉:为什么不能让 CPU 直接读硬盘
先问一个听起来有点傻的问题:为什么数据库不把整张表都塞进内存,让每次查询零等待?
答案不是"内存太贵"这四个字能概括的。更根本的原因藏在延迟的数量级里。读一次 L1 缓存大约要 0.5 纳秒,读一次主存要 50 纳秒左右,而读一块本地 NVMe SSD 上的随机数据要 80 微秒上下,换成机械硬盘则直奔 8 毫秒。从纳秒到毫秒,中间隔了六个数量级。这六个数量级不是工程偷懒没优化好,而是半导体载流子、电容充放电、机械惯性和角速度这些物理参数钉死的。
所以我们面对的从来不是一个"快慢"问题,而是一个"分层"问题。快的介质又小又贵,慢的介质又大又便宜,二者没法合成一个。系统只能把经常访问的热数据往上搬、往缓存里放,把不常碰的冷数据沉到磁盘、甚至归档到磁带。这一节的主角,就是磁盘这一层——绝大多数数据库数据最终栖息的地方。
它分三代:机械硬盘、闪存固态盘、以及跑在 NVMe 协议上的固态盘。三代不是简单的替换,而是每一代都在消掉一种上一代绕不开的代价,同时又把自己新引入的代价甩给上层软件。
二、HDD:一个靠机械臂找数据的仓库
把机械硬盘想象成一个巨大的、旋转着的圆形仓库。货架是磁道,一圈圈从里到外排开;读写头就是那个机械臂,它得先横移到正确的磁道,再等盘片转到目标扇区正下方,才能开始取数。
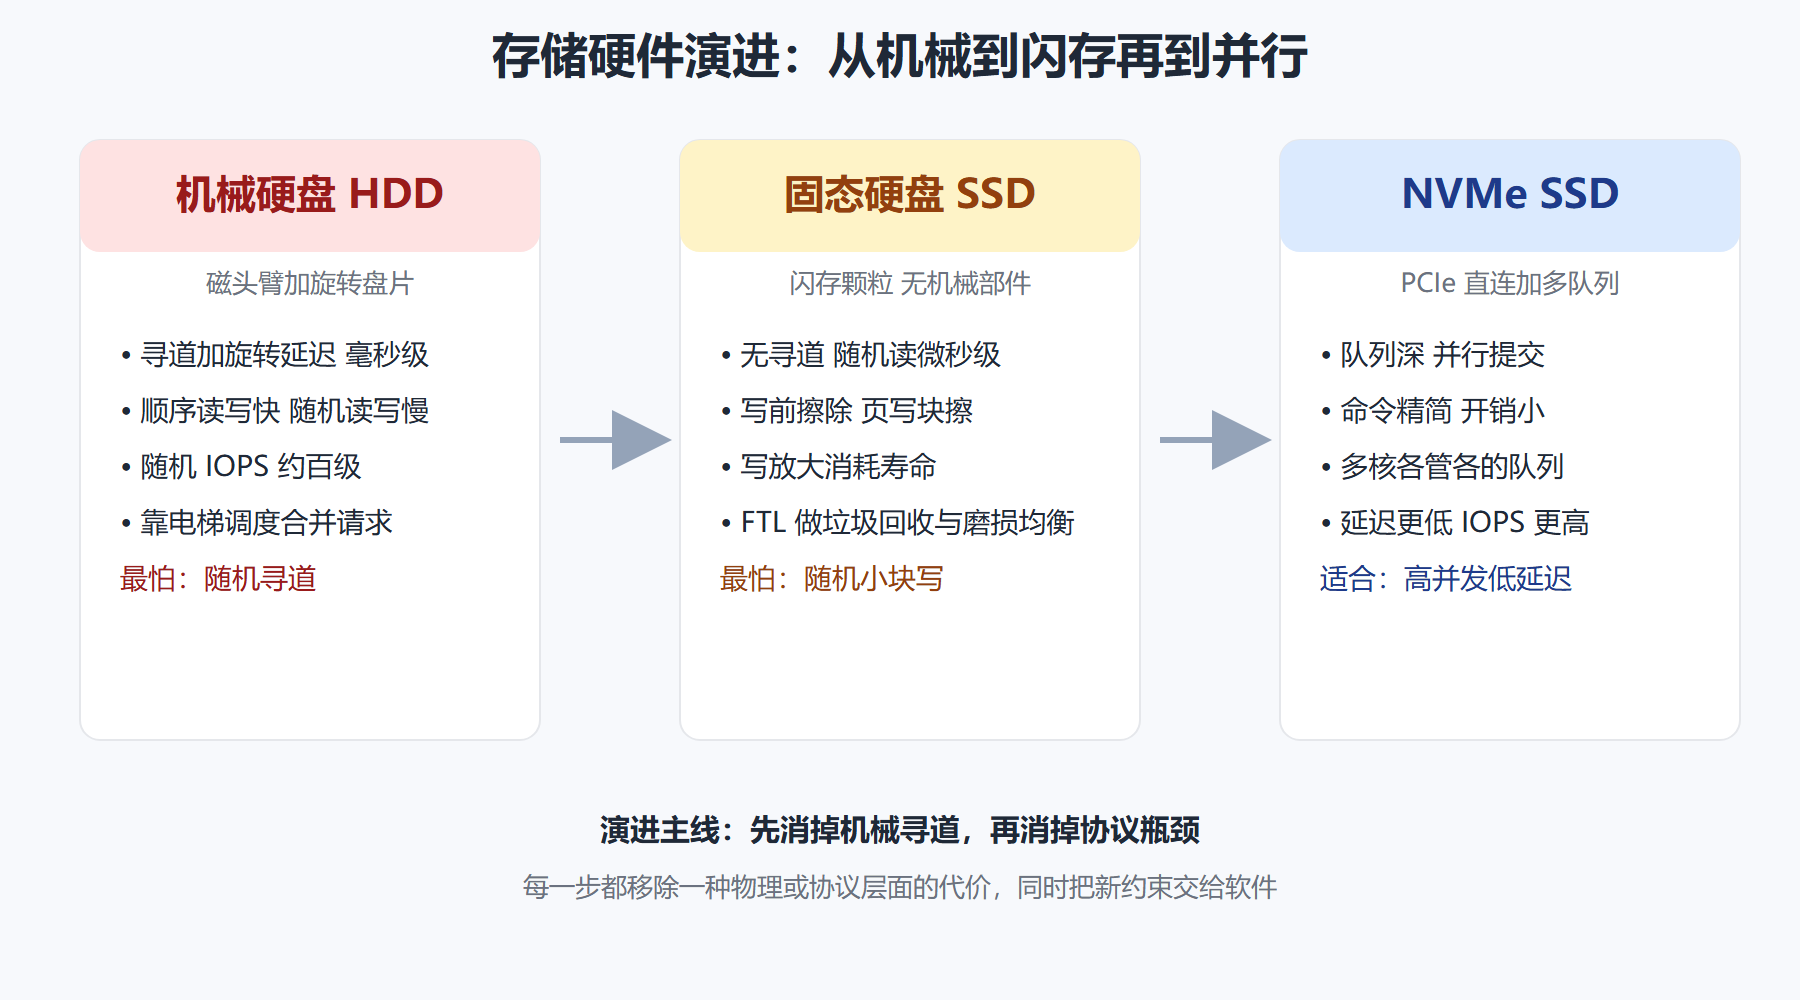
这两个动作各有一个专业名字:横移叫寻道,等待盘片转到位置叫旋转延迟。它们都是毫秒级的。一块 7200 转的盘,转一圈要 8.33 毫秒,平均下来等半圈就是 4 毫秒多一点。再加上寻道几毫秒,一次随机读光"找人"就花掉接近 10 毫秒——这还没算真正读数据的传输时间。
这就是顺序和随机的本质区别。顺序读是磁头停在一条磁道上,数据自己排着队从底下流过,几乎不浪费寻道和旋转;随机读则是磁头满盘跳,每一次跳都要重新付一遍"找人"的成本。于是同样的机械硬盘,顺序读能做到每秒几百 MB,随机读却只能每秒一两百次,差了三四个数量级。
这个特性对软件的影响极其深远。早期的数据库设计几乎都是在躲寻道:B+ 树拼命压矮树高,就是为了让一次查找少跳几次磁头;日志必须顺序追加,就是为了把写变成"顺着轨道扫"而不是"满盘打洞"。直到今天,理解"随机贵、顺序便宜"依然是读一切存储设计的入场券。
三、SSD:写前擦除与写放大
固态盘直接把机械臂这一层物理结构连根拔掉了。它里面是闪存颗粒,读写靠电荷,没有移动部件,所以随机读再也不用等磁头——延迟一下子从毫秒掉到微秒级。
但闪存有自己的脾气,而且这个脾气很硬:它读和写都以"页"为单位,一般是 4KB 上下;擦除却必须以"块"为单位,一个块通常装几十上百个页。更关键的是,闪存单元一旦写过,就不能原地改写,必须先把整个块擦干净,再重新写入。这就是所谓的"写前擦除"铁律。
铁律带来的直接后果是写放大。假设你要改一个 4KB 的页,而它所在的块里还有 127 个别的页有数据。闪存控制器得先把这 128 个页里还有效的内容抄到别处,擦掉整块,再把新数据写回来。你只改了 4KB,底层却可能搬动了几百 KB。我们用"写放大"这个词衡量它:物理层实际写入的数据量,除以逻辑层你要写入的数据量。写放大越高,盘越不经用,也越慢。
为了对抗写放大,固态盘里住着一个看不见的管家,叫 FTL(闪存转换层)。它把逻辑地址和物理地址的映射攥在自己手里,负责垃圾回收、坏块管理和磨损均衡。它的存在也解释了为什么顺序写对 SSD 依然友好:顺序写往往能把一整块填满再换下一块,垃圾回收时几乎没有"有效数据"需要搬;随机小块写则会把块打得支离破碎,让 FTL 不停地做无谓的搬运。
寿命也来自这个机制。每个闪存单元的擦写次数是有限的,TLC 每单元存 3 比特、寿命约千次量级,QLC 存 4 比特、寿命直接掉到几百次。这听着吓人,但磨损均衡会把写入摊到所有块上,让整块盘均匀老化。可一旦某个负载持续做高频随机小写,等于在给一小片区域"定点放疗",寿命和性能都会提前崩掉。
这些物理细节会一路顶到软件层。数据库的页大小,很多产品定在 8KB 或 16KB,一个原因就是让它和闪存的页、块对齐——页对齐了,一次写入正好落在整页上,少触发几次读改写,写放大就小一圈。反过来,如果软件层完全无视这些粒度,随意跨页写小块,FTL 就不得不频繁地读改写,性能和寿命一起往下掉。
| 单元类型 | 每单元比特 | 电荷档位 | 相对寿命 | 典型用途 |
|---|---|---|---|---|
| SLC | 1 | 2 | 高 | 企业级写缓存、日志区 |
| MLC | 2 | 4 | 较高 | 企业级数据盘 |
| TLC | 3 | 8 | 中 | 主流消费与企业 SSD |
| QLC | 4 | 16 | 低 | 大容量读密集型、冷数据 |
四、NVMe:为闪存重写一份协议
SSD 刚问世那几年,还套着为机械盘设计的旧协议在跑。AHCI 这套接口假设每台设备只有一个命令队列、一个中断源,主机一次只能排几条命令。机械盘因为自己就慢,这条单行道还凑合;可闪存内部有多个通道、多个闪存芯片能并行干活,单队列等于把并行的门焊死了一半。
NVMe 就是冲着这个来的。它不再迁就机械时代的假设,直接为闪存重新设计协议。三件事最关键:第一,队列数量从个位数放开到成千上万,每条队列还能排几万条命令,多核 CPU 每个核心各管各的队列,谁也不挡谁;第二,中断机制改成多消息的 MSI-X,让不同的核心处理不同的完成通知,省掉一把全局锁;第三,命令集从十几条常用命令出发,砍掉了柱面、磁头这些机械时代的遗产字段。
结果是延迟进一步下探,IOPS 冲上去。但协议给的是可能性,不是结果。要让 NVMe 真的快起来,软件栈也得跟着改:内核的块层调度器要适配多队列,应用侧最好用异步 I/O 一次性提交一大批请求。一个还停在"单线程同步读一条等一条"的老程序,跑在 NVMe 上照样快不起来。这也是为什么很多数据库的高性能版本会专门做异步 I/O 改造——不是因为喜欢折腾,而是因为不把提交队列喂饱,NVMe 的并行就白买了。
图1-2 存储硬件演进
五、把物理特性翻译成工程判断
讲完三代介质,最终要落回一句话:判断一个负载是顺序还是随机,决定了你会撞上哪种代价。
日志、WAL、追加写入,这些天生是顺序写,几乎不触发写放大,也避开了机械寻道,是存储最欢迎的客人。反过来,索引的随机更新、点查、频繁的原地改写,这些负载会直接踩中随机寻道或写放大,是最难伺候的。数据库引擎的很多设计——LSM 树把随机写转成顺序写,B+ 树用缓冲池攒够一批再刷盘——说到底都是在做同一件事:把上层无法避免的随机,在落到硬件之前尽量揉成顺序。
所以选型和调参时,我习惯先回答三个问题:这个负载的读写比是多少?写是顺序追加还是原地改小块?数据量相对内存是大还是小?答完这三个,该用机械盘还是 NVMe、该不该开写缓存、该把日志和数据分开放还是合在一张盘上,答案基本就浮出来了。
举个例子。一个写多读少的时序数据库,每秒追加大量采样点,日志和数据的写路径几乎全是顺序追加。这种负载放在机械盘上都能跑得不错,因为顺序写恰好是机械盘唯一擅长的东西;反过来,一个高频点查的键值存储,每一次查询都是随机读,机械盘会立刻被寻道拖垮,NVMe 才是它的基本盘。想清楚负载形态,选介质这件事就从"拍脑袋"变成了"对号入座"。
⚠️ 常见坑:以为"写到 SSD 就安全了"。SSD 内部还有一层易失的写缓存,掉电时缓存在里面、还没落进闪存颗粒的数据会丢。真正要持久化,得让软件显式发出刷新命令(比如数据库的 fsync 语义),把缓存冲刷到介质上。
💡 关键直觉:顺序写是所有介质共同的"甜点区"。凡是能把随机写改造成顺序写的设计,几乎都能同时降低延迟、抬高吞吐、延长寿命,一箭三雕。
要点速记
- 分层是物理逼出来的:CPU 缓存、内存、SSD、机械盘的延迟相差好几个数量级,谁也无法同时兼顾快和大
- HDD 怕随机寻道:磁头臂横移和盘片旋转都是毫秒级,顺序读写远快于随机读写
- SSD 怕写前擦除:页写块擦的铁律带来写放大,FTL 用垃圾回收和磨损均衡兜底
- 寿命来自擦写次数:TLC 约千次、QLC 约几百次,高频随机小写会加速局部老化
- NVMe 释放并行:多队列、多中断、命令精简,让多核 CPU 能同时向闪存发请求
- 顺序写是甜点区:把随机改造成顺序,是存储引擎设计的一条黄金主线
摸清了硬件这层,下一步就该看操作系统怎么把它包装成软件能用的接口——那里才是数据库每天真正打交道的地方。
下一节,我们将走进操作系统层面的存储抽象,看文件、页缓存、mmap 和 fsync 如何在硬件之上搭起一座桥梁。