6.1 云原生数据库
6.1 云原生数据库
本节摘要:云原生数据库的核心不是"上云",而是把计算与存储拆成两个能各自伸缩的池子。拆开之后,扩容不用再搬全量数据,故障恢复不用重建整台机器,Serverless 计费也才成为可能。本节从一次真实的扩容事故讲起,讲清存算分离到底拆掉了什么、带来了什么新代价,以及弹性伸缩与 Serverless 背后的技术前提和常见坑。读完后,你应当能判断自己的业务到底该拆还是不该拆,拆了之后又要付什么样的延迟账单。
本节地图
阅读完本节,你应当能够:
- 说出存算分离与传统一体机架构的本质区别
- 解释为什么存算分离能把扩容从小时级降到分钟级
- 说清存算分离引入的新代价,尤其是网络延迟和日志瓶颈
- 理解弹性伸缩与 Serverless 计费依赖哪些技术前提
- 判断一个业务是否值得迁移到云原生数据库
一、从一次扩容事故说起
先讲一个我经历过的场景。一家电商公司,数据库跑在自建机房的物理机上,主库加一台只读从库。平时相安无事,直到一次大促,下单量一夜之间涨了五倍,主库 CPU 直接打满,慢查询堆成山。DBA 的第一反应是加只读节点——但只读节点要先把主库的全量数据复制过去,几个 TB 的数据在千兆内网里拷贝,等它追平日志位点,大促高峰早就过去了。最后只能用限流硬扛,眼睁睁看着一部分订单被拒。
这个场景里有三个绕不过去的矛盾,它们是传统架构与生俱来的。
第一,计算和存储绑在同一台机器上。CPU 不够了,你得整机升级或者加机器,但加机器就得把数据也搬过去,因为数据是"长"在本地磁盘上的。
第二,扩容是有损的、慢的。数据迁移期间,要么停机,要么冒着主从延迟不一致的风险,总之做不到"点一下按钮就完成"。
第三,资源利用率天然偏低。为了扛住峰值,你得按峰值买机器,平时大部分时间 CPU 都闲着;反过来,存储快满的时候,你可能被迫加一台新机器,只为多一块盘,CPU 又浪费了。
云原生数据库要解决的就是这三件事。它没有发明什么新算法,而是换了一个组织方式:把"计算"和"存储"这两个一直黏在一起的东西拆开,让它们各自独立地伸缩、独立地计费。拆开之后,加计算节点只需要从共享存储里拉增量日志、重建本地缓存,几分钟甚至几秒就能上线,不用再搬全量数据。
二、存算分离:拆掉的是什么
传统的单机数据库,比如早期的 MySQL,存储引擎和查询执行器跑在同一个进程里,共享同一块缓冲池,也共享同一块本地磁盘。写入走 WAL 日志,数据页落在本地文件里。这套设计在单机上非常高效,因为内存和磁盘都近在咫尺,一次读盘就是一次本地 I/O。但它的代价是"铁板一块":计算离不开存储,存储也离不开计算。
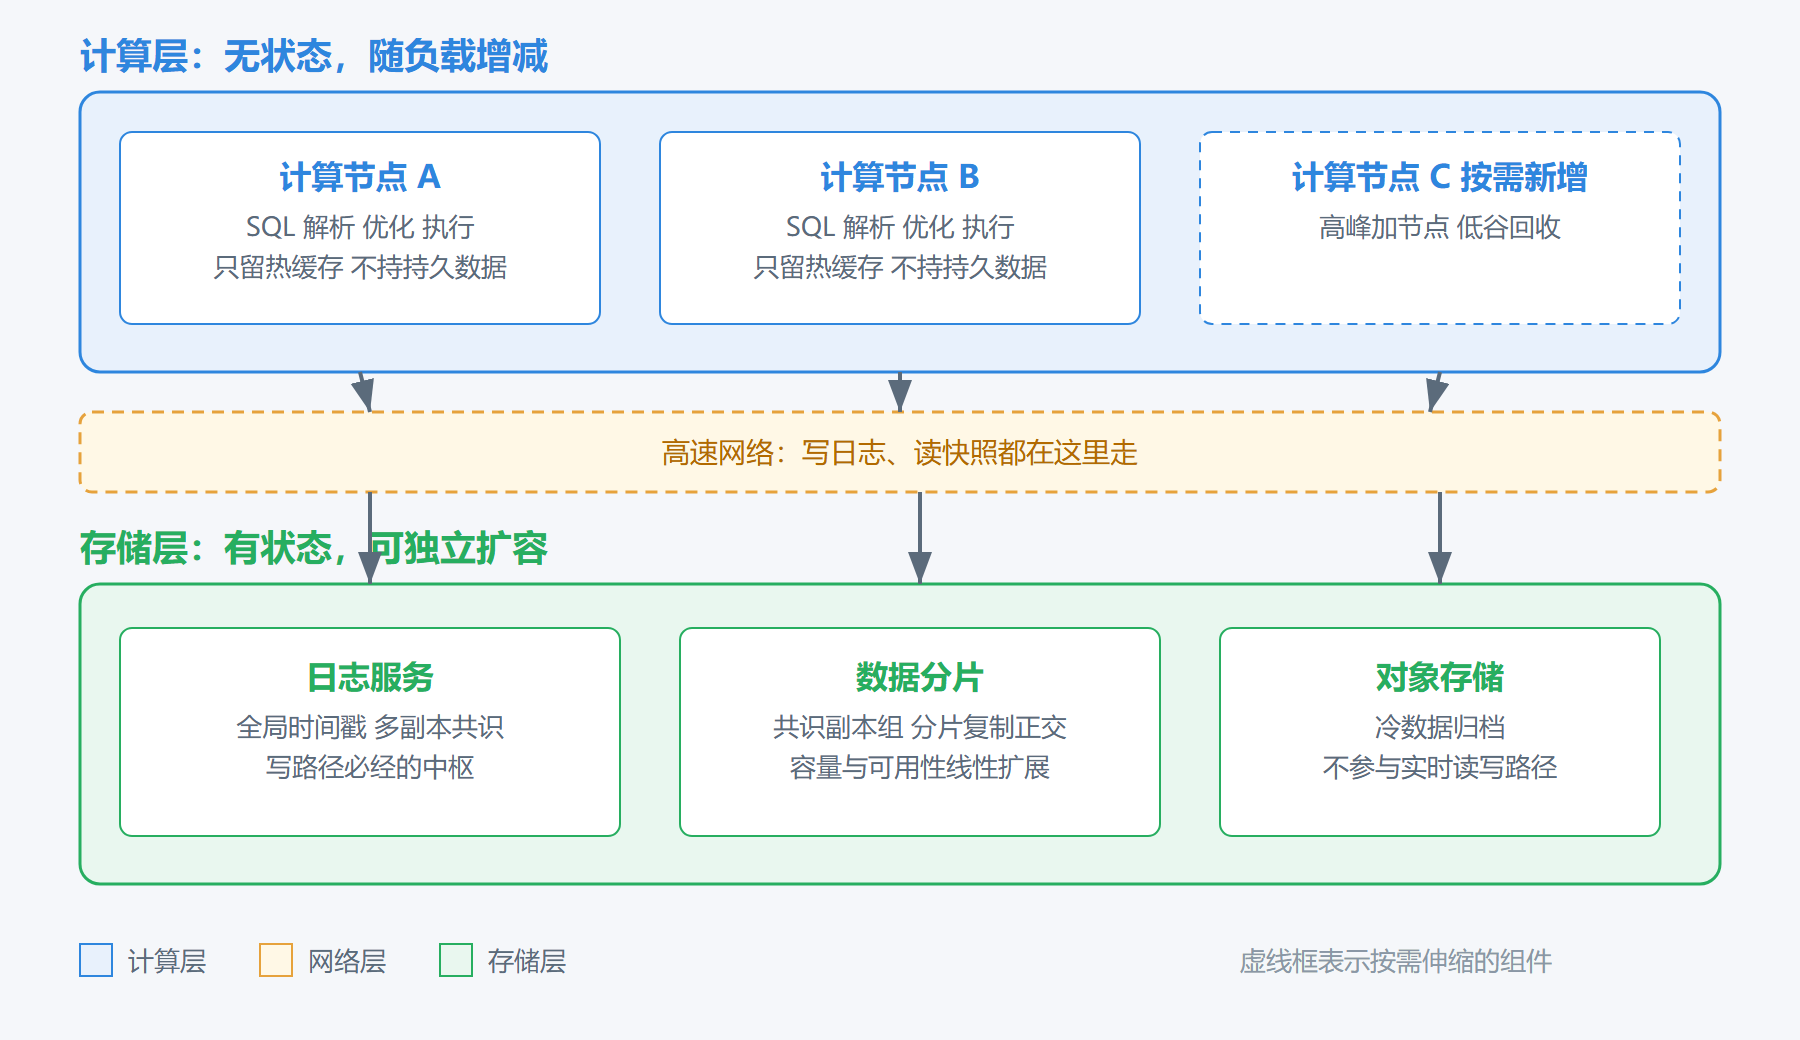
存算分离做的第一件事,是把持久化的责任从计算节点手里拿走,交给一个独立的存储层。计算节点从此不持有持久数据,本地只留热缓存和执行上下文;所有事务提交都先写进远端的高可用日志服务,由日志服务负责复制和持久化,再由存储层异步构建索引、把冷数据归档到对象存储。
这个转变听起来只是挪了挪位置,实际它重构了 ACID 的实现路径。在存算分离架构里,事务的时间戳由日志服务统一分配、单调递增;读请求带着一个快照时间戳去存储层取数,自然就得到了快照隔离。更强的可串行化则在计算层做轻量冲突检测,不用再靠一把大锁去阻塞等待。换句话说,一致性这件事被"下沉"到了日志和存储层,计算层因此变得可以随时启停、随时漂移。
下面这张图是存算分离的基本形态:计算层在上面,存储层在下面,中间靠高速网络连接。注意三个计算节点长得一模一样,都是无状态的——这是它能秒级伸缩的关键。
图 6.1-1 存算分离架构示意
拆开之后,数据流变成了下面这样。写入路径和读取路径分开了,两条路径都绕着日志服务和存储分片走。
这套架构不是纸上谈兵,几个有代表性的系统各有侧重。Aurora 走的是"高性能单体库云化"路线:它保持 MySQL 和 PostgreSQL 的协议兼容,但把日志处理下沉到存储层,计算节点只发逻辑日志,由存储节点负责物理页转换、复制和持久化,借此减少了网络上传的数据量。PolarDB 思路类似,用共享存储加一堆只读节点,读扩展靠加只读节点解决。Snowflake 更彻底,直接拆成虚拟仓库加共享数据层,计算按秒启停。TiDB 则把计算节点和存储节点分成两个独立进程,各自独立扩缩。它们的共同点只有一个:计算和存储不再绑死。
三、弹性与 Serverless:拆开之后才能做的事
存算分离是地基,弹性伸缩和 Serverless 是盖在这地基上的两层楼。
弹性伸缩分三个维度。横向加节点最简单,因为节点无状态,拉增量日志就能上线;纵向调整资源,是给单个计算节点动态增减 CPU 和内存配额;时间维度则是按历史负载预测,在高峰前自动预热、低谷后自动缩容。三个维度里,横向是主角,因为它最直接地解决了开头的扩容问题。
但弹性有一个前提,就是多租户隔离。当一个计算池被几十个租户共享,一个租户的突发查询风暴就可能拖垮邻居,这就是所谓的"邻居效应"。所以云原生数据库要做一套隔离栈:CPU 用加权公平队列,内存用硬配额加自适应淘汰,I/O 用令牌桶按租户限 IOPS,网络在虚拟私有云里做细粒度限速,元数据做逻辑分区。缺了这套隔离,弹性越大,公地悲剧越严重。
再往上,还有一层查询熔断。一个跑几个小时的大查询,会霸占整个计算池的资源,所以系统给每条查询设资源预算——最大内存、最长执行时间、最大扫描行数,任一维度超限就立即终止。这比事后调优更管用,因为它把"防止单个查询拖垮全局"写进了执行器里。
Serverless 是弹性的极端形态。它把"按量计费"从口号变成了真的:计算资源可以缩到零,业务没流量时几乎不花钱,流量来了再自动唤醒。Aurora Serverless、Neon 这类系统做的就是这个。但 Serverless 有一个绕不开的坑,就是冷启动——实例从零唤醒要重新拉起进程、重建连接和缓存,短则几百毫秒,长则几秒。对一个把延迟看得极重的在线业务,这几次冷启动的抖动可能比省下的钱更值钱。
下面这张表把三种形态放在一起看,选型时对照一下会清楚很多。
| 维度 | 一体机数据库 | 存算分离数据库 | Serverless 数据库 |
|---|---|---|---|
| 扩容方式 | 加机器、搬数据 | 加无状态计算节点 | 自动唤醒、按需伸缩 |
| 扩容耗时 | 小时级 | 分钟级 | 秒到分钟级 |
| 资源利用 | 按峰值预留,平时闲置 | 计算存储各自伸缩 | 可缩到零,按量计费 |
| 新增代价 | 无 | 网络往返延迟 | 冷启动抖动 |
| 适合场景 | 数据量小、延迟极敏感 | 负载波动大、规模增长 | 低频、间歇、成本敏感 |
四、代价与取舍:别把云想得太轻松
拆开不是免费的。存算分离把本地 I/O 换成了网络往返,网络延迟成了新的延迟基线。对于一条只读写几行的小事务,本地 I/O 可能只要几十微秒,跨可用区的网络往返却要几百微秒甚至几毫秒,延迟直接放大一个数量级。这就是为什么存算分离的数据库,写路径大多做了批量和流水线,把多次往返合并成一次。
第二个代价是日志服务成了关键路径。它虽然做了多副本,但所有写入都要经过它,它是性能意义上的单点。日志服务一旦抖动,整个库的写入都跟着抖。所以这类系统的日志层,往往是投入最重、也最难做好的一块。
第三个代价是跨分片查询。数据被切成很多分片后,一个跨分片的 JOIN 要协调多个分片的快照视图,复杂度和延迟都上去了。这不是存算分离独有的问题,但存算分离之后,分片数量通常更多,问题更明显。
最后一个代价不在技术里,而在商务上:云原生数据库和云厂商绑定很深,迁移成本高。用惯了某家的存储格式、权限体系、自动扩缩能力,想换一家或者迁回本地,往往要脱一层皮。
顺带说一个容易被忽略的好处:存算分离之后,写放大往往变小了。传统主从复制要把 WAL 和数据页都往从库传一份,存算分离里计算节点只发一条逻辑日志,物理页的多次修改由存储层在远端合并,网络上传的数据量反而更少。这也是 Aurora 一类系统吞吐提升的来源之一。
所以我的判断标准很简单:数据量大到单机扛不住、负载波动明显、团队愿意接受网络延迟和云绑定的,上存算分离划算;数据量小、延迟极敏感、或者有强合规要求必须数据落本地的,留在传统架构更省心。
⚠️ 常见坑:把传统库原样塞进容器或虚拟机,就以为是云原生了。这只是换了个运行环境,没有存算分离,也没有弹性,还多了一层编排的复杂度。
💡 关键直觉:存算分离的收益来自"解耦之后,计算和存储各自按最经济的方式伸缩";它的代价是"用网络往返换掉了本地 I/O"。判断要不要拆,本质是在算这笔账划不划算。
一节小结
- 存算分离:把持久化责任从计算节点剥离,交给独立的日志服务和存储层,计算节点变无状态。
- 日志即数据库:事务时间戳由日志服务统一分配,读请求带快照时间戳取数,一致性被下沉到日志与存储层。
- 弹性伸缩:横向加节点、纵向调资源、时间维度预热三个方向,前提是多租户隔离和查询熔断。
- Serverless:弹性的极端形态,可缩到零、按量计费,代价是冷启动抖动。
- 代价:网络延迟成为新基线,日志服务是性能单点,跨分片查询更复杂,云厂商绑定深。
- 判断标准:数据量大、负载波动、能接受网络延迟的选存算分离;数据量小、延迟敏感、要落本地的留传统架构。
下一节我们看内存数据库。它走的是另一条路:不拆计算和存储,而是干脆把磁盘从主路径上踢掉,让内存当一级存储——这背后有它自己的硬件前提和一堆新的坑。