7.1 基准测试与性能分析
7.1 基准测试与性能分析
本节摘要:基准测试回答"这个系统到底能扛多少",性能分析回答"它慢在哪、为什么慢"。二者常被混为一谈,其实是两种动作:前者用标准化负载(TPC-C、YCSB、TPC-H)或自定义脚本,在可复现条件下测出吞吐、延迟、并发、IO 等维度的基线;后者用采样和火焰图把一次慢请求拆开,定位到锁竞争、磁盘 IO 还是 CPU 计算。本节先讲维度与标准,再讲瓶颈定位的方法,最后落到怎么避开"平均值幻觉"和"局部最优"这两个最常见的坑。
读前必看(上)
阅读完本节,你应当能够:
- 说清吞吐、延迟、并发、IO 这几个维度分别衡量什么,以及为什么 P99 比平均值更值得看
- 区分 TPC-C、YCSB、TPC-H 三类基准各自模拟的负载与适用场景
- 为一次压测设定明确的目标和判定标准,而不是盲目追求高分
- 用采样和火焰图的思路,把"某处慢了"定位到具体环节
- 避开基准测试与调优里最常见的两个坑:平均值幻觉、局部最优
一、"跑得动"离"跑得好"还差一把尺子
我们都有过这样的经历:系统在测试环境好好的,一上生产、一到促销,就卡。追着日志看半天,最后发现是某个查询突然变慢、某块磁盘被打满。回头想复盘,却发现自己手上根本没有一套"这台机器、这个库到底能扛多少"的数字。于是每次扩容、每次上线都像开盲盒——凭感觉加机器,凭运气熬过高峰。
这就是基准测试存在的理由。它不负责把系统变快,它负责给你一把刻度明确的尺子:在相同条件、相同规则下,这个系统每秒能处理多少事务、单个请求要等多久、能吃多大并发、磁盘和 CPU 各消耗多少。有了这把尺子,扩容可以提前估算,上线可以前后对比,慢的问题可以复现给所有人看,而不是复述给所有人听。
但这里有个更隐蔽的问题,比"要不要测"更值得先想清楚:测什么。很多人一提压测就想到一个 QPS 数字,好像数字越大越好。其实那只是吞吐一个维度。真正撑起性能判断的,是好几个维度一起看,缺一个都会得出错结论。下面这张图把必须分开看的维度摆出来。
图 7.1 基准测试的六个维度
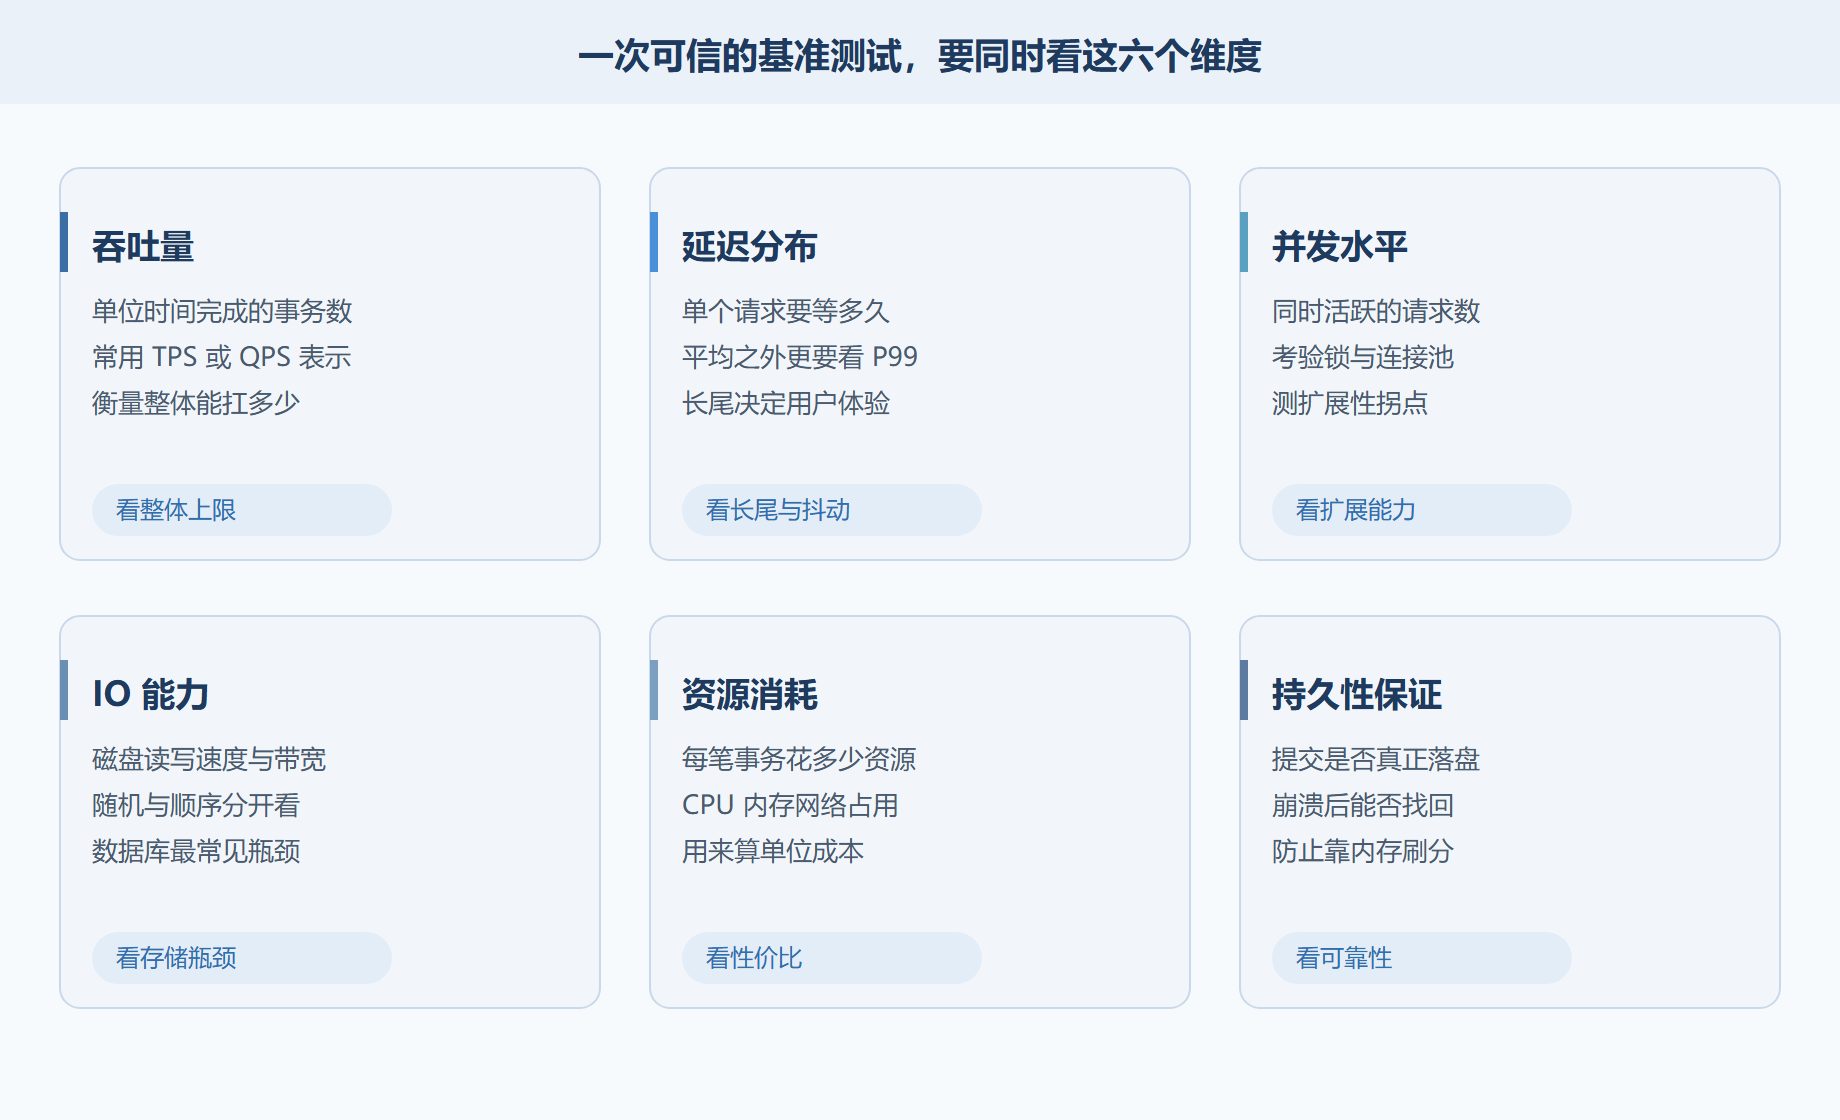
先把吞吐和延迟这一对最基本的矛盾说清楚。吞吐是"单位时间完成多少",延迟是"单个请求要等多久",二者不是一回事。它们之间隔着一个排队:负载一高,请求就会在队列里堆积,延迟被排队放大。所以高吞吐往往伴随高延迟,压测报告必须同时给这两个数字,只看其一等于只看半张脸。
延迟还要看分布,而不是一个平均数。平均值最会骗人:十个请求里九个 5 毫秒、一个 2 秒,平均值算下来不过两百毫秒上下,看起来挺健康,但那个 2 秒已经足以让用户骂街。所以要看 P99、P999 这些分位数,看长尾——长尾才是用户真实感受到的东西。
并发是"同时有多少活跃请求",它考验的是锁、连接池和 CPU 调度,测的是系统在压力往上加时还能不能线性扩展。IO 维度在数据库里尤其要单独拎出来:随机读和顺序读的代价差着一个数量级,磁盘一旦成为瓶颈,CPU 再空也没用。资源消耗衡量"每完成一笔事务花了多少 CPU、内存、磁盘",是算账的维度——同样的吞吐,谁的成本低谁划算。持久性保证则是一个提醒:一个"飞快"的库,如果靠把数据留在内存里、不真正落盘来刷分,一次断电就全没了。
把这六个维度放在一起看,最典型的错判就现形了。比如一个库压测报出很高的 QPS,看起来很强,但如果它的 P99 延迟在负载上来后急剧拉长、磁盘队列又长期打满,那这个高吞吐是靠牺牲体验和透支磁盘换来的,一上真实业务就崩。反过来,一个吞吐数字不突出、但延迟平稳、资源消耗可控的库,反而更可能在生产里活得久。所以读任何一份压测报告,先问"除了这个漂亮数字,其他维度怎么样了",再下结论。这个习惯能替你避开绝大多数的误判。
二、标准负载与自定义压测:什么时候信谁
维度想清楚了,下一个问题是"用什么负载去压"。凭空造请求不行,得让负载尽可能像真实业务,同时又足够稳定、可复现。于是有了两类选择:标准基准,和自定义压测。
标准基准的价值在于规则公开、结果可审计。TPC-C 模拟的是订单处理这一类 OLTP 事务,它会规定数据规模、事务比例、响应时间约束,要求绝大多数事务在限定时间内提交,否则整轮成绩作废。YCSB 则抽象出读、写、更新、扫描四类原子操作,让你可以自定义访问分布,比如用热点键分布模拟"二八法则"。TPC-H 是分析型负载,用一批复杂查询去压连接、聚合、扫描这些分析能力。自定义压测则是把线上真实流量录下来回放,最贴近生产形态,但准备成本高、结果也不那么"通用"。
四者各有分工,选错了就等于拿错尺子量错对象。
| 基准 | 模拟的负载 | 主要测什么 | 适用场景 |
|---|---|---|---|
| TPC-C | 订单事务 | 高并发下的事务伸缩与一致性 | 关系型 OLTP 库 |
| YCSB | 读写更新扫描四类操作 | 存储引擎的基础操作延迟与吞吐 | KV 与各类存储引擎 |
| TPC-H | 复杂分析查询 | 连接、聚合、扫描等分析能力 | 数据仓库与 OLAP |
| 自定义压测 | 真实业务流量回放 | 贴近线上形态的端到端表现 | 上线前验证与容量评估 |
⚠️ 常见坑:拿 TPC-C 的 tpmC 数值直接横向比不同厂商的机器,却忽略硬件、配置、数据规模都不一致。标准基准的价值在"同规则下的可复现",不在"谁家数字更大"。
把"测"和"析"串起来,就得到下面这个闭环:测出慢,析出慢在哪,改完之后再回到同一把尺子下复测。
三、性能分析:把"慢了"拆到具体环节
基准告诉你"某处慢了",性能分析要回答"慢在锁、慢在 IO、还是慢在 CPU"。这一步靠的是采样:周期性抓取系统此刻正在干什么,把大量样本按函数、按环节汇总,看时间到底花在了哪。
火焰图是采样结果最常见的画法。它把调用栈竖着叠,宽度代表某个环节占用的时间比例。一片特别宽的"火焰",就是时间黑洞。这套东西的妙处在于,它逼着你先看"时间花在哪",再决定"改什么"。
采样本身有讲究:它是周期性地抓取系统此刻正在干什么,样本量要足够大,统计才有意义;同时采样间隔要远小于你想观察的现象,否则短尖峰会被漏掉。比如一个持续几毫秒的锁等待,如果采样间隔是十毫秒,很可能抓不到它。所以采样和火焰图适合看"持续性的慢",对偶发的一瞬间抖动,还得配合延迟分位数一起判断。
举个我们常碰到的例子:某条查询的延迟分布出现长尾,采样一看,大量时间耗在等锁,而不是执行计划本身。这时候优化方向就不是"再改索引",而是"拆长事务、减小锁粒度"。方向错了,索引加得再多,长尾照样在。反过来,如果采样显示时间几乎全在磁盘读上,那该查的就是缓冲池命中率、是冷热数据分布,而不是盯着 SQL 文本抠。同样是"慢",锁、IO、CPU 三种根源的处理手段完全不同,这就是为什么定位环节比急着调参重要。
💡 关键直觉:先看"时间花在哪",再决定"改什么"。没有采样数据就动手调优,和蒙着眼睛换轮胎差不多。
四、工程实践要点:避开两个最常见的坑
前面几节把方法讲完了,最后说两个最容易翻车的点。
第一个坑叫"平均值幻觉"。前面已经提过,这里再强调一次:任何优化决策都不该建立在平均值上。一个查询的平均延迟是 50 毫秒,但 P99 是 800 毫秒,说明有一小撮请求在经历痛苦,而这一小撮恰恰是投诉的全部来源。所以看数据先问分布,再问平均值。
第二个坑叫"局部最优"。把某个参数调大,某类查询确实变快了,却可能让另一类查询更慢、让内存更碎。比如把缓冲池调大能提升命中率,却会挤压操作系统的文件缓存,反过来拖慢日志写盘。真正的调优,是在吞吐、延迟、资源消耗这几个互相牵制的维度之间找平衡,而不是把某一个指标推到极限。
⚠️ 常见坑:用理想化的"全命中"负载去压测,跑出一个漂亮的数字,上线后却原形毕露。压测负载要尽量带上冷数据、长事务、并发竞争这些真实成分。
💡 关键直觉:调优前先立基线,调优后再回到同一把尺子下复测。没有前后对比的"优化",只能算"我改了点东西"。
常见疑问
Q:压测一次要跑多久才够?
没有一个固定时长,但有几条判断标准。一是等指标进入稳定区间——刚启动时会有预热、缓存未命中这些干扰,要等曲线走平再取数;二是覆盖足够多的事务和冷热数据,避免只测到最热的那部分;三是多次跑、取稳定值而不是单次峰值。总的原则是:你要的是"常态下的能力",不是"最顺那几秒的成绩"。
Q:TPC-C 的成绩能不能直接拿来选型?
不能直接拿来比,但可以参考。标准基准的价值在于规则公开、结果可审计,它适合在同规则下横向比较候选系统,或者纵向追踪一个系统迭代前后的变化。真正选型时,还要叠上你自己的真实负载、数据规模、硬件预算,用自定义压测做最终验证。把别人的 tpmC 当成自己的容量,是最容易犯的错。
本章回顾
- 吞吐与延迟是两回事:吞吐是单位时间完成量,延迟是单个请求耗时,中间隔着排队,要同时看
- 延迟要看分位数:P99、P999 才反映长尾,平均值会掩盖最糟糕的那一批请求
- 三个标准基准各有分工:TPC-C 测事务伸缩,YCSB 测存储引擎操作,TPC-H 测分析查询
- 基准的价值在可复现:同规则、同配置下可审计,而不是刷一个虚高的峰值数字
- 性能分析靠采样:火焰图的宽度就是时间占比,先看清时间花在哪,再决定改什么
- 瓶颈要定位到环节:锁竞争、磁盘 IO、CPU 计算的优化方向完全不同,定位错了越调越慢
- 避开两个坑:不看平均值、不追求局部最优,调优是多维权衡
- 调优要闭环:先立基线,改动后回同一尺度复测,用数字说话
量清现状只是第一步。知道了系统能扛多少、慢在哪,接下来要回答的是"怎么让它在长时间运行里稳住、出了事能兜住"——这正是下一节稳定性与运维要解决的问题。