4.5 端到端破案:USE 方法与排查决策树
4.5 端到端破案:USE 方法与排查决策树
端到端排查把第 4 章前四节的单类取证整合成一棵决策树:从"慢"这个模糊报案出发,按资源饱和度的顺序逐层排除,每一步都有明确的命令与结案条件。本节给出一套可以直接打印贴在工位上的操作规程。
为什么要有固定顺序
性能排查最大的效率损失是"跳步":报案说慢,直接扑向火焰图,采了半小时样发现 CPU 根本不高。顺序的价值在于先排除侦查成本低的方向——一套全局指标采集(十秒钟)能同时排除或锁定四类资源中的三类。
标准顺序:CPU → 内存 → 存储 → 网络。理由不是重要性,而是信号的获取成本与噪声水平:CPU 与内存的全局指标最干净(vmstat/mpstat/free 秒出),存储次之(iostat),网络最贵(重传率要求差值采样,归因要四元组)。
完整决策树
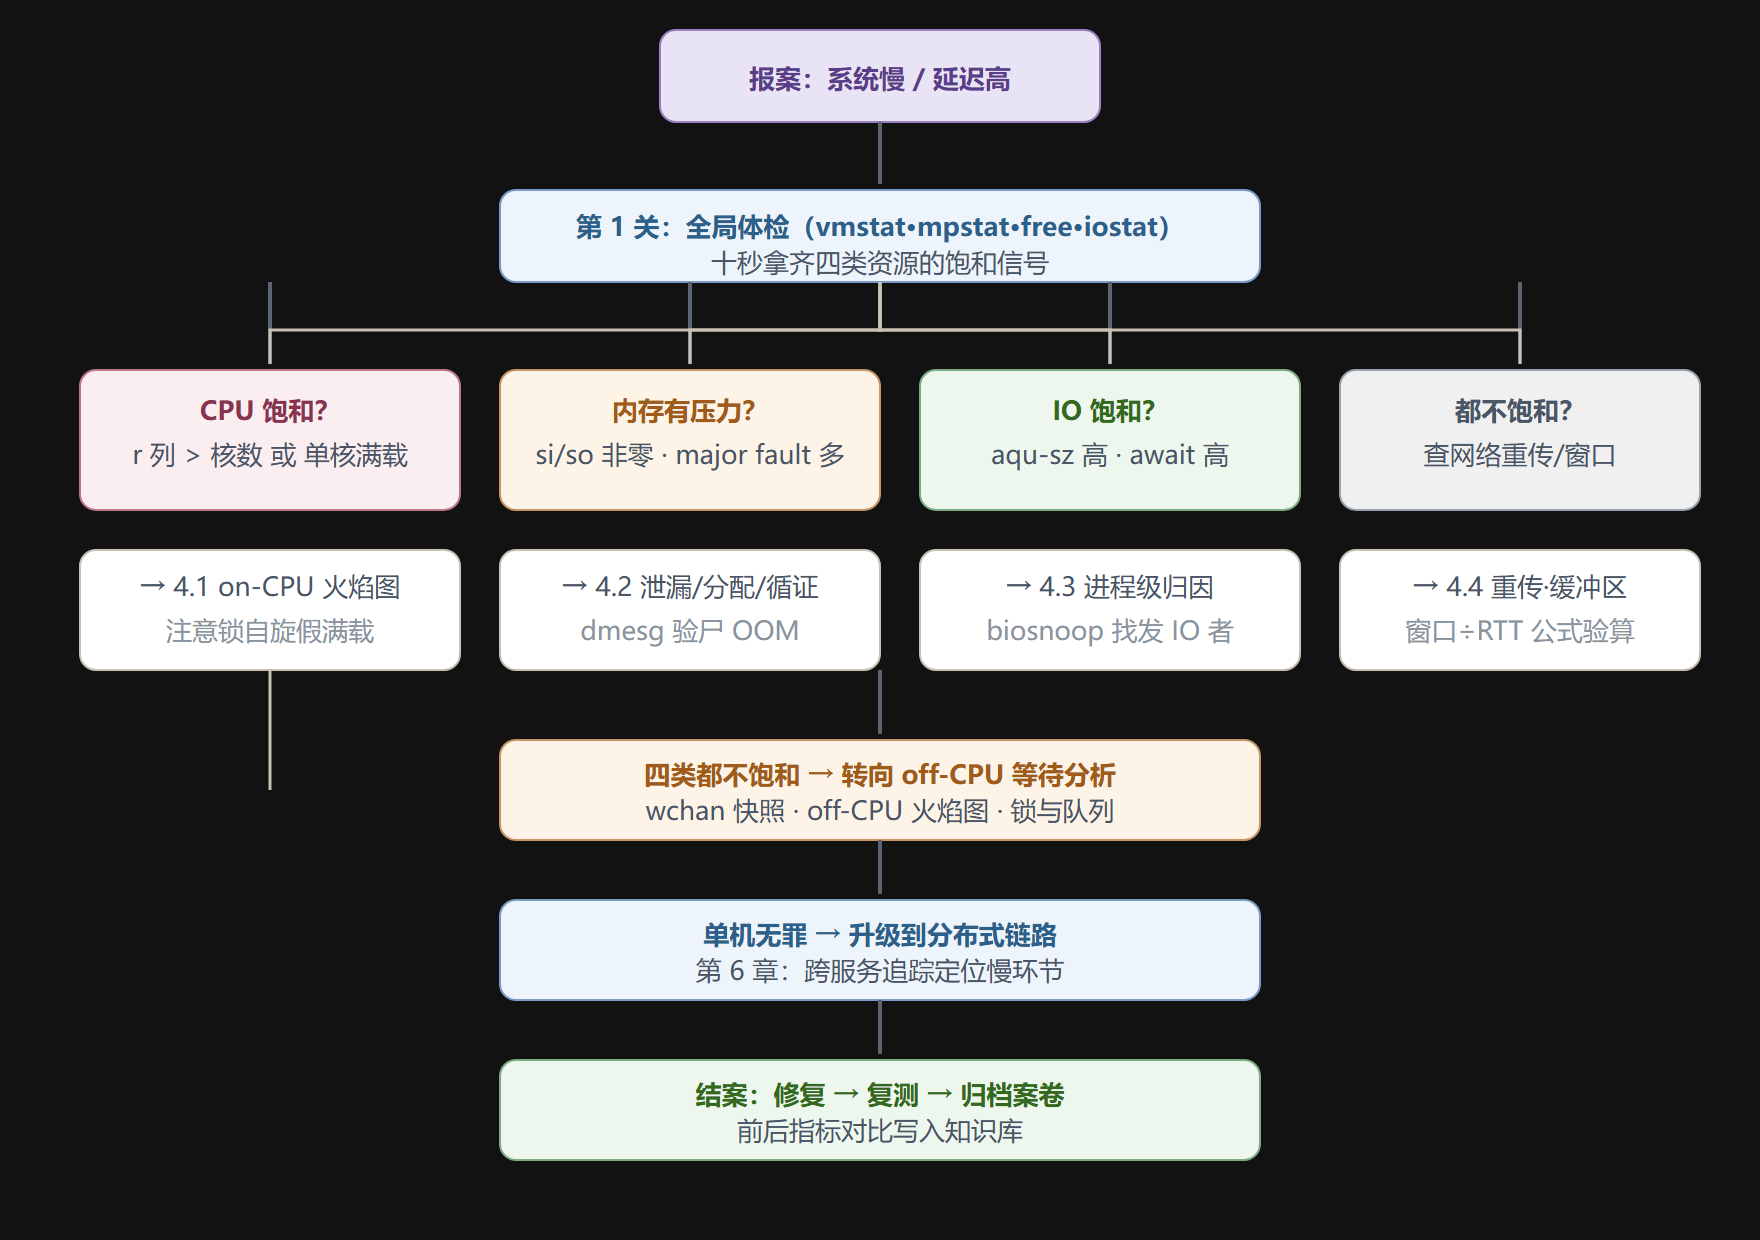
十秒体检的具体清单
第一关要拿齐的数据,两屏命令:
vmstat 1 5 # r(CPU 饱和)si/so(内存换页)wa(IO 等待) mpstat -P ALL 1 3 # 各核分布与 iowait free -m # available iostat -x 1 3 # aqu-sz / await / %util ss -s # 连接概览
六条命令的输出交叉判读,四类资源的状态一屏定案。这就是决策树第 1 关的全部成本。
USE 检查表:每类资源的三连问
把第 1.2 节的 USE 方法落成表格,排查时逐行打勾:
| 资源 | Utilization | Saturation | Errors |
|---|---|---|---|
| CPU | mpstat 使用率 | vmstat r 列、调度延迟 | dmesg MCE |
| 内存 | free available | si/so、缺页率 | ECC、OOM 记录 |
| 存储 | iostat %util | aqu-sz 队列深度 | dmesg IO 错误 |
| 网络 | 带宽占用 | 重传率、缓冲区堆积 | 丢包、溢出计数 |
三连问的纪律价值在于完整性:人很容易停在第一个异常上(发现 CPU 高就结案),USE 逼你把每类资源的三格都填完——很多疑难杂案是两个问题叠加的,只修一个会陷入"为什么还没好"的循环。
结案标准
一案不算破,直到三件事完成:
- 因果闭环:能写出"因为 X,所以指标 Y 异常,所以用户看到 Z"的完整句子,且每步有证据;
- 修复复测:同一负载下复测,Z 消失且 Y 回到基线;
- 案卷归档:症状、证据、根因、修复、复测数据入库,成为下次的第 1 关参照。
💡 关键直觉:排查卡住时的第一反应不该是"换个工具试试",而是"退回上一关,检查有没有漏掉的格子"。多数卡死是因为提前跳关。
本节要点回顾
- 顺序按侦查成本排:全局体检十秒排除三类,别一上来就扎火焰图;
- 四类都不饱和就转 off-CPU:时间在等待里,不在计算里;
- 单机无罪再升级分布式链路,层级清晰不空转;
- USE 三连问逼你填满表格,防止单因结案漏掉叠加问题;
- 结案要因果闭环 + 复测 + 归档,缺一项就是悬案。
至此性能"慢"的案子有了完整规程。下一章转向另一类案件:程序"错"——崩溃、死锁、内存越界。
延伸:把 USE 方法落成一页检查单
USE 方法(利用率、饱和度、错误)对每类资源各问三句,落成固定检查单后,值班同学的排查从"凭感觉"变成"扫清单":
# USE 一页单:cpu / 内存 / 存储 / 网络 / 文件描述符 uptime # CPU 利用+饱和(load vs 核数) vmstat 1 5 # r(饱和) wa(IO等待) free -m; cat /sys/fs/cgroup/.../memory.events # 内存压力与 oom 计数 iostat -x 1 5 # aqu-sz(饱和) await(延迟) nstat -az | egrep 'Drop|Overflow|Retrans' # 网络错误计数 ss -s; cat /proc/sys/fs/file-nr # fd 用量与上限 sar -n SOCK 1 3 # 连接数趋势
清单里每行都对应"资源×问题"的一个格子,扫完一轮,嫌疑范围自然收窄到一两个资源,再进入对应章节的专项取证。
延伸:决策树的两条主干
所有延迟案件最终落到两问:一是"时间花在 CPU 上了还是花在等待上了"——pidstat 的 %wait 与火焰图形态直接分案;二是"等待的对面是谁"——锁、磁盘、下游服务三选一,分别用 futex 计数、iowait/队列深度、连接池与 RTT 对应验证。把这两问画成值班室的决策树海报,每片叶子写上验证命令,新人也能沿树走到正确终点;而树的每一次走错,都意味着某个格子的检查单需要补充新证据形态——决策树本身就是团队经验的对账单。
决策树的维护本身也要讲证据。每次事故复盘后问两个问题:这棵树有没有带我们走到正确叶子?如果中途走错,是缺一格检查项,还是某格的证据形态误导了判断?把答案写回树里——新增格子、修订命令、标注已知误报形态。半年回顾一次会发现,树的形状逐渐从教科书式的对称二叉,长成贴着自己系统特征的不对称形态:数据库重的系统在存储分支越来越深,微服务架构在等待分支长出链路子树。这棵越长越歪的树,就是团队排查能力最诚实的自画像,也是新成员最好的教材——每一片畸形的叶子背后都是一起真实的案子。
USE 方法的第三问"错误"在实践中最容易被跳过,恰恰它定罪最快:错误类计数器一旦非零就是铁证——ECC 不可纠正错误、NVMe 介质错误、网卡 CRC 错误、文件系统只读降级,这些都不需要任何推断。养成先扫错误再算利用率的手顺,能把一类"疑难杂症"(偶发超时、随机慢查询)直接短路成硬件报修单。检查单里为每类资源固定一条错误扫描命令,正是让这个手顺可持续的方式。
把 USE 与 RED 两个框架的分工说清楚也很有必要:RED(速率、错误、延迟)面向服务与请求,回答"用户体验是否受损、哪个接口受损";USE 面向资源,回答"哪类资源出了问题"。端到端排查的实际顺序是先用 RED 在服务层确认受损面并锁定嫌疑服务,再进该服务用 USE 扫资源定位瓶颈层,两个框架接力而非互相替代。许多团队的监控只有 RED 没有 USE,于是永远知道"哪个接口慢",却永远答不出"为什么慢",每次都靠个人经验临场补单机检查——这正是决策树要填补的断层。