5.1 GDB:断点、回溯与核心转储
5.1 GDB:断点、回溯与核心转储
GDB(GNU Debugger)通过 ptrace 机制控制目标进程,提供断点、单步、变量查看与回溯能力。它是逻辑错误的审讯室:程序"错得稳定"时,GDB 逐层逼问是最直接的破案路径。本节覆盖调试原理、日常命令与生产环境的正确姿势。
调试器是怎么"停住"一个程序的
断点的实现朴素得惊人:把目标地址的指令临时替换成一条陷阱指令(x86 上是 int3),进程执行到这里就陷进内核,GDB 被 ptrace 唤醒,接管现场。所以:
- 断点只在指令经过时触发——没被执行到的代码路径拦不住;
- 单步是"改下一条指令 + 陷阱"的循环,极慢;
- 每次停下/恢复都是 ptrace 往返,这就是第 1 章说"断点扰动暂停级"的机制来源。
理解这一点,就理解了 GDB 的适用边界:逻辑稳定的缺陷(玻尔 Bug)用它,时序敏感的缺陷(海森 Bug)避开它。
标准审讯流程
一个崩溃案件的完整动作:
# 带符号编译(没有调试符号,GDB 只能看到地址) # 构建时加 -g 且不 strip gdb ./myapp
# 1. 设断点:函数入口、文件行号、条件 (gdb) break parse_config (gdb) break main.c:142 (gdb) break process_order if order.amount > 10000 # 2. 运行与查看 (gdb) run --config prod.conf (gdb) bt # 回溯:崩溃点向上的调用链 (gdb) bt full # 带每层局部变量 (gdb) frame 2 # 跳到第 2 层栈帧 (gdb) print order (gdb) print *order->items@10 # 3. 改变执行(审讯中的反问) (gdb) set var order->amount = 5 (gdb) continue
回溯是崩溃案的第一证据。一份典型输出:
#0 0x0000557... in strlen () from libc #1 0x0000557... in validate_name (name=0x0) at validator.c:88 #2 0x0000557... in process_order (order=0x5581f2c0) at orders.c:212
第 1 帧已经把案情说清:validate_name 收到空指针还传给了 strlen。88 行加个空判断就能修,但真正的调试是问为什么它收到了 NULL——往上看第 2 帧,谁构造的 order、哪条路径漏了初始化。修崩溃点治标,修数据流治本。
attach 到运行中的进程
gdb -p <pid>
attach 时进程会被暂停(ptrace 接管),detach 后恢复。注意事项:
- 容器环境可能禁止 ptrace(第 6 章的盲区之一),需要调整权限位;
- attach 生产进程相当于冻结服务的一个线程池,多线程服务慎用,先摘流量;
- gdbserver 方式适合嵌入式与远程目标,本机同款命令。
多线程调试的开关
(gdb) info threads # 所有线程与当前位置 (gdb) thread 5 # 切到 5 号线程 (gdb) thread apply all bt # 全员回溯:死锁案的关键命令
thread apply all bt 值得单独敬礼:死锁、卡死类案件,一份全员回溯能同时看到所有线程各自卡在哪,两个线程互持对方需要的锁的现场一目了然(第 5.2 节展开)。
GDB 审讯流程速查
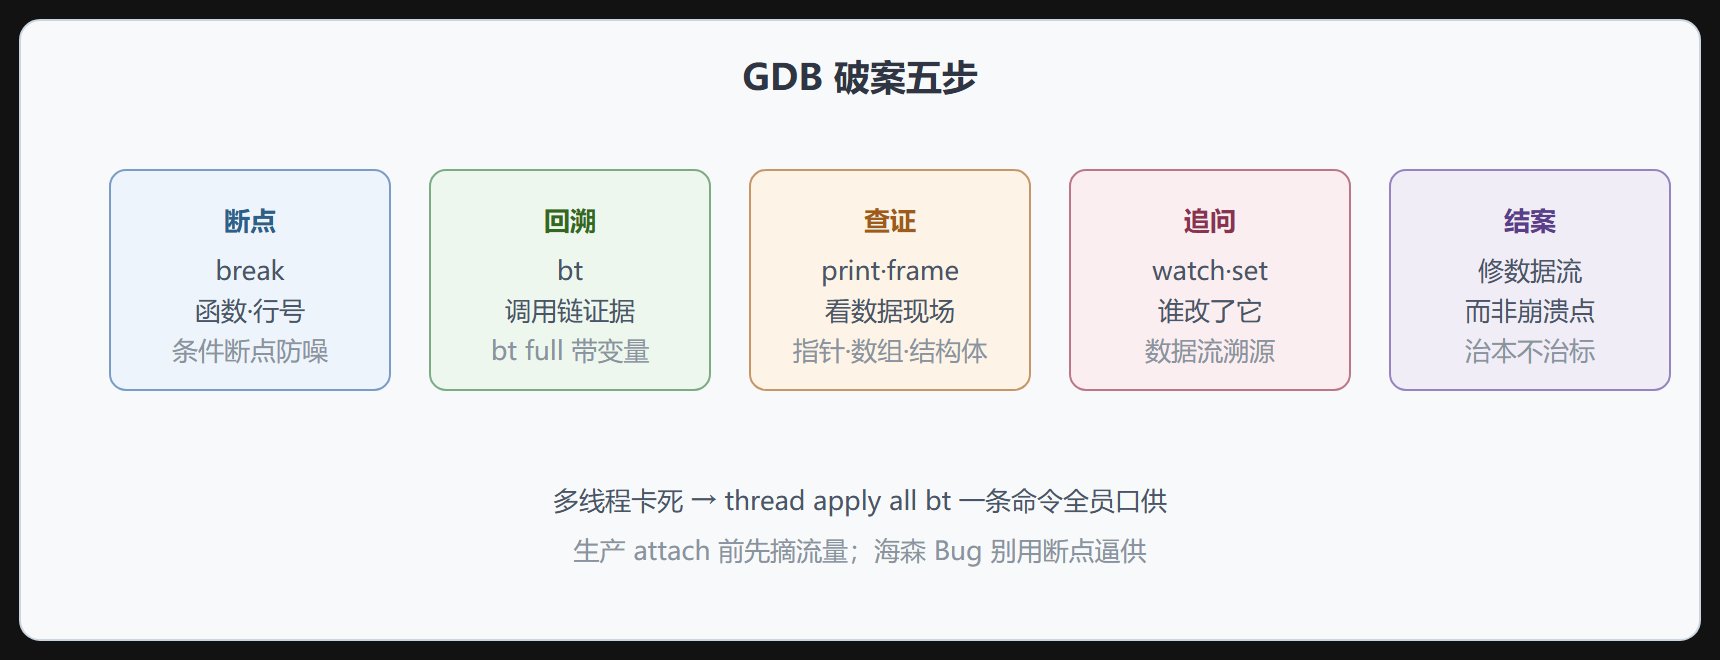
常用进阶:watchpoint
watch 监视内存位置,谁改它就停谁——查"数据莫名其妙变了"的杀手锏:
(gdb) watch config->timeout Hardware watchpoint 2: config->timeout Old value = 30 New value = 0 ← 抓到肇事线程与栈
硬件 watchpoint 数量有限(通常 4 个),软件 watchpoint 极慢,控制监视点数量。
本节要点回顾
- 断点 = 指令替换成陷阱,只在执行路径上生效,因此海森 Bug 不吃这套;
- 回溯是第一证据,但修复要追到数据流源头,崩溃点打补丁治标不治本;
- 条件断点过滤高频调用,
break ... if是避免断点风暴的第一手段; thread apply all bt是卡死类案件的口供总录;- watchpoint 溯源数据篡改,硬件监视点快但配额有限。
延伸:生产环境优先用非侵入命令
GDB attach 会全停进程,生产服务上单线程断点等于一次 mini 事故。非侵入三件套先走:gcore 只抓快照不停顿(百 MB 级堆约几秒)、thread apply all bt 10 拿全线程浅栈、断点改用条件与忽略计数压低命中频率。可接受的最短路径:
gcore -o /var/case/core $PID # 快照后立即可继续用 dmesg 之外工具 gdb -p $PID -batch -ex 'thread apply all bt 12' > all_bt.txt # 秒级, 仍会暂停 gdb /path/app /var/case/core.$PID -batch \ -ex 'info threads' -ex 'thread apply all bt 15'
延伸:反向调试与记录回放
rr 这类记录回放调试器先录一遍执行,之后可任意单步倒退,对"只在第十万次迭代出问题"类 Bug 是降维工具:
rr record ./app --replay-failing-case rr replay (rr) break malloc_fail_hook (rr) continue (rr) reverse-continue # 从崩溃点倒回根因现场
限制是单核录制、约 1.2–2 倍减速,适合测试环境复现而非生产。把崩溃自动转成 rr 录像进 CI,是让"偶现"Bug 变成"必现"录像带的工程做法。
延伸:一次典型 core 分析的命令序列
拿到 core 先核对执行文件与库的 build-id,再定位崩溃帧,最后查现场对象,三步各有标准命令:bt full 看带局部变量的完整回溯、frame N 切到出事帧、info registers 与 x/16i $pc-32 还原最后指令。签名不符的 core(常见于版本混布)先对 build-id,否则后面全是幻觉证据。
set pagination off bt full frame 7 info locals p *req_ x/16i $pc-32