1.1 存储与计算为什么分了家:一条总线的能耗账
1.1 存储与计算为什么分了家:一条总线的能耗账
本节摘要:存算分离不是设计失误,而是 1945 年技术条件下的最优解。但深度学习把它的隐性成本变成了显性账单:搬一个 32 位数约 640 皮焦耳,算一次加法约 1 皮焦耳,640 倍的落差让"搬运"而非"运算"支配了智能计算的能耗。本节算清这笔账,并解释存算一体的思路为什么是对症的。
上一章把问题链立起来之后,本节负责确诊:冯诺依曼瓶颈到底是物理定律还是工程选择。我们会先回到 1945 年的设计现场,看存算分离当年为什么合理;再用一笔两级存储层次的能耗账,算出深度学习时代这堵墙有多高;最后引出"把运算搬进存储"的对症思路,为第 5 章的芯片实现埋下伏笔。
分家的由来:1945 年的合理决策
冯诺依曼架构把存储器和运算器分开,原因很朴素:当年的存储介质(水银延迟线、阴极射线管)和逻辑器件(真空管)是两种完全不同的技术,物理上就长不到一起,分开做各自优化是唯一选择。存储器要密度,运算器要速度,两者在一条总线上交换指令和数据。这个设计如此成功,以至于八十年后的芯片仍然保留着它的骨架:DRAM 在片外,SRAM 在片上,CPU 核心在中间,数据沿"寄存器—缓存—内存"的层级来回搬运。
问题在于,分家之后两块大陆的发展速度严重失衡。过去几十年,运算器的吞吐按摩尔定律翻番,而 DRAM 的访问延迟每年只改善不到百分之十,带宽增长也远远落后于算力增长。这条越来越窄的总线,工程师给它起了个名字叫"内存墙"。对数据库、网页服务这类传统负载,缓存 hierarchy 还能兜住;但深度学习把问题彻底掀开了——一个数十亿参数的模型,权重根本装不进片上缓存,每个乘加都要去片外取数。
一笔账:搬比算贵两个数量级
我们用业界常用的量级估算把账算实。以 45 纳米工艺的经典测算为参照:32 位浮点乘加大约 1 至 4 皮焦耳;8 位整数乘加不到 1 皮焦耳;而读一次 32 位 DRAM 大约 640 皮焦耳,读一次片外 LPDDR 还要叠加传输功耗。即使按乐观口径,片外访存也比运算贵一百倍以上。层级的规律是:离运算单元越远,每比特代价越高,片上 SRAM 约是 DRAM 的十分之一,寄存器又比 SRAM 便宜一个量级。
# 一笔能耗账:一次卷积层的"算"与"搬" # 设一个 3x3 卷积核,输入通道 256,输出通道 256,权重量 3*3*256*256 weights = 3 * 3 * 256 * 256 # 589,824 个权重 mac_ops = weights # 每个权重对应一次乘加(按单输出像素计) # 能耗单价(皮焦耳,45nm 量级参考值) E_mac = 3.0 # 32bit 乘加 E_dram_32b = 640.0 # 从 DRAM 读一个 32 位数 # 场景 A:权重全部放片上 SRAM(理想,SRAM 读约 5 pJ/32bit) e_A = mac_ops * (E_mac + 5.0) # 场景 B:权重放 DRAM,每个乘加都要访存(无缓存利用的最坏情况) e_B = mac_ops * (E_mac + E_dram_32b) print(f"权重个数: {weights}") print(f"片上算+SRAM读: {e_A/1e6:.1f} pJ = {e_A/1e12:.3f} J") print(f"片上算+DRAM读: {e_B/1e6:.1f} pJ = {e_B/1e12:.3f} J") print(f"差距倍数: {e_B/e_A:.0f}x") # 输出:差距约 52 倍——同一份计算,只因为数据放的位置不同,能耗差五十倍以上
跑一遍这段代码你会看到:同样的乘加次数,数据位置不同,能耗差五十倍以上。而真实训练中模型权重大到 SRAM 装不下,DRAM 访问不可避免,于是整个系统的功耗曲线形状由访存决定,不由运算决定。这也解释了一个反直觉现象:GPU 上把 batch 调大,单位样本能耗反而下降——不是运算变便宜了,是权重搬运的固定成本被更多样本摊薄了。
图:冯诺依曼架构与存算一体架构的对照——能量花在哪里
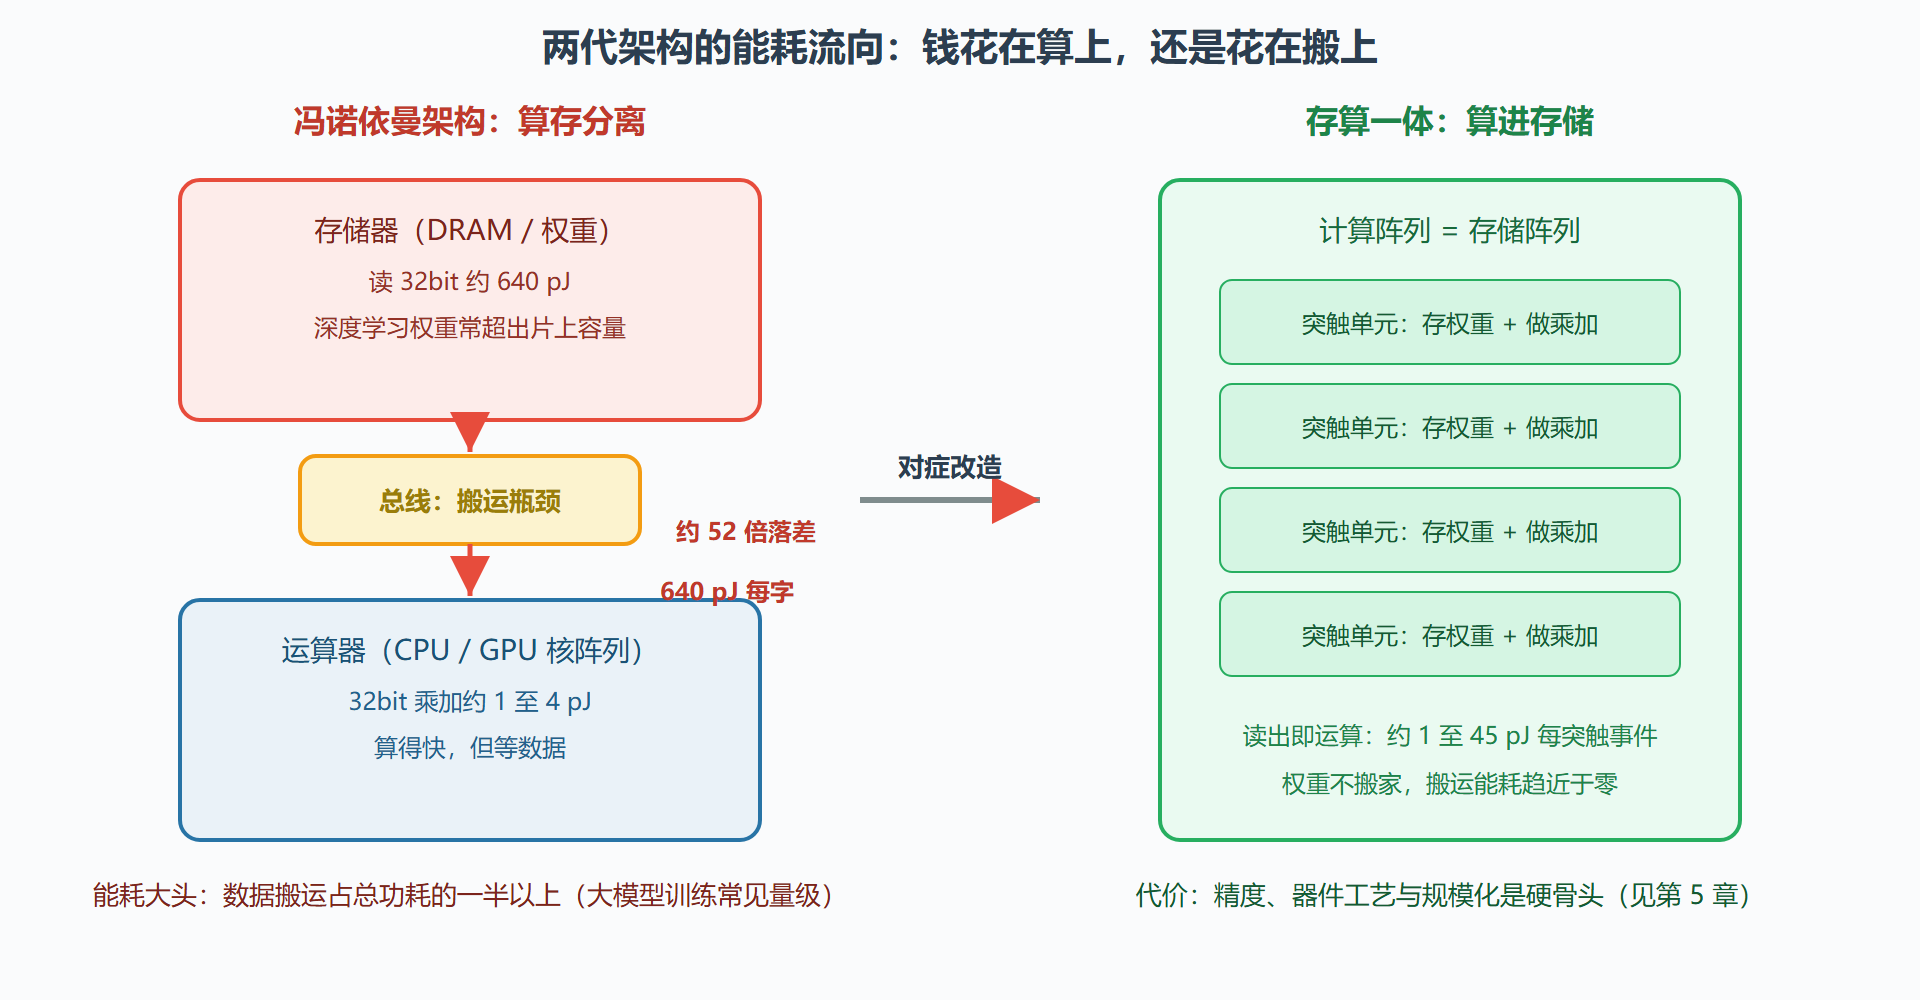
图里左右两侧的能耗单价对照,就是本节最想让你记住的东西:左边架构的能量大头永远流向中央那条总线,右边架构把"读权重"这个动作本身变成了"做乘加"。第 5 章会看到,TrueNorth 的突触事件约 26 皮焦耳、Hala Point 的突触运算约 8 皮焦耳,数字正好落在这个"算存不分家"的区间。
工程视角:墙的三种现状与对策
第一,缓存能救传统负载,救不了大模型。缓存有效的前提是数据被反复使用(局部性),而推理时每个权重用一次就走,局部性天然差;训练时反向传播虽然重访权重,但批量并行又会把激活值撑爆缓存。第二,数据量化、剪枝这些压缩手段,本质是"少搬一点":把 32 位压到 8 位,搬运量降四倍,这也是它们长期霸榜端侧优化的原因——但压缩有精度下限,墙只是变矮,没有消失。第三,近年火热的近存计算(把运算逻辑堆在存储颗粒旁边)是折中方案:搬运距离缩短,带宽翻几倍,但分家格局没变。
神经形态计算的立场更彻底:既然生物神经系统证明"算就是存"可行,就把权重的物理位置和乘加的物理位置焊死在一起,再加上事件驱动让没有任务的单元彻底静默。这两步合起来,才是绕墙而不是垫墙。需要提醒的是,存算一体的器件路径(SRAM 阵列、忆阻器交叉阵列、相变存储)各有精度与工艺代价,具体取舍放在第 5 章展开;本节你只需要带走结论——墙的砖是"搬运",拆砖的方式是"不搬"。
两个高频疑问值得正面回答。疑问一:缓存堆大一点不就解决了吗?答案是局部性不配合就没用——推理任务里每个权重只用一次,命中率上不去,缓存容量翻倍带来的收益接近于零;训练任务的激活值又太大,装不下。缓存是"重复使用"的解法,不是"搬运本身"的解法。疑问二:近存计算(Processing-in-Memory,把简单运算逻辑堆在内存颗粒内部或旁边)和存算一体是不是一回事?不是,两者的激进程度差一档:近存计算缩短搬运距离但仍是"存储归存储、运算归运算",适合当过渡方案;存算一体让存储介质本身参与运算(本节末尾的忆阻器路线是它的极限形态),这才是把 640 对 1 的落差从结构上抹掉的做法。三星的近存内存产品、各类 CXL 内存池化方案属于前者;第 5 章的交叉阵列属于后者。
还有一层工程现实要交代:访存的能耗账不只是"读一个数"的电荷成本,还包括地址译码、行列激活、总线上信号驱动的全套开销——这就是为什么同一次读,命中缓存与穿透到 DRAM 的实际功耗差两个量级。做能耗估算时,用"每字节搬运成本随层级位置指数增长"的心智模型,比记单个数字更可靠:寄存器最便宜,每往外一层大约贵 3 到 10 倍,到 DRAM 就是三个数量级的差距。
一句话总结:冯诺依曼瓶颈不是 CPU 不够快,而是数据在错误的地方。深度学习把这点放大成了能耗账单,而把乘加搬进存储阵列,是神经形态计算的第一性对策。