3.2 突触与可塑性:权重为什么是状态不是常数
3.2 突触与可塑性:权重为什么是状态不是常数
本节摘要:生物突触不是一个存了权重就完事的存储单元,它同时是增益调节器、历史记录器和稳态控制器:短期可塑性在毫秒到秒尺度做临时增益,长期可塑性按脉冲时序永久改写强度(STDP 的生物原型),homeostasis 再把整体工作点拉回稳定区间。三层状态对应三种硬件存储形态,这是读懂一切片上学习架构的钥匙。
上一节把"发脉冲的单元"选好了,本节处理单元之间的接口。把突触当常数权重是深度学习带来的思维惯性——训练完权重冻结,推理时只读不写。生物突触不这样工作:它每天都在变,而且在不同时间尺度上按不同规则变。理解这三层"变",是理解第 4 章学习规则和第 5 章片上学习引擎的前置。
第一层:短期可塑性——秒级内的增益调节
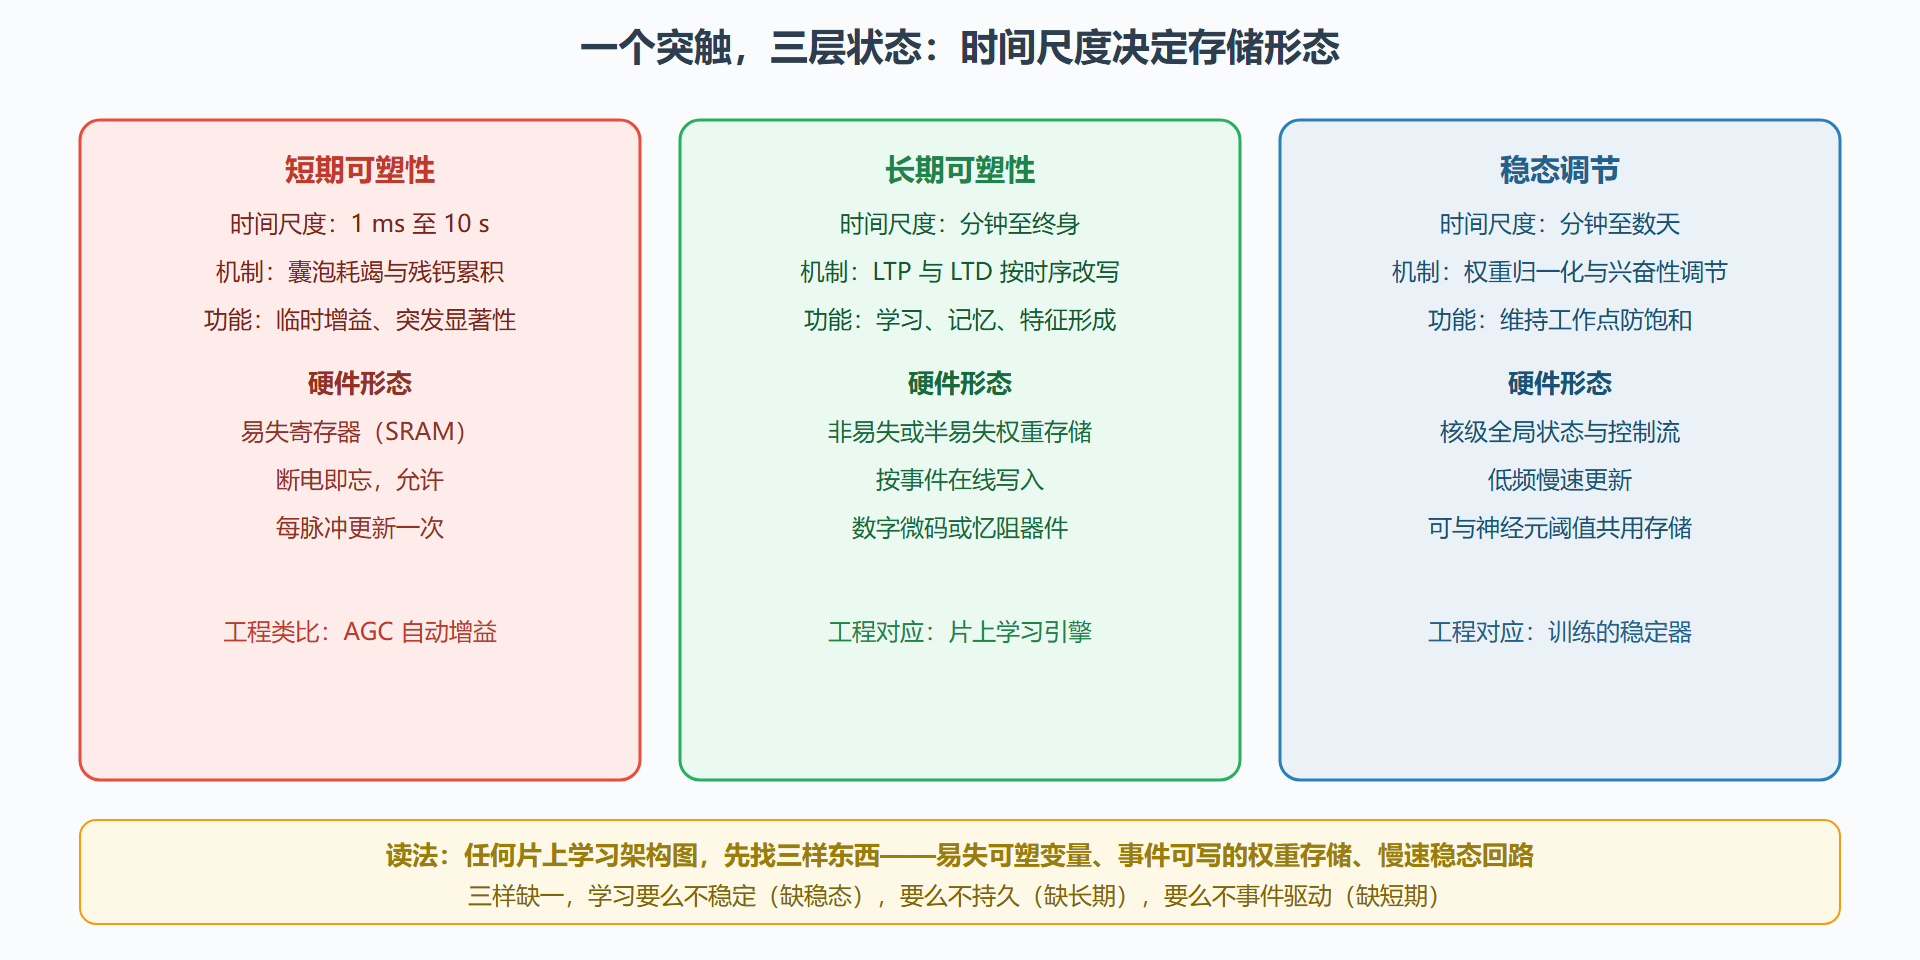
两个脉冲间隔很短时,突触传递会衰减(抑郁,depression,因为神经递质囊泡来不及补充);脉冲列持续到来时,传递也可能增强(易化,facilitation,残钙累积让释放概率上升)。Tsodyks-Markram 模型用两三个状态变量就把这对机制描述清楚,时间尺度在几毫秒到几秒。
工程上看,短期可塑性是一个免费的自适应滤波器:输入越密,单次传递越弱,天然防止下游被高频输入淹没;突发信号的对比被自动增强。听觉通路用这个机制做突发的显著性检测,触觉通路用它忽略持续压力、只对变化敏感。硬件实现上它只需要在突触状态里多存一两个易失变量——SRAM 就够了,不需要动非易失权重。
第二层:长期可塑性——权重被时序改写
真正让突触成为"学习器件"的是长时程增强(LTP)与长时程抑制(LTD):突触前脉冲与突触后发放的相对时序,决定强度被永久上调还是下调。1973 年 Bliss 与 Lømo 在海马体首次记录到"高频刺激后突触强度提升可持续数小时以上";1998 年 Bi 与 Poo 在培养神经元上给出了完整的时序曲线——前脉冲早于后发放约 20 毫秒内增强,晚于则抑制,幅度随时序差指数衰减。这就是 STDP 的实验基础,第 4 章会把它写成更新公式并做仿真,本节你只需要记住因果结构:"我发放前你刚来过"意味着你参与了 Causes 我,加强你;"我发放了你才来"意味着你来晚了,削弱你。
硬件翻译一下:这条规则要求权重"在线可写、按事件写"。这打破了"存储器只能读写分离"的常规——写入由随机到达的脉冲触发,幅度小、频次不定。这直接催生了第 5 章的两类方案:数字芯片给每个突触配学习微码(Loihi 路线),器件物理让"写"变成材料属性(忆阻器路线:电导随流经电荷历史改变,写即通)。两层路线在 5.3 会正面相遇。
第三层:稳态与.homeostasis——不被学习带跑的工作点
可塑性有个隐患:所有突触都按 LTP 加强,网络会饱和失控。生物的解法是 homeostasis(稳态调节):突触尺度上有权重归一化(总量守恒的竞争学习),神经元尺度上有内在兴奋性的慢速调节(膜兴奋性按近期平均发放率反向调整),时间尺度从分钟到天。这个"慢负反馈"保证了快可塑性始终工作在有效区间。
工程对应物同样具体:Diehl 与 Cook 2015 年那篇著名的 STDP 训练 MNIST 工作(无监督,准确率约 95%)里,真正的稳定器不是 STDP 本身,而是权重归一化和自适应阈值的组合——没有 homeostasis,网络几百个样本后就会所有神经元一起发放、特征全部糊掉。第 4 章复现这条路线时会再次碰到这个坑。
图:突触的三层状态与对应硬件形态
把三层状态装回系统视角
现在把 3.1 和 3.2 拼起来看一个完整通路:事件相机脉冲进来(第 6 章),穿过带短期可塑性的突触自动做显著性筛选,进入 Izhikevich 神经元产生适应性发放模式,输出脉冲经 STDP 式突触改写下游连接,homeostasis 在背后维持整个网络的工作点。这套流水线的每个环节都有明确的硬件对应物,第 5 章的芯片拆解会一一现身。反过来,当你在某篇论文里看到"片上学习"四个字,先问:三层状态各放在哪?答案清楚了,架构才算真懂了。
⚠️ 一个常见的实现坑值得提前预警:把三层状态都塞进非易失存储是最昂贵的方案。合理的分配是——短期状态用易失寄存器(变化快、可丢失),长期权重用非易失或半易失单元(更新慢、需保持),稳态控制用核级共享寄存器(一核一份足矣)。分层错位是很多片上学习原型功耗超标的主因。
把三层状态放进一个具体场景里走一遍,你能看到它们如何协同。设想一个常开的声学哨兵(第 6 章硅耳的事件流进来):短期可塑性在鸡尾酒会式的持续噪声里自动压低稳态背景的传递,只让突发声响突显出来——这是第一层在工作;一个玻璃碎裂的模式触发了特征神经元的发放链,STDP 把"这个频谱时序模式通向报警输出"的连接加强——这是第二层在记;当晚些时候整个网络因环境变化发放率整体漂高,homeostasis 在几分钟尺度把各神经元的阈值慢慢抬回去,防止"草木皆兵"——这是第三层在兜底。三层各司其职、时间尺度互不干扰,这就是生物方案给"持续学习不崩"的完整答案,也是第 8 章冷启动时评估任何"在线学习产品"的检查表。
硬件成本上再补一笔账,让"三层状态"从概念落到面积:短期可塑性每突触约需两个 8 位易失计数器(裕度与残钙的等效物);长期权重是主角,4 到 8 位非易失或半易失存储;稳态控制是核级共享的几个累加器,均摊后几乎免费。以 Loihi 一代的实现为参照,它给每个突触配了一个学习状态位加可编程更新逻辑,整颗芯片的学习电路开销控制在两位数百分比——证明三层状态里"按事件写的长期权重"才是真正的成本大头,前两层可以用共享和近似换便宜。
评估一个片上学习方案时,"三层状态各放哪"可以变成一组具体的问答题。第一问:写入带宽够吗——每个脉冲都可能触发权重写,存储介质的写入次数上限(耐久性)与写入延迟扛得住你的事件率吗?SRAM 扛得住但易失,忆阻器省电但有次数上限,答案决定了你的学习网络能活多久。第二问:状态丢失的代价是什么——断电后短期可塑性状态消失无所谓(它本来就是秒级记忆),长期权重丢失则是灾难,所以存储分层必须与记忆时尺度对齐。第三问:学习速率谁来管——三层状态各自的学习速率(更新步长)是固定参数还是可调状态?生物的答案是后者(神经调质会动态改可塑性阈值),工程上至少要给核级留一个可编程的速率寄存器,否则环境变化时学习要么过冲要么迟钝。三问答完,一个片上学习架构的骨架就审完了,这比看任何宣传页都快。
突触的深意在于:存储、计算、学习是同一个物理过程的三种读法。权重被读是推理,被时序改写是学习,被归一化是稳定——一个器件,三重身份。
下一节把镜头拉远:亿级突触怎么组织成网络,生物的连接结构又给芯片布线立了什么规矩。