5.3 存算一体与忆阻器:把乘加搬进存储阵列
5.3 存算一体与忆阻器:把乘加搬进存储阵列
本节摘要:1.1 节诊断的搬运病,最激进的处方是把存储器件本身变成运算器:忆阻器交叉阵列里,权重以电导形式存储,欧姆定律做乘法、基尔霍夫电流定律做加法,一次矩阵-向量乘在一步物理过程中完成。本节讲清这条路线的原理、演示规模与三道精度关卡。
前两节的芯片方案里,存储和计算仍是邻居而非一体。本节的器件路线更彻底:让"读权重"这个动作在物理上就等于"做乘加"。这条路线是存算一体在神经形态领域的主干道,也是近十年 IEDM、ISSCC 上最活跃的方向之一。
原理:两条物理定律就是一台矩阵乘法器
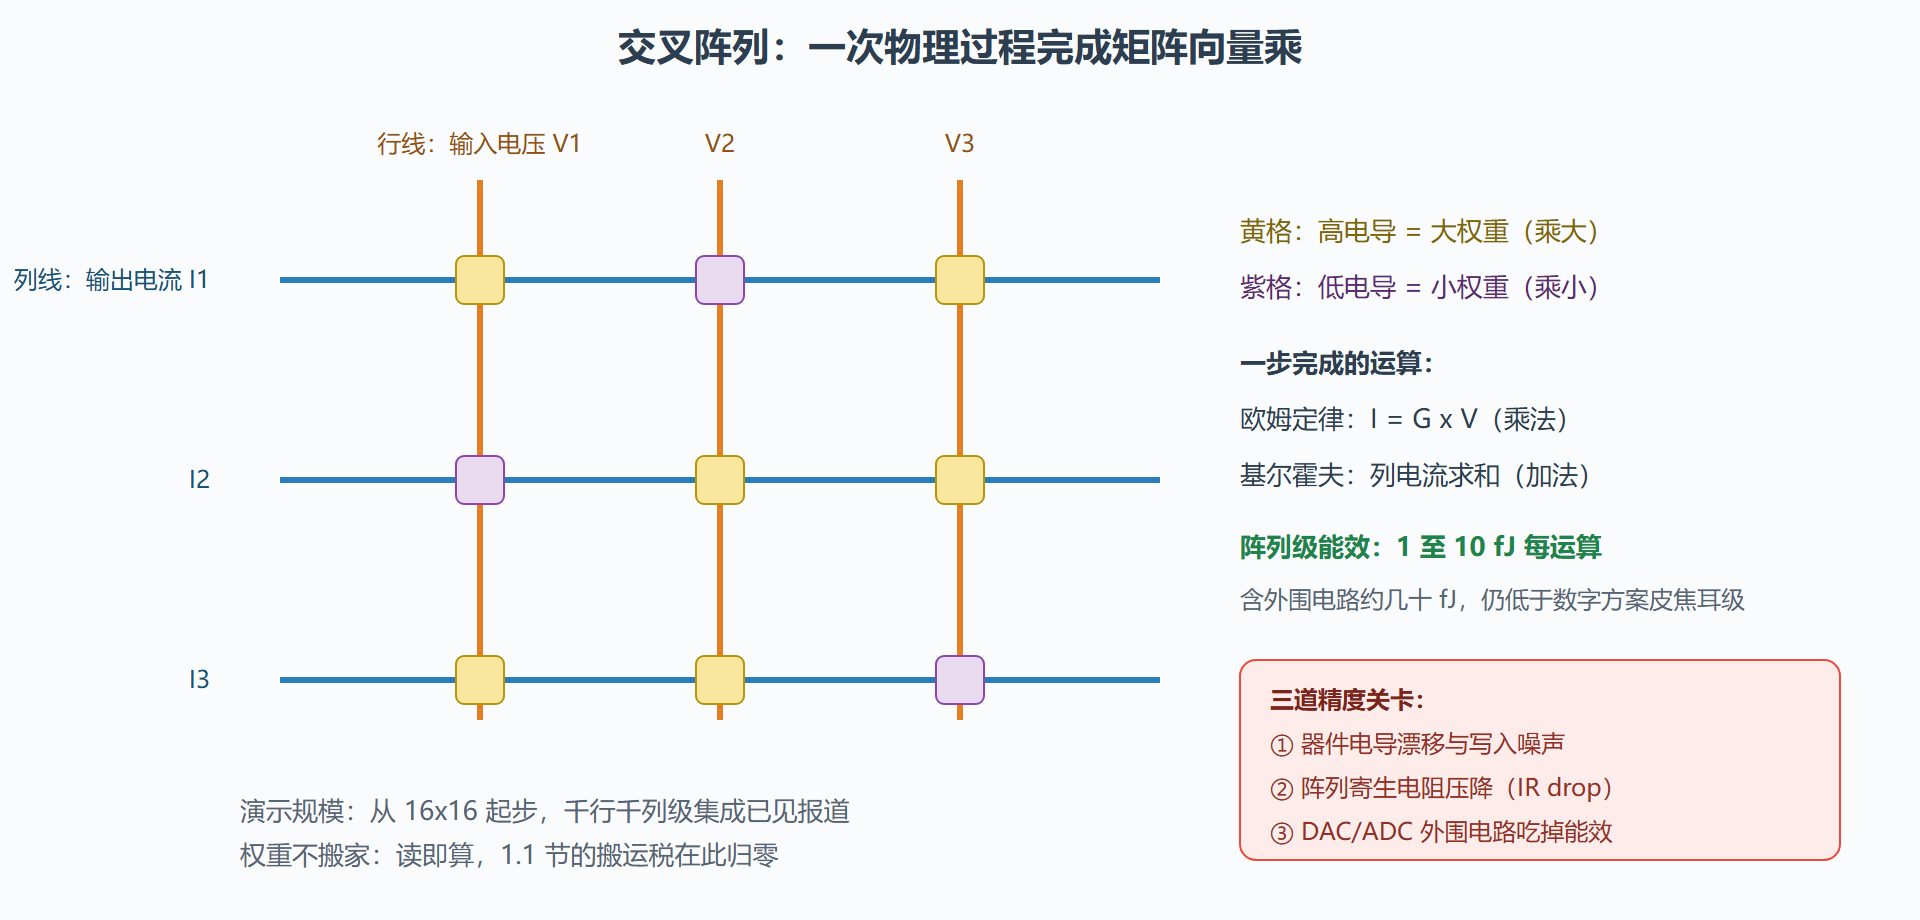
忆阻器(memristor)是一个电阻值可被历史电流改变、且断电保持的两端器件。把忆阻器放在行列交叉点上构成阵列,权重 w_{ij} 写成电导 G_{ij};行线上施加输入电压 V_j(脉冲世界里的输入脉冲可直译为电压幅度或宽度),列线上流出的电流按欧姆定律 I_{ij} = G_{ij} \times V_j 完成乘法,同一列上所有器件的电流按基尔霍夫定律自然相加 I_i = \sum_j G_{ij} V_j。一次矩阵-向量乘,不需要任何运算器,一步物理过程完成——这正是"计算发生在数据所在地"的字面实现。
功耗口径同样漂亮:阵列级的乘加能效可以做到每运算 1 至 10 飞焦耳量级(含外围电路后升到几十飞焦耳),比数字方案的皮焦耳级又低了一到两个数量级。演示规模从早期的十几乘十几,推进到千行千列级集成;多阵列拼接与三维堆叠是规模化的主要路径。
图:忆阻器交叉阵列——用欧姆定律与基尔霍夫定律做矩阵乘
三道精度关卡:为什么它还没统治世界
第一关是器件本身。忆阻器的电导写入有噪声、会随时间与读次数漂移,多值存储(一层存 2 比特以上)时误差被放大;不同器件之间还有个体差异,良率与成品率是工程化的第一敌人。第二关在阵列物理:导线不是理想导线,大阵列边缘的器件实际分到的电压被寄生电阻拉低(IR drop),等效于权重被系统性打折——大阵列反而不如小阵列准,这与"越大越省"的商业直觉相反。第三关在外围:交叉阵列输出的电流要经模数转换才能进入数字世界,ADC 的面积、功耗与延迟常常吃掉器件级省下的能效;文献里不少"数字辅助"方案(部分求和、稀疏跳读)本质都是在给 ADC 减负。
工程上的现实做法是"混合信任":对精度敏感的层留在数字域,对精度宽容的特征提取层交给模拟阵列;推理用模拟、学习用数字脉冲对器件做原位调制。这也是为什么本节属于第 5 章而非取代 5.2——两条路线(数字核与模拟阵列)目前在产品里是分工而非替换关系。
💡 一个选型判断口诀:任务能容忍 1% 量级的数值误差(语音关键词检测、异常检测、姿态分类)——模拟阵列的能效红利值得拿;任务是精度敏感的分类头或回归输出——留在数字域。误差预算先于能效预算做决定,顺序反了会返工。
器件家族里其实不止忆阻器一个候选,把主要玩家摆在一起看更全面。阻变存储器(RRAM,即通常说的忆阻器):氧空位导电细丝的形成与断裂改变电导,写快、集成度高,是交叉阵列文献的主力。相变存储器(PCM):晶态与非晶态的电阻差承载权重,Intel 有多年量产经验、耐久性与多值能力经过工业验证,IBM 在其上做出过多值精度的深度学习推理阵列。铁电场效应晶体管(FeFET):用铁电极化状态调制晶体管阈值电压,读是非破坏性的、与标准 CMOS 兼容性好,被认为是最接近"嵌入片上学习权重"的形态之一。闪存改造路线:直接拿浮栅晶体管的阈值电压当权重,能效不惊艳但成本几乎为零,多见于早期演示。四条线的共同点是"以模拟量存权重",分歧在耐久性、多值精度与工艺集成度——选器件基本等于选你的任务更怕哪个缺点。
一次完整的"训练好的网络进阵列"流程也值得走一遍,它揭示了器件路线特有的一类工作。假设一个两层卷积特征提取网络要进 256×256 的 RRAM 阵列:第一步是权重映射设计——卷积核怎么复制到多行、负权重怎么处理(差分对:两个器件的电导差表示正负,阵列利用率减半但省掉符号电路);第二步是写入校准——逐个器件执行"写-读-微调"循环把电导拉到目标值,工业演示里这一步占部署时间的最大头;第三步是推理验证——标准数据集上跑一遍,统计阵列输出与浮点基线的误差分布,误差超限就回到第一步调整映射粒度(比如把一个权重拆到两个器件取平均,用面积换精度)。这套流程与数字芯片的"编译-烧写-验证"精神相同,但每一步都多一层统计性质——器件路线的工程门槛,主要就门槛在这里。
商业化进度给个务实的坐标:研究演示的规模已到百万器件级、能效数字诱人,但"可现场部署"的产品里它还主要扮演协处理器角色(特征提取、关键词检测的前端),主计算仍由数字电路承担。把它当作"能效上限的路标"而不是"明年的采购清单",是目前最健康的姿势。
把三道关卡的相对严重性量化一下,帮你判断具体方案卡在哪。器件漂移的影响随时间增长,表现为部署数月后精度缓慢下滑,对策是周期性"回写校准"——把每个器件的电导重新拉回目标值,代价是一次全员写循环;阵列压降的影响随阵列规模二次方恶化,表现为"阵列越大边缘越不准",对策是把大阵列切成小阵列并联(牺牲面积效率换精度);转换开销是固定税,表现为"小网络算不清账"——阵列本身再省,一次模数转换的能耗摊到少量乘加上就不划算,对策是让每个阵列尽量满负荷干大矩阵的活。三种失配对应三种失败模式,反过来读:如果你的系统精度是"随时间缓慢变差",查器件漂移;如果"网络越大越不准",查压降;如果"小任务能效不如数字方案",查转换开销。诊断比调参优先,这是器件路线的工程守则。
对学习者的实践提示:器件路线的门槛在工艺,但理解与评估的门槛不在——你完全可以在这条路线上做出高质量的系统工作而不碰一次流片。方法是用行为级建模:把器件写成带噪声与漂移的电导模型,把阵列写成带寄生参数的电路方程,然后在普通计算机上研究"精度损失随阵列规模、位宽、噪声水平的缩放规律"。文献里大量优秀的架构论文用的正是这种方法,它的产出(误差预算模型、映射策略、校准算法)在真器件到来时可以直接套用——这也是 8.2 节"用误差预算参与新器件"的具体做法。
交叉阵列是第 1 章那笔账的终点答案:当"读权重"与"做乘加"合并成同一个物理事件,搬运税彻底归零。它还欠三笔精度债——器件漂移、阵列压降、转换开销——谁先还清,谁改写能效曲线。
下一节把已经出货的四颗代表性芯片摆上同一张桌子,用统一口径横评。