2.2 信息怎么编码:率码、时码与首达时间
2.2 信息怎么编码:率码、时码与首达时间
本节摘要:脉冲是全有全无的事件,数值信息只能藏在脉冲的组织方式里。率码用发放次数表示大小,稳健但费时间;时码用发放时刻表示大小,省脉冲但要求精确时钟;首达时间让最强信号最先说话,天然适配事件相机。本节给出三种编码的账目和选择准则。
上一节造出了会发放的神经元,本节回答编码问题:怎么把"0.73"这样的连续量装进一串 0 和 1 的脉冲里。这不是实现细节,而是直接决定系统能效与延迟的上层设计——编码选错,后面芯片再省电也补不回来。
率码:数次数,最稳健也最昂贵
率码(rate coding)把数值映射到单位时间内的发放次数:值越大,发得越密。它是最早被证实存在于生物神经系统的编码(触觉强度、肌肉张力都近似率编码),也是今天 SNN 工程的默认选项,原因有三:统计上稳健,几次脉冲的抖动不会翻转结论;与人工神经网络的激活值兼容(激活值直接对应目标发放率),第 4 章的 ANN 转 SNN 路线全靠这一点;硬件上无需精确时间戳。
代价是时间和能量。要在时间窗 T 内以 1/T 的分辨率区分两个值,较弱的那个至少要发出可数的脉冲数。粗略地说:想在 100 毫秒窗内区分 100 个灰度等级,平均发放率要跑到千赫兹量级——每个像素、每个周期都在发脉冲,稀疏性红利就没了。生物视觉通路的应对是联合编码:单个神经元的率分辨能力并不高,靠成千上万个神经元并行"投票",几毫秒内就能完成判读——这个"种群率码"思路在工程上同样适用。
时码与相位码:把数值写进时刻
时码(temporal coding)用发放的绝对或相对时刻表示数值:值越大,发得越早(或相位越靠前)。它把信息密度从"每窗几个脉冲"提升到"每脉冲一个连续量",理论工作估计单个脉冲可携带数比特信息,而率码每脉冲只携带零点几比特。生物证据是充分的:视网膜到脑的传输里,第一波脉冲的相对时序就携带了高对比度信息,不需要等后续脉冲积累。
工程代价也明确:需要微秒级的公共时钟基准和同步保证,发射端和接收端都要为时间精度付费。它在两类场景划算——一是脉冲预算极紧的低功耗传感(每像素只允许发一两个脉冲),二是延迟本身就是输出的任务(第 6 章的飞时间估计)。
首达时间:事件相机的天然搭档
首达时间编码(time-to-first-spike, TTFS)是时码的特例:一个时间窗内每个神经元至多发一个脉冲,输入越强发得越早,窗结束或读到首个强脉冲即出结果。它有两个工程上的妙处。其一,与事件相机无缝衔接——事件本身就是"变化发生"的时刻,强度对应亮度变化的对数值,延迟发射即可,无需任何转换电路。其二,推理可以提前终止:信号最强、最有把握的类别最先发声,下游不必等满时间窗,平均延迟随任务难度自适应——这是帧驱动管线做不到的。
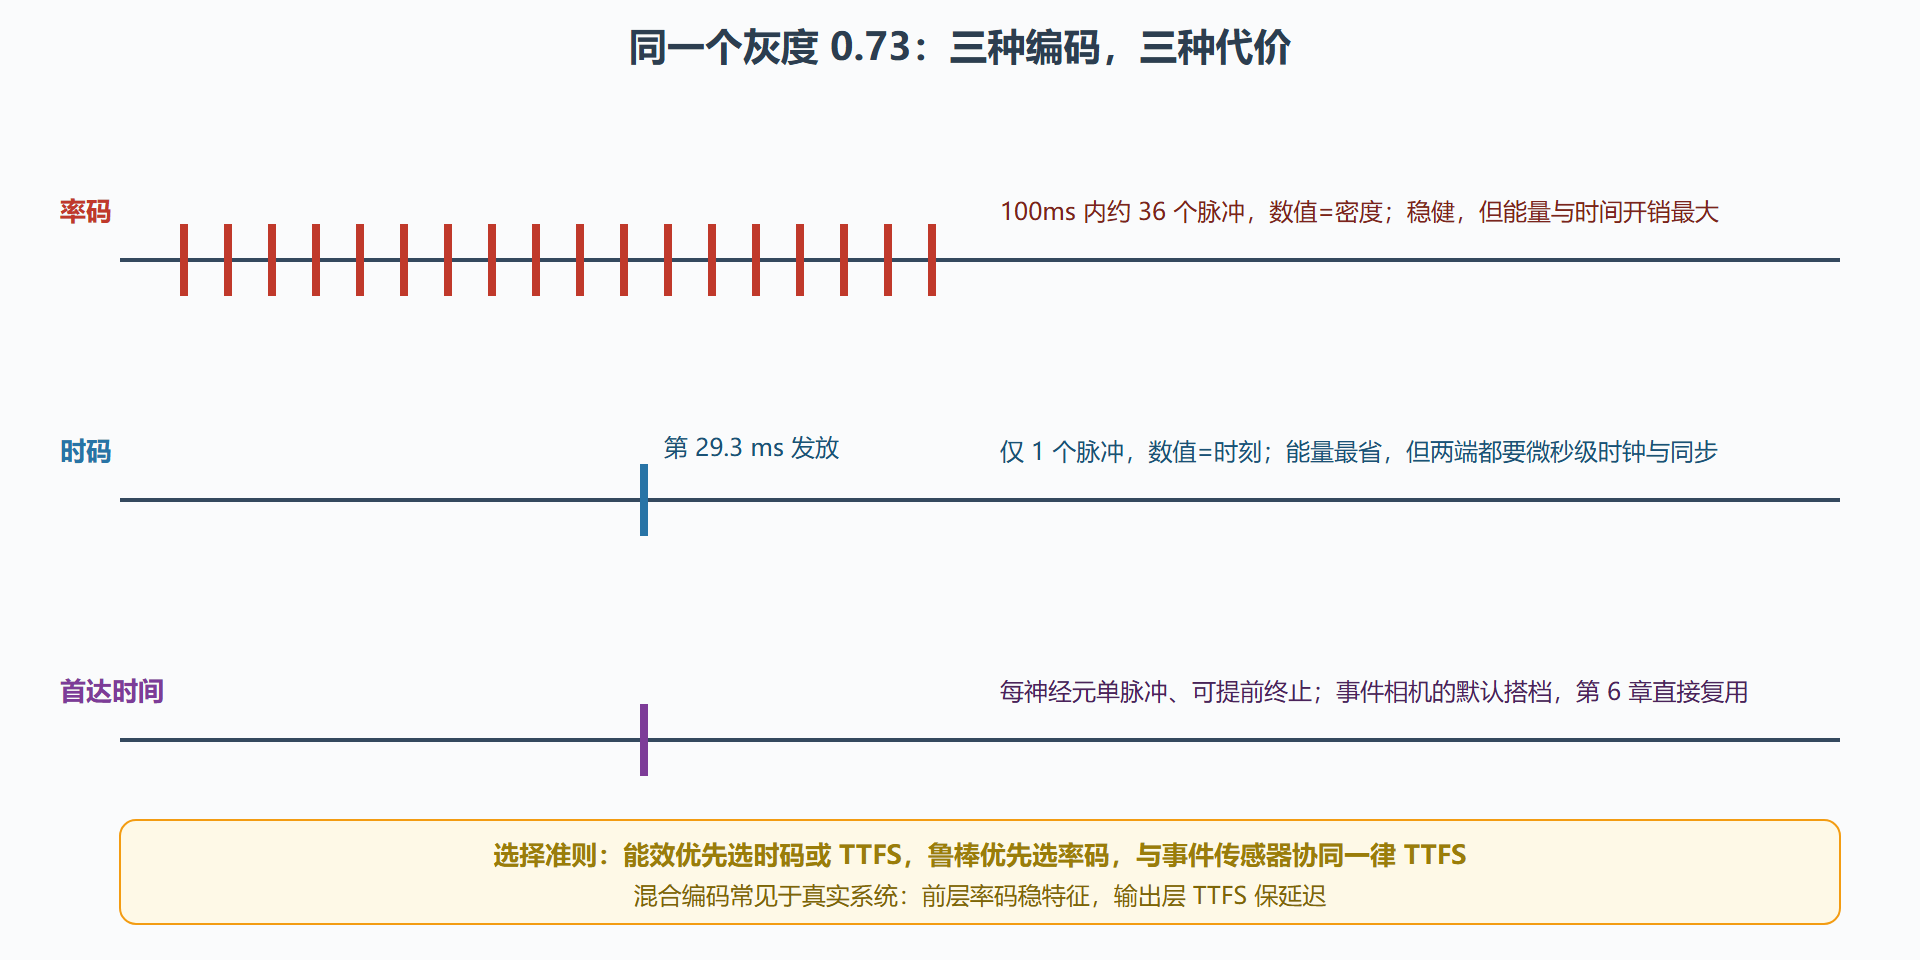
# 三种编码的最小演示:同一个灰度值 0.73 的三种脉冲形态 value = 0.73 window_ms = 100 # 率码:值越高发放越密(假设最高 50 Hz) rate_hz = value * 50 n_spikes_rate = int(rate_hz * window_ms / 1000) # 约 36 个脉冲 # 时码:值越高发得越早(映射到 5..95 ms) t_spike = 5 + (1 - value) * 90 # 第 29.3 ms 发 1 个脉冲 # TTFS 推理模拟:三类神经元,谁的值大谁先响 scores = {"cat": 0.31, "dog": 0.73, "bird": 0.12} order = sorted(scores.items(), key=lambda kv: 5 + (1 - kv[1]) * 90) print("按首达时间排序:", [k for k, _ in order]) # dog 最先发声 print(f"率码脉冲数 {n_spikes_rate} vs 时码脉冲数 1") # 同样的信息,率码用了 36 个脉冲,时码用 1 个——能量与时间的交易一目了然
图:同一个数值在三种编码下的脉冲形态对比
怎么选:三问过滤器
第一个问题:你的传感器输出什么?事件流输入配率码等于先把稀疏事件再灌回密时间栅格,自废武功,应选 TTFS 或直接脉冲透传。第二个问题:你的时间预算多少?响应要求低于 10 毫秒的任务慎用纯率码——脉冲数不够统计,噪声会吞掉精度。第三个问题:硬件有没有全局时钟?异步芯片(第 5 章的 Loihi 类)上率码依旧可行,但跨芯片时码要额外同步协议,成本常被低估。
实际系统往往是混合编码:卷积特征层用率码换取稳健,读出层用 TTFS 换取低延迟和提前终止。生物神经系统走的也是这条路——早期视觉通路率码与时码并存,运动计划区用到达时刻传递"何时动手"。编码不是教条,是按环节分配时间精度和能量预算的会计制度。
工程实录里还有两个跨节点的坑值得预警。坑一:编码与训练的不一致。训练时用泊松率码编码静态图像,部署到 TTFS 读出的芯片上——训练与推理的编码语义错位,精度 silently 掉十几个百分点是常事。规矩是:编码方案属于网络定义的一部分,从训练第一天起就锁定,写进配置、跟权重一起管理。坑二:时间窗与 tau 的耦合。率码的窗长、LIF 的膜时间常数、芯片的时间步三者量纲耦合:窗内脉冲数不足时统计噪声上升,窗太长又拖延迟。实用的调参顺序是先定窗长(由延迟预算倒推),再按窗长配 tau(通常取窗长的四分之一到一半),最后定编码脉冲率。
一个跨章的视角帮你把编码选择钉牢:第 6 章的事件相机输出的是"变化时刻",天然是时码语言;第 5 章的异步芯片原生吃脉冲事件;两者之间如果插入一段率码转换(把事件流积累成帧再转脉冲率),等于把刚省下的延迟又还了回去。所以全系统视角下,编码选型的第一原则是"与传感器同语言",第二原则才是任务的时间预算。
关于编码还有一层理论背景值得交代,它解释了为什么生物系统如此选择。信息论对率码与时码的容量分析表明:给定能量预算,最优编码位于纯率码与纯时码之间,且最优解随信噪比与时间窗滑动——生物听觉与视觉通路里"早期用时相、晚期用率"的混合现象,恰好符合这个理论预测。工程翻译:如果你的任务有严格的延迟预算,时相信息应该放在窗口前端(首达时间),统计信息放在窗口后端(脉冲计数)——很多高性能 SNN 的读出层设计正是这个结构的工程复刻。理论不必深究,但"编码是连续谱而不是三选一"这个认知,能帮你避免把系统设计成非此即彼的僵硬形态。
编码方式的本质是三个预算的分配:时间窗、脉冲数、时钟精度。率码花脉冲买稳健,时码花时钟买密度,首达时间花等待买稀疏——没有免费的那个,只有匹配你负载的那个。
至此问题链第二环完成:脉冲作为信息载体的机理与格式都清楚了。但脉冲从哪来、权重住在哪——第 3 章把神经元与突触这两个生物原型请进硅里。