5.5 工具链总览:从模型到部署的完整链路
5.5 工具链总览:从模型到部署的完整链路
本节摘要:芯片只是硬件,真正决定你能不能用起来的是软件通道:仿真器(Brian2、NEST、BindsNET、snntorch)验证算法,训练框架(替代梯度系)产出网络,映射工具处理资源约束,部署层(Lava、NxSDK、PyNN 各家后端)对接真硬件。本节画出全链路地图并标注每一段的常见坑。
前三章你可能已经注意到:每个硬件方案都在等一个能用的软件栈。1.2 节说过"软件生态慢硬件半拍"是这条路的系统性欠债——本节把欠债的现状盘清楚:从零写一个 SNN 到它在 Loihi 类芯片上实时运行,中间有哪些环节、每个环节用什么工具、哪里容易掉坑。本章剩余三节(5.6 仿真器、5.7 部署环境、5.8 编译映射)是这张地图的分段详解。
全链路的四段结构
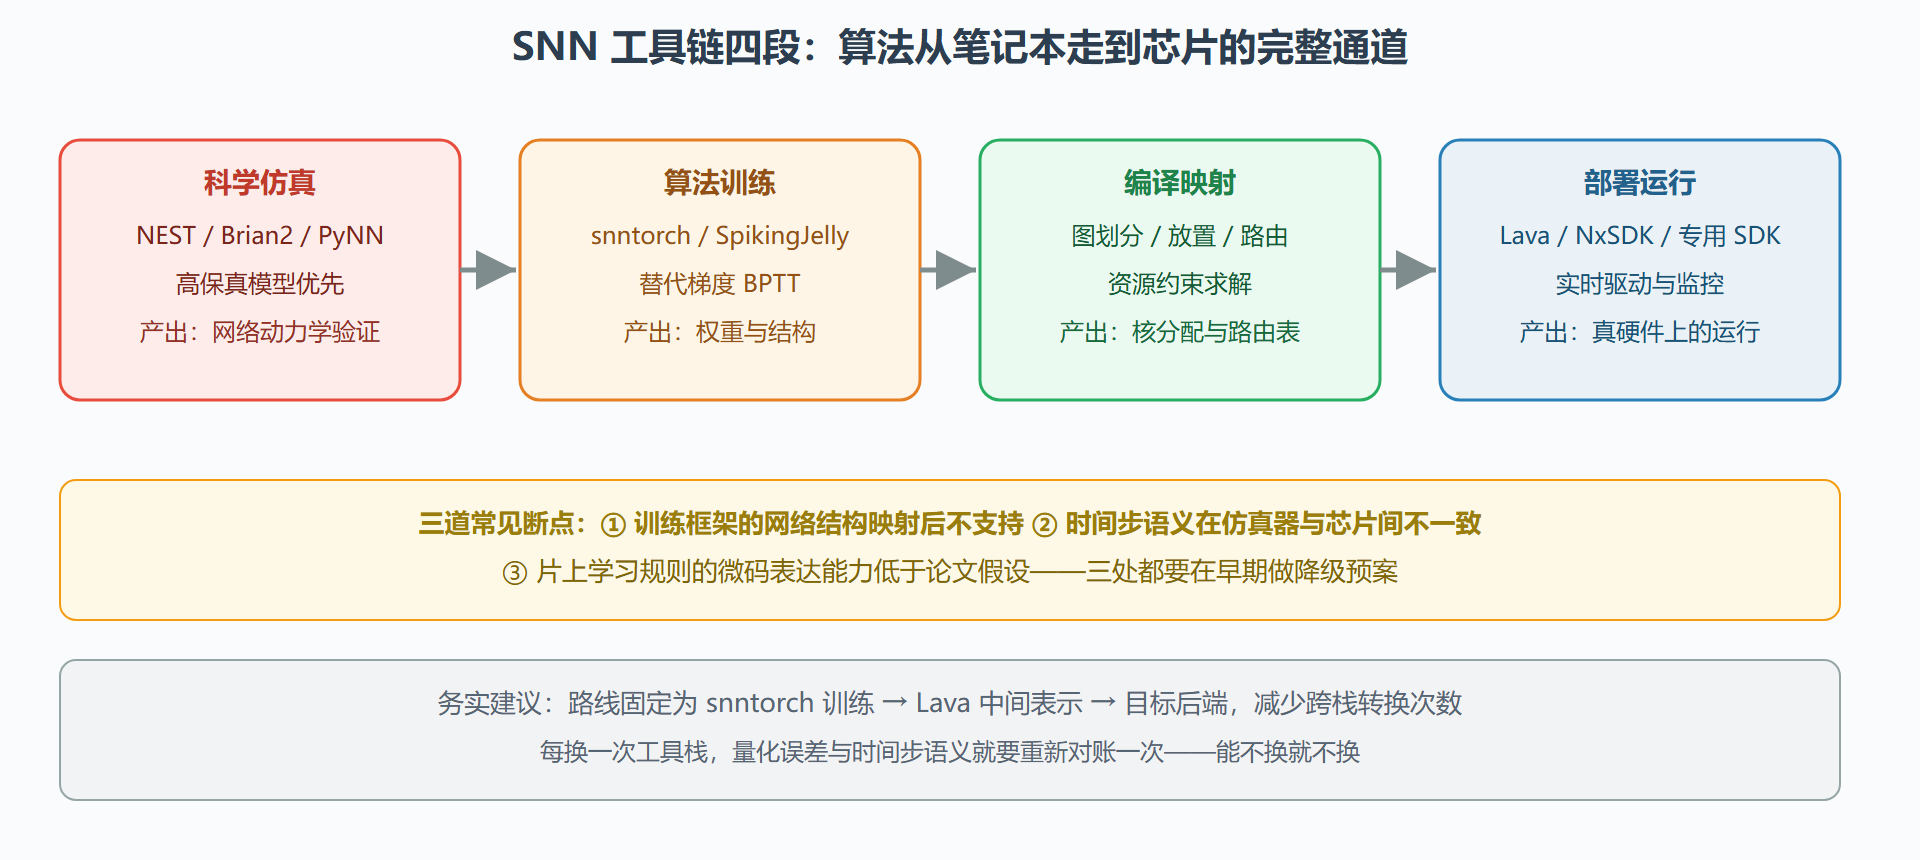
第一段是科学仿真:面向神经科学的高保真建模。NEST(专注大规模点神经元网络,蓝脑计划系工具,曾支撑十亿级神经元量级的仿真研究)、Brian2(Python 原生,方程即代码,几行就能跑一个自定义神经元模型)是这个段位的主力,SpiNNaker 与 BrainScaleS 的宿主软件走 PyNN 接口。这一段的共同特征是"模型自由度优先",运行效率其次。
第二段是算法开发:面向机器学习的 SNN 训练。snntorch(建立在 PyTorch 上,替代梯度路线的社区主流)、snnTorch 之外的 SpikingJelly(中文社区文档完善)、BindsNET(强化学习方向的早期选择)、Norse(函数式风格)。这一段的关键词是"梯度打通":第 4 章的替代梯度在这层实现,产出的是标准深度学习框架里的网络权重。
第三段是编译与映射:把网络变成芯片资源分配方案。要回答三个问题:每个核放哪些神经元、路由表怎么生成、时间步与精度怎么折算。各家芯片都有对应工具(Loihi 系的 Lava 编译流程、SpiNNaker 的 sPyNNaker 图分区器),共同点是把"放置与路由"当成一个带容量约束的图划分问题求解——5.8 节专门展开。
第四段是部署与运行时:真芯片上的驱动、监控与在线更新。Loihi 系走 Lava(开源,跨 CPU/GPU/Loihi 后端统一接口)或早期 NxSDK;商用边缘产品各有自家 SDK。这一段的特征是"实时性约束":仿真器里能跑的逻辑,到了真芯片要面对物理时间预算。
图:从模型到部署的工具链全图
段间转换的三处断点
第一处断点在第二到三段之间:训练框架里的网络结构(层类型、连接方式)映射后未必被支持——比如分组卷积、特殊激活、注意力结构在多数映射工具里没有等价实现。对策是在选结构时就查目标后端的支持列表,而不是训练完了再看。第二处在仿真器与芯片之间:时间步的语义差异。仿真器的 1 步通常是无物理含义的更新周期,芯片的时间步绑定微秒级时钟——网络在仿真器里 30 步收敛,芯片上可能因为时间常数与步长的比值不同而行为漂移,所有膜时间常数必须按目标时钟重新标定。第三处在学习规则上:论文里自定义的规则(三因素、多迹)到了芯片学习引擎的微码里可能表达不了,需要降级到支持的规则族——设计网络时就把规则写成目标硬件支持的形态,是省返工的关键习惯。
💡 给新手的路径建议:从 snntorch 训一个 5 时间步的 MNIST 开始,用 Lava 的 CPU 后端做中间验证,最后上 Loihi 云访问或仿真后端——三步都通了再去碰真实芯片,顺序反了会在第三段的坑里耗掉数周。
为帮助你在四段结构里定位自己的位置,把"典型角色与入口工具"对个号。神经科学研究者:入口是 NEST 或 Brian2,关注模型保真度与可复现性,输出是论文级的网络动力学;机器学习算法工程师:入口是 snntorch 或 SpikingJelly,关注精度与训练效率,输出是训练好的权重加网络定义;芯片映射工程师:入口是目标平台的编译工具,关注资源利用率与时序正确性,输出是映射报告;系统集成者:入口是 Lava 或厂商 SDK,关注实时性与总功耗,输出是能跑的产品原型。四个角色对"同一份网络"的关心点完全不同——这也是为什么 5.5 反复强调"语义对账":网络从算法工程师手里传到映射工程师手里,掉进语义缝隙里的东西没人负责就会变成线上事故。
四段结构还有一条时间维度的规律值得记住:越往右,迭代的单位成本越高。算法段的迭代单位是分钟(GPU 重训一轮),映射段是十分钟到小时(编译加资源检查),部署段是小时到天(板级调试)。所以工程管理的黄金法则是在左边多迭代:算法阶段就把映射约束(结构支持列表、稀疏度目标、时间步预算)作为硬约束写进训练配置,把本该在右边暴露的问题搬到左边解决。
选工具时还有一个"反直觉"的准则值得写下来:工具的成熟度与它的新颖度经常成反比,而工程价值几乎总在成熟的一侧。具体说:一个三年没大改、文档齐全、报错信息友好的工具,比一个半年前发布、论文漂亮但接口常变的工具更值得进你的关键路径;后者适合放在探索分支里试。判断成熟度有三个快速信号:版本日志的节奏是否稳定、社区问题是否有人响应、有没有第三方在用它产出成果(论文、产品、教程都算)。三个信号的综合比 Star 数可靠得多——这个领域的不少明星项目热度高但可用性一般,而一些低调的工具(如 Brian2 的核心、PyNN 的后端适配)多年来是无数真实项目的底座。
开源参与是这个领域被低估的一条捷径。工具链四段里的主流项目全部开源,而它们的维护者对"认真提交问题报告与修复"的外部贡献者极其友好——一个修复了映射工具边界情况的合并请求,能为你换来核心开发者的直接支持,这种支持在闭源商业软件里要花顾问费。更进一步,把你的标定脚本、对账表模板、基准实现整理成开源小工具发布,是低成本建立领域信誉的方式——8.3 节谈产学研借力时说的"卡位",具体动作就是这些。
工具链的本质是一条"语义保真"的传送带:网络经过四段搬运,每换一段都可能失真一次。老手和新手的差别不在会不会用某个工具,而在知道哪里会失真、用什么对账。
后面三节把地图走深:5.6 讲仿真器的选择与写法,5.7 讲部署环境的真实体验,5.8 讲编译映射的约束求解。