6.2 硅耳与事件音频:听觉通路的芯片化
6.2 硅耳与事件音频:听觉通路的芯片化
本节摘要:硅耳(silicon cochlea)把人耳耳蜗的频率分解机制做进模拟或混合电路:一排沿级联滤波器阵列排布的频率通道,各通道只在自身频段有能量变化时发事件。它复刻了 6.1 节的同一套哲学——变化驱动、异步输出——并带来事件音频独有的礼物:毫瓦级功耗下的持续监听与毫秒级声源定位。
上一节把视觉事件化讲透了,本节看听觉。选择讲硅耳而非泛泛的"语音处理",是因为它是生物启发最"原教旨"的一支:电路的物理排布直接模仿耳蜗的机械结构,连"沿深度对数排布"的细节都保留了。
生物原型:耳蜗是一台机械傅里叶变换器
人耳耳蜗里有一张基底膜,其刚度沿长度方向渐变:高频声波在入口附近共振,低频传到深处共振——约 3500 个内毛细胞沿膜排布,各自探测本位置的振动,相当于一台逐通道带通的机械频谱仪。两个特性对工程极其重要:一是对数频率轴(低频段分辨率远高于线性轴,人耳在 20 赫兹到 20 千赫兹里对 20 到 2000 赫兹的细分能力最强),二是自适应(毛细胞对持续音调的响应会衰减,对新音调敏感)。
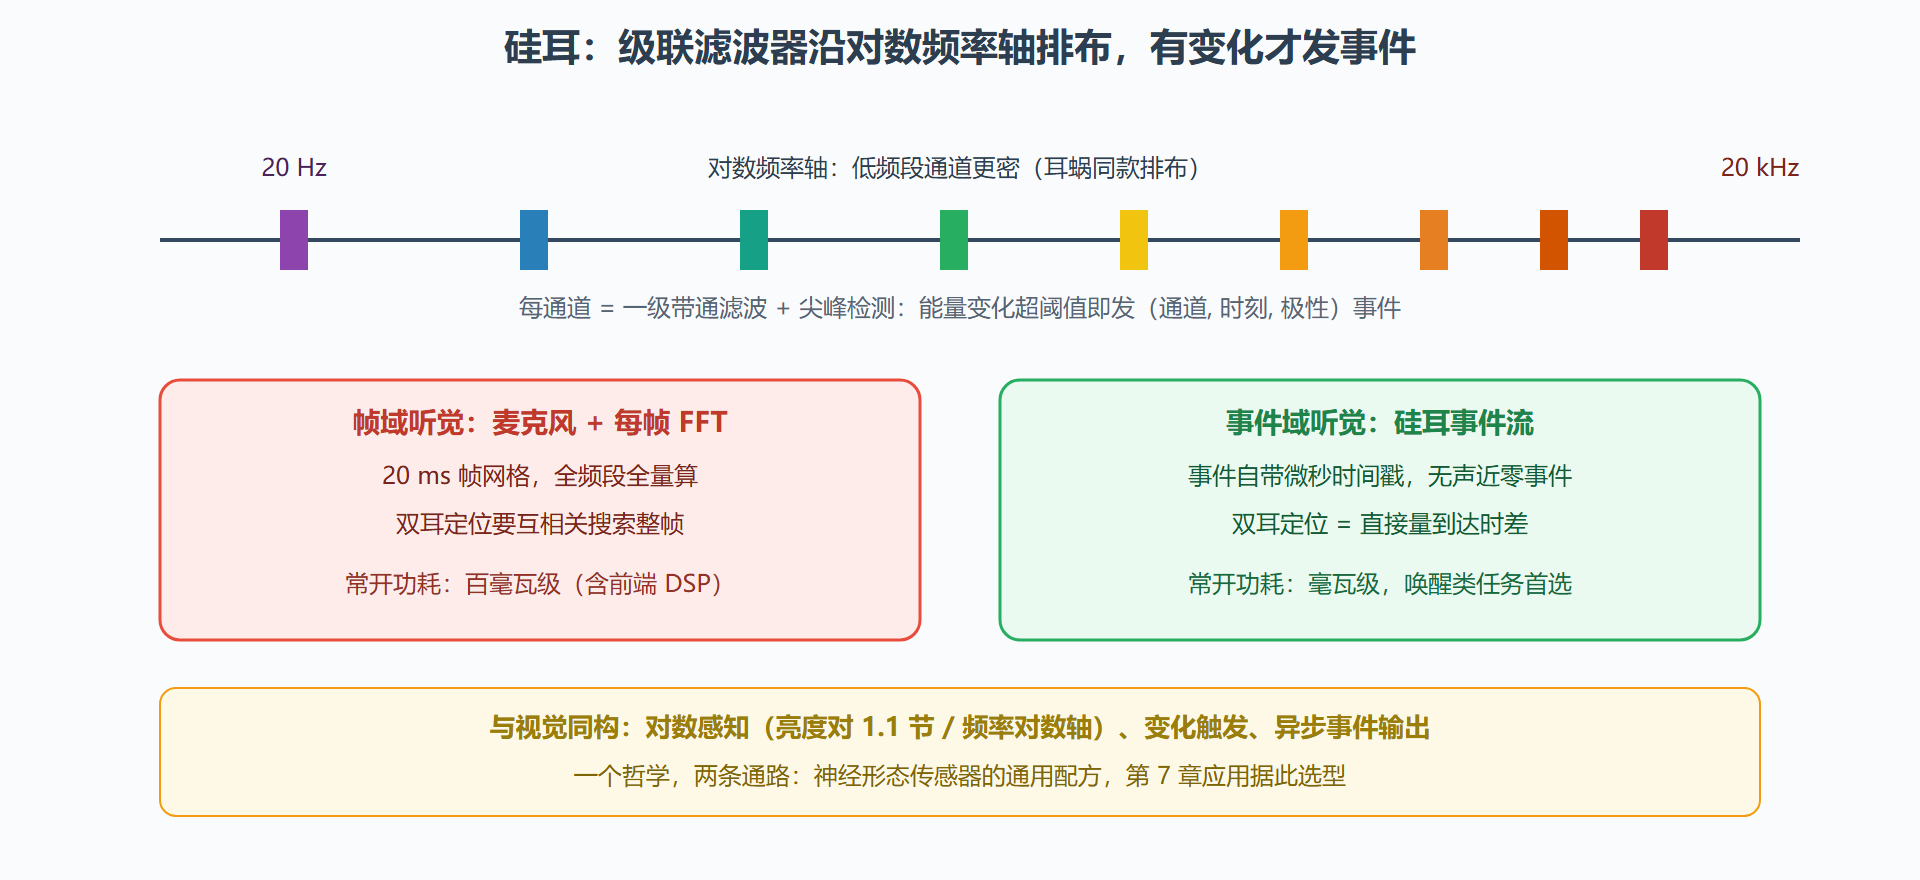
硅耳的电路化直译这两点:一串联级联的二阶滤波器,每级中心频率比前级低一个固定比例(对数排布),每级输出送一个尖峰检测电路——能量变化超过阈值就发事件(通道号、时刻、极性)。代表工作从 Lyon 与 Mead 上世纪八十年代末的首颗硅耳,到瑞士 ETH/苏黎世大学系线的级联硅耳、欧盟 NAVIS 与 Bosch 合作的事件麦克风,通道数从十几级演进到上百级,功耗毫瓦级。
事件音频的系统画像
把硅耳输出与常规麦克风加 FFT 的路线对比,三个差异是结构性的。第一,时序精度:事件自带微秒级时间戳,双耳两路事件流的到达时间差(ITD,人耳定位的物理依据,可低至 10 微秒量级)可以直接测量——声源定位在事件域是"数时差",在帧域是"互相关搜索",前者天然快且省。第二,稀疏结构:安静环境几乎零事件、语音段事件集中在少数通道,这正好喂给 3.3 节的稀疏编码逻辑;连续监听类应用(唤醒词、异常声响检测)的"常开功耗"因此能压到毫瓦级。第三,自适应自带:级联滤波器的 AGC 行为让响度变化被电路自动归一,下游网络不用再处理增益漂移。
# 事件音频前端的最小数字模拟: gammatone 滤波器组的事件化输出 # (真实硅耳是模拟电路,此处用数字滤波近似它的输出行为) import math, random def gammatone_channel(signal, center_hz, fs, q=8.0): """简化的二阶带通:中心频率 center_hz,品质因数 q""" w = 2 * math.pi * center_hz / fs r = 1 - w / (2 * q) # 阻尼近似 y1 = y2 = 0.0 env = 0.0 events = [] for n, x in enumerate(signal): y = 2 * r * math.cos(w) * y1 - r * r * y2 + x y2, y1 = y1, y env = 0.9 * env + 0.1 * abs(y) # 包络(能量慢速跟踪) if env > 0.35: # 变化阈值触发 events.append((n, center_hz, +1)) # 事件 =(时刻, 通道, 极性) env = 0.0 # 触发后复位(不应期) return events fs = 16000 t = [n / fs for n in range(16000)] # 1 秒 sig = [math.sin(2 * math.pi * 1000 * x) * (0.6 + 0.4 * math.sin(2 * math.pi * 2 * x)) for x in t] # 1 kHz 载波,幅度起伏 events = [] for ch in (500, 1000, 2000): events += gammatone_channel(sig, ch, fs) print(f"1 秒音频产出事件 {len(events)} 个,集中在通道 {sorted(set(e[1] for e in events))}") # 输出模式:事件集中于 1 kHz 通道且随 2 Hz 包络成簇—— # "何时说"的时序结构与"哪个频段"的通道结构同时保留,供下游 SNN 消费
下游怎么吃:从事件到听觉认知
事件音频与脉冲网络的衔接比视觉更顺滑,因为听觉系统本身就是"变化驱动"的:生物听觉通路对瞬态( onset )远比对稳态敏感,硅耳的输出特性与此对齐。经典任务链路是:硅耳事件流 → 抑制性中间层做同通道时间竞争(相似事件被快速抑制,保留新颖性)→ STDP 网络在时间维度学习模式(第 4 章 4.1 的规则在这里学到的是"哪个通道簇先于哪个通道簇",即语音的时序结构)→ 输出层分类或触发。文献里这类系统做关键词唤醒、异常声检测(电机故障音、玻璃碎裂)的功耗都在毫瓦到几十毫瓦级,比"麦克风 + 常开 CNN"低一个数量级以上。
一个工程提醒:硅耳目前没有事件相机那样的商业化成熟度——商用产品里更常见的是"数字 Cochleagram 前端 + 脉冲化后端"的折中(用标准麦克风,前端数字滤波器组模拟耳蜗,输出再转事件)。做产品评估时要分清这两条路线的功耗与延迟差距:纯模拟硅耳最优,数字折中次之,全帧方案垫底。
图:硅耳的对数频率轴与事件输出模式
评估一套事件音频方案时的三个实测要点,帮你把"参数表数字"变成"自己场景的数字"。要点一是事件率画像:与视觉同理,录你的典型声环境(安静办公室、车间底噪、街道),统计各通道的事件率分布——安静环境的事件率决定了常开功耗,繁忙环境的峰值决定了带宽预留。要点二是定位精度实测:双耳布一个标准间距(人耳约 15 到 20 厘米,工程阵列可拉大提高精度),用标准声源在已知方位播放测试音,量测到达时差的估计误差——微秒级的时差测量能力要靠这个实验验证,而不是信参数表。要点三是阈值与不应期的联合标定:不应期设得太短,同一个音头会产生事件簇;太长,连续音节的时序细节被抹掉。语音任务对口齿清晰度敏感,异常检测任务对频段完整性敏感,标定的侧重不同。
一个落地组合的现实案例收尾:工业设备的"听诊"应用(轴承异响、气路泄漏检测)是事件音频性价比最高的落点——被测对象固定、频谱特征稳定、环境常年监听,事件方案把"每周巡检一次"变成"持续在线告警",整套系统用数字折中前端(麦克风加滤波器组事件化)加小型 SNN 就能实现,功耗毫瓦级,一组电池撑一年。这个案例的模板可以直接套用到电梯、水泵、风机等任何"固定设备加异常声音"的场景。
硅耳证明事件化不是视觉的特例而是感知的通法:对数感知、变化触发、异步输出三件套,凡是生物持续监听的通道都适用。听觉这条线还多送一样东西——事件自带的时间戳,让"听声辨位"从搜索问题变成了读表问题。
至此传感端讲完。第 7 章把传感器、网络、芯片组装成完整系统,进入应用与评估。