3.2 长肥管道:卫星 RTT 下 TCP 为什么失灵
3.2 长肥管道:卫星 RTT 下 TCP 为什么失灵
「长肥管道」(Long Fat Network,LFN)是传输层行话里少有的自嘲式命名:链路"长"(RTT 大)、又"肥"(带宽高),两个特性相乘得出一个巨大的带宽时延积,把传统 TCP 的设计前提顶到了墙角。卫星链路——尤其 GEO 与跨多跳 ISL 的 LEO 路径——是天然的 LFN。本节算清 BDP 这笔账,拆解 TCP 在高 RTT 下的三处失灵点,给出工程上验证过的缓解手段。
先算 BDP:管道里能装多少数据
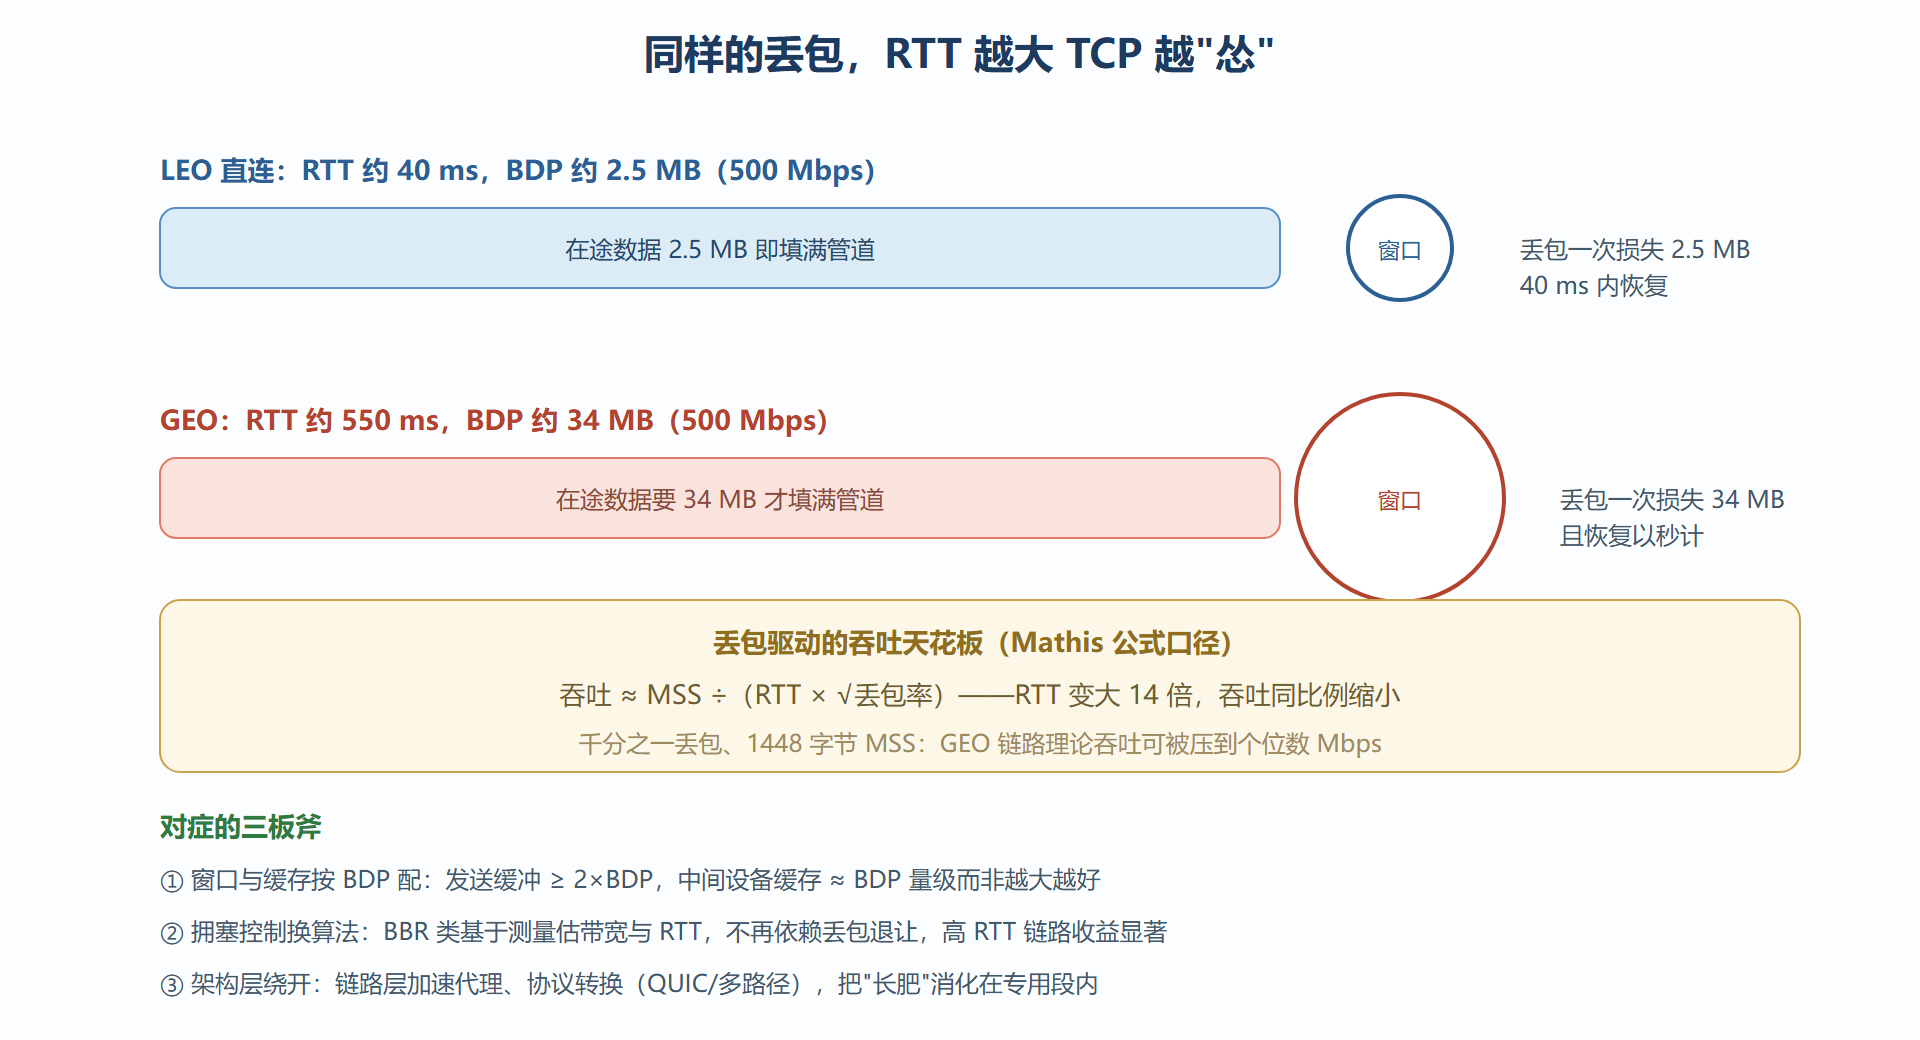
带宽时延积(BDP)= 带宽 × 往返时延,物理含义是"这条管道里同时飞行着多少数据"。代入卫星链路:一条 500 Mbps 的 GEO 链路,RTT 约 550 毫秒(含协议栈与处理开销),BDP = 0.5 Gbps × 0.55 s ≈ 275 兆比特 ≈ 34 MB。也就是说,发送端必须维持至少 34 MB 的在途数据才能喂饱管道;若用 LEO 直连路径 RTT 约 40 毫秒,同带宽 BDP 只有 2.5 MB。两个推论立刻出来:一是吞吐与 RTT 直接挂钩——传统 TCP 的稳态吞吐约等于 MSS 除以(RTT 乘以丢包率的平方根),同样千分之一的丢包率,RTT 550 毫秒的 GEO 链路吞吐比 RTT 40 毫秒的 LEO 链路低一个数量级;二是中间设备缓存必须按 BDP 配置——缓存小于 BDP,管道吃不满;盲目大于 BDP,又引发缓冲膨胀(bufferbloat),排队时延飙升反过来拖累交互业务。
图:BDP 与 TCP 窗口在高 RTT 下的行为差异
TCP 在卫星链路上的三处失灵点
第一处失灵在丢包归因。传统 TCP 把丢包几乎等同于拥塞,触发窗口减半。但卫星链路的丢包大头常常不是拥塞:Ka 频段暴雨瞬时衰减(上一章的雨衰账)、波束切换瞬间的短暂中断(下一章的切换账)、星上排队策略波动,都会产生与拥塞无关的丢包。错误归因让 TCP 在本来就慢的管道上再主动踩刹车,雪上加霜。第二处失灵在慢启动。TCP 连接从初始窗口起步、按 RTT 节拍翻倍爬坡——RTT 550 毫秒意味着每 0.55 秒才翻一倍,爬到 BDP 要十几个 RTT,短连接(网页、API 调用)可能在整条连接生命周期里都没跑出慢启动。第三处失灵在确认节奏。一切拥塞反馈都要一个 RTT 之后才生效,RTT 越大控制环越迟钝,网络状态已经变了、调节才姗姗来迟,天然震荡。
缓解手段:从调参到换协议
工程上有三层手段,按代价从低到高。参数层:发送与接收缓冲按 BDP 配置(Linux 的 tcp_wmem/tcp_rmem 上限、应用层 SO_SNDBUF),启用窗口缩放选项,否则 64 KB 的旧上限在高 RTT 下连管道零头都盖不住。算法层:换用基于测量的拥塞控制(BBR 类直接估计瓶颈带宽与最小 RTT,不把丢包当拥塞信号),在高 RTT、非拥塞丢包场景收益显著;QUIC 因为把丢包检测与确认机制搬到用户态、握手与迁移代价低,天然适合频繁跨波束换路径的卫星终端。架构层:在星上或信关站部署性能增强代理(PEP),把端到端 TCP 拆成地面段与卫星段分别优化——这是 GEO 宽带时代的主流方案,代价是破坏端到端语义、与加密流量(QUIC 全加密)相性变差;新一代星座更倾向"链路质量保得住、端到端不拆"的路线,用多路径传输(MPTCP 类)把切换瞬间的路径交替藏起来。
一个动手小账把三种 RTT 的差距钉死:
import math def tcp_throughput_mbps(rtt_ms, loss_rate, mss_bytes=1448): """Mathis 公式口径的稳态吞吐估算""" return mss_bytes * 8 / (rtt_ms/1000 * math.sqrt(loss_rate)) / 1e6 for rtt, name in [(40, "LEO 直连"), (140, "LEO 两跳 ISL"), (550, "GEO 含处理")]: t = tcp_throughput_mbps(rtt, 0.001) print(f"{name}: RTT {rtt} ms -> 千分之一丢包下吞吐约 {t:.0f} Mbps")
同一公式下 RTT 从 40 毫秒涨到 550 毫秒,吞吐预期掉约一个数量级——这解释了两个产业现象:GEO 宽带服务商普遍内置 PEP 加速,而 LEO 星座把"实测往返几十毫秒"当核心卖点宣传:传输层性能本身就住在 RTT 里。
缓解手段的选型顺序:一张工程决策表
三层手段怎么选?按"业务可改动范围"与"性能目标"做二维决策。能改客户端与应用的(自营应用、企业专线):优先应用层优化——加大初始拥塞窗口、QUIC 替代 TCP、请求合并以减少往返次数,零网络改动、收益立竿见影。能改网络设备但动不了应用的(运营商、企业网管):参数层加算法层——缓冲按 BDP 校准、启用 BBR 类拥塞控制、在边界开启适当的确认过滤。两者都动不了的(公共互联网穿越场景):才考虑架构层的 PEP 代理,且必须评估三个副作用——加密流量的兼容性(QUIC 普及后 PEP 的可干预空间在收窄)、故障定位复杂度的上升(端到端语义被拆开)、以及双代理部署的运维成本。一个常见误区是反着来:先上 PEP 再调参,结果用最重的手段只拿到最轻的收益。正确的顺序永远是先榨干端到端手段,再考虑拆分端到端——这条顺序在 3GPP 与传统卫星两个阵营的工程实践里反复被验证。
常见问题
LEO 星座还需要这些优化吗?
分场景。直连链路 RTT 几十毫秒,BDP 在常规缓冲默认值附近,普通业务基本不用折腾;但经星间多跳的路径 RTT 累加(每跳约 20 毫秒量级),跨洋业务仍会撞上长肥管道问题。判断标准始终是算 BDP,而不是看星座新不新。
窗口缩放为什么常常没开?
历史兼容。部分老旧中间件对缩放选项处理不当,过去很多系统默认关闭;现代网络已普遍支持,但应用自设小缓冲(SO_SNDBUF 写死)仍是最常见的隐性瓶颈,排查时优先查它。
本节要点回顾
- BDP 是卫星链路的第一参数:GEO 500 Mbps 链路 BDP 约 34 MB,缓冲与窗口不按它配置就吃不满管道。
- 丢包归因错误是卫星 TCP 的头号病灶:雨衰与切换丢包被当成拥塞,无谓地砍窗口。
- 慢启动在高 RTT 下按秒爬坡:短连接可能整个生命周期困在慢启动里。
- 三层缓解手段:调参数、换算法(BBR/QUIC)、上架构(PEP/多路径),代价与侵入性递增。
传输层的问题解决了"跑得快",但几千颗星的转发面、路由表、频谱协调由谁统一拿主意?下一节看管控面的架构。