5.1 AI 调度:为什么规则引擎不够用
5.1 AI 调度:为什么规则引擎不够用
别以为调度问题会随算力增长自动变简单——恰恰相反,SAGIN 把调度从"可枚举"推成了"不可枚举"。地面基站的调度器在百毫秒尺度上为几十上百个用户排时频资源,规则加启发式够用;一个千星规模的星座,波束指配、功率分配、频谱复用、切换预案、缓存放置五件事耦合联动,维度相乘后的状态空间让规则引擎写下第一条规则时就已经过时。本节讲清 AI 在其中补的确切位置:不是替代规则,而是接管"规则写不完、写不准"的那部分决策,并给出一个可运行的最小调度示例。
决策量爆炸的算术
先看爆炸怎么来的。一个区域要协调的对象包括:头顶数十颗卫星(2.3 节)、每星数十个波束、每波束上百用户、每用户几种业务等级,再叠加每秒都在变的链路质量(雨衰、遮挡、多普勒残差)。波束指配问题的规模是"波束数 × 用户数"的组合级;若考虑连续时域上的功率分配,则是连续优化问题;若再叠加与地面网的同频协调(4.1 节),约束集随国别与台站数据库变化。传统方案的写法是"分层切割 + 手工规则":频谱先分、波束再配、功率最后填——每个子问题可解,但层间次优的缝隙漏掉的性能,行业测算普遍在两位数百分比。AI 的价值主张由此成立:用数据驱动的联合决策,把分层切割漏掉的部分捡回来。
两类用武之地:预测与决策
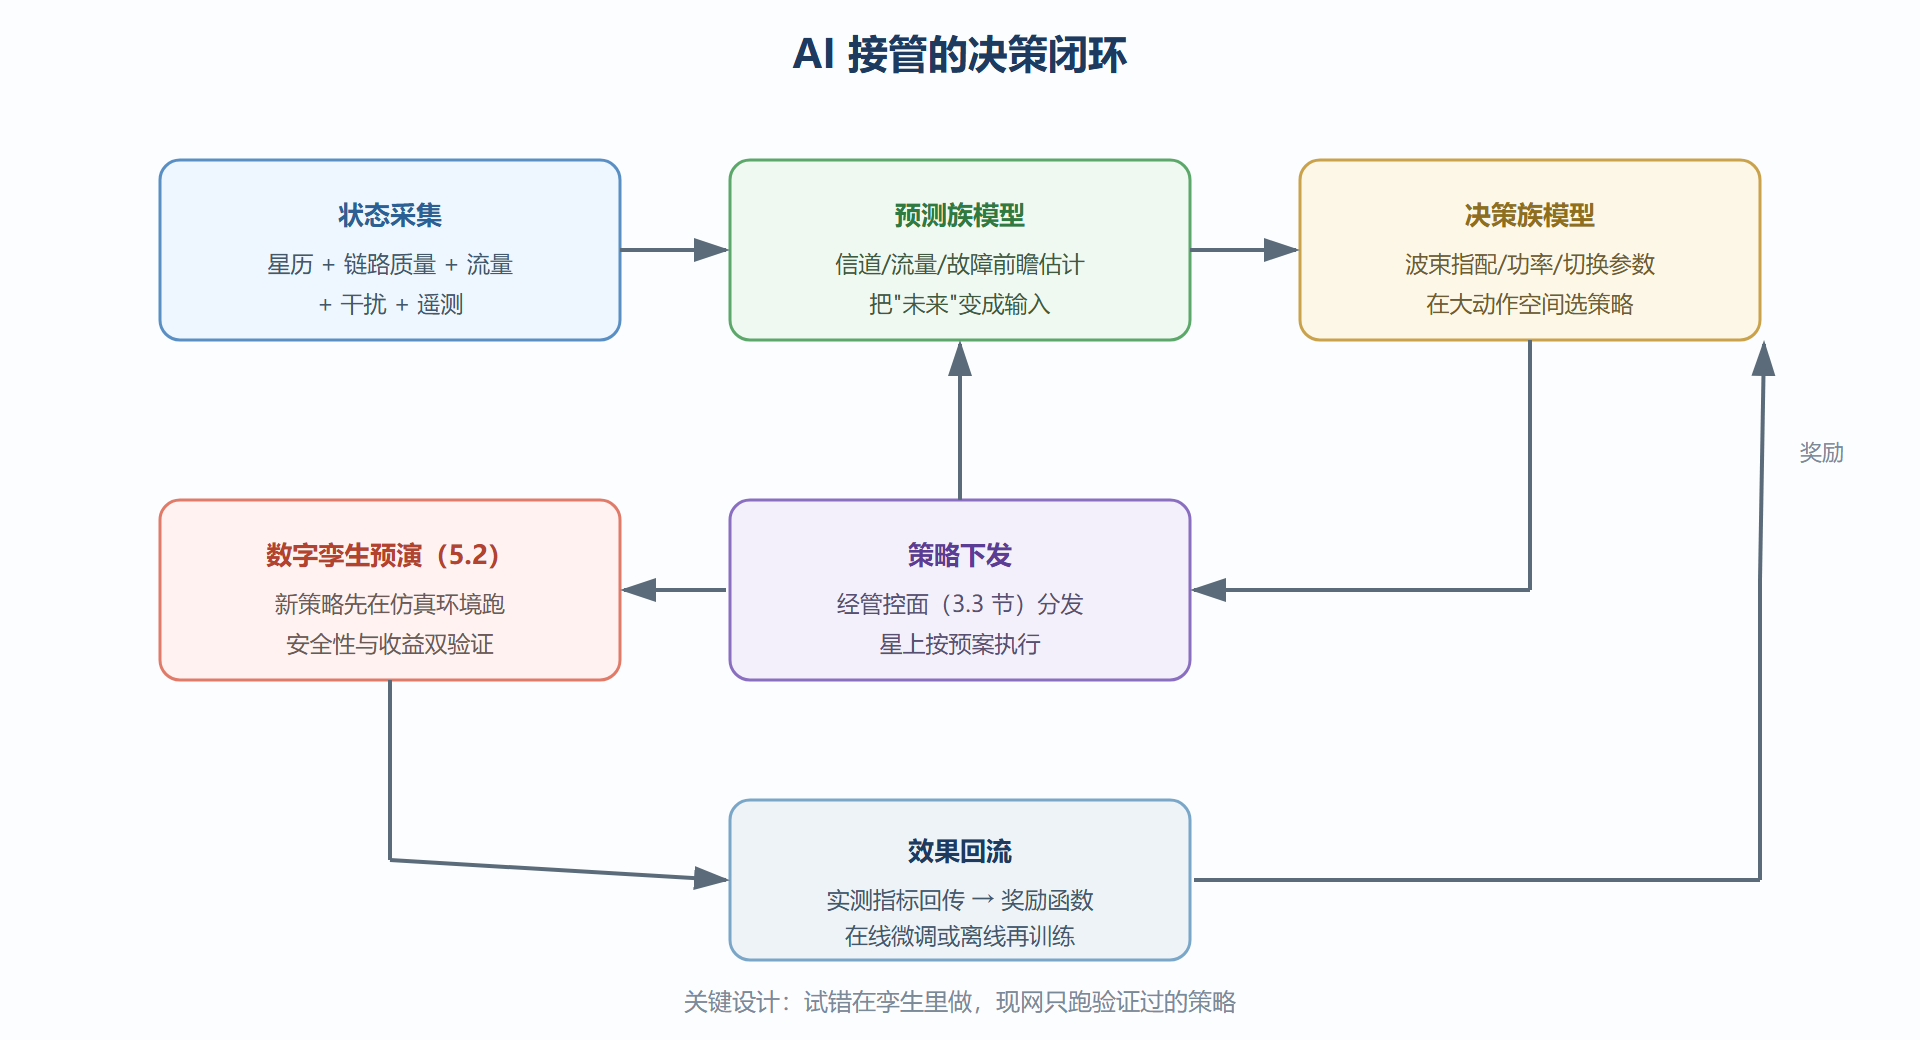
SAGIN 里的机器学习按输出类型分两族。预测族解决"把未来当输入":信道质量预测(给自适应编码调制提前调档,比反馈环快一个量级——3.2 节说过高 RTT 下控制环迟钝,预测正好绕开)、流量预测(波束容量按潮汐预配)、故障预测(星上遥测的异常检测,提前预警器件退化)。预测族的门槛在数据与泛化:训练数据要覆盖不同星、不同气候区,模型要在没见过的星上可用——这正是行业里"一个星座一个模型"行不通的原因。决策族解决"在巨大动作空间里选策略":强化学习让调度器在与环境交互中试错,奖励函数写成"总吞吐 − 时延惩罚 − 切换惩罚"的加权,策略网络学会的分配规则往往超出人工设计的表达力。决策族的门槛在安全:试错学习不能在现网上乱试——这就是下一节数字孪生存在的理由。
图:AI 调度在管控闭环中的位置
动手看骨架:一个最小化的强化学习调度器
不引入任何框架,用几十行实现"学习型波束功率分配"的骨架——三个用户共享总功率,环境按线性信噪模型回吐吞吐,智能体用策略梯度式的一阶更新找分配比例。数值是玩具量级,但决策闭环的五要素(状态、动作、奖励、更新、部署)一样不少:
import random def reward(powers, channels): """线性信噪模型下的总吞吐(bit/s/Hz 的玩具口径)""" return sum(ch * p for ch, p in zip(channels, powers)) def train(episodes=3000, alpha=0.05): w = [1/3, 1/3, 1/3] # 动作:功率分配比例(可学习的参数) for _ in range(episodes): channels = [random.uniform(0.5, 2.0) for _ in range(3)] # 依概率扰动生成动作(探索),再算奖励 act = [max(0.05, min(0.9, w[i] + random.uniform(-0.2, 0.2))) for i in range(3)] s = sum(act); act = [x / s for x in act] r = reward(act, channels) # 奖励高的方向按小步长拉参数(策略梯度思想) w = [max(0.05, min(0.9, w[i] + alpha * r * (act[i] - w[i]))) for i in range(3)] s = sum(w); w = [x / s for x in w] return w print("学到的分配比例:", [round(x, 2) for x in train()])
跑完会发现分配比例向信道好的用户倾斜且不塌缩到极端——这正是规则难以表述、学习算法自然逼近的"软最优"。真实系统的版本把三个玩具要素换成真家伙:状态换成星历与信道测量,动作换成波束-用户指配矩阵,奖励换成带 SLA 约束的加权目标,训练在孪生环境里跑(5.2 节)。
工程边界:AI 该被拦在哪些门外
有判断力的工程师要给 AI 划边界。三类场景不建议交给学习模型:安全攸关的硬实时动作(如星上防碰撞机动)——解释性与确定性要求高于性能收益;约束刚性的合规动作(如 4.1 节的 EPFD 功率上限)——合规是硬边界,学习模型的越界风险不可接受,AI 只能在边界内优化;数据不可复现的孤例(如新型故障的首次处置)——样本量为零,学习无从谈起。行业的成熟做法是"AI 出预案、规则守边界、人批重大变更",三者各守一段。
数据从哪来:AI 落地的真正瓶颈
模型与算法是行业谈论最多的部分,落地时真正的瓶颈却在数据侧。决策族模型需要"动作—结果"配对数据:什么分配策略产生了什么吞吐与时延——这类数据只有在策略真正被允许执行过的网络上才能采到,而没人敢让未经验证的策略上新网,鸡生蛋的死结由此而来。解开它的钥匙正是 5.2 节的孪生:在仿真环境里大量生成配对数据(仿真器的"动作—结果"天然配对),冷启动训练后再上现网采真实数据微调。预测族的数据瓶颈在标注与分布:信道预测的标签是未来信道,采集不难;故障预测的标签是故障事件,而故障天然稀疏——千天的运行数据里可用的故障样本可能只有个位数,这就是预测族模型在异常检测上常用无监督与自监督方法的原因。给数据侧的一个工程提醒:SAGIN 的数据带有强时空结构(星历决定了相关性模式),通用的时间序列模型未必比"用轨道几何做特征工程 + 简单模型"更好——把物理先验做进特征,常常胜过堆模型复杂度,这也是本领域与通用机器学习最大的口味差异。
本节要点回顾
- 决策量爆炸的根源是维度相乘:星 × 波束 × 用户 × 时变的耦合,让规则集覆盖不全。
- 预测族与决策族分工:预测把未来当输入,决策在大动作空间选策略;两者门槛分别在泛化与安全。
- 闭环五要素:状态、动作、奖励、更新、部署,缺一环都不算工程可用。
- AI 的边界:安全硬实时、合规刚性、零样本孤例三处不交给学习模型。
决策有了,但"试错学习"不能拿现网当实验田——预演环境怎么建才可信?下一节讲数字孪生。