1.4 IR 的抽象层次分类
1.4 IR 的抽象层次分类
本节摘要:IR 不是一个单点而是一条光谱:从贴近源代码的高层表示(HIR),到承担主流优化的中层表示(MIR),再到几乎就是汇编的低层表示(LIR)。本节建立"抽象层次"这根坐标轴,用同一段源代码在三个层次上的形态差异说明"降级"(lowering)的含义,并解释为什么现代编译器宁愿维护多个层次也不肯一杆子插到底。这一节是第3章(三地址码与 SSA 属于中层)和第8章(MLIR 把层次本身变成可编程对象)的共同入口。
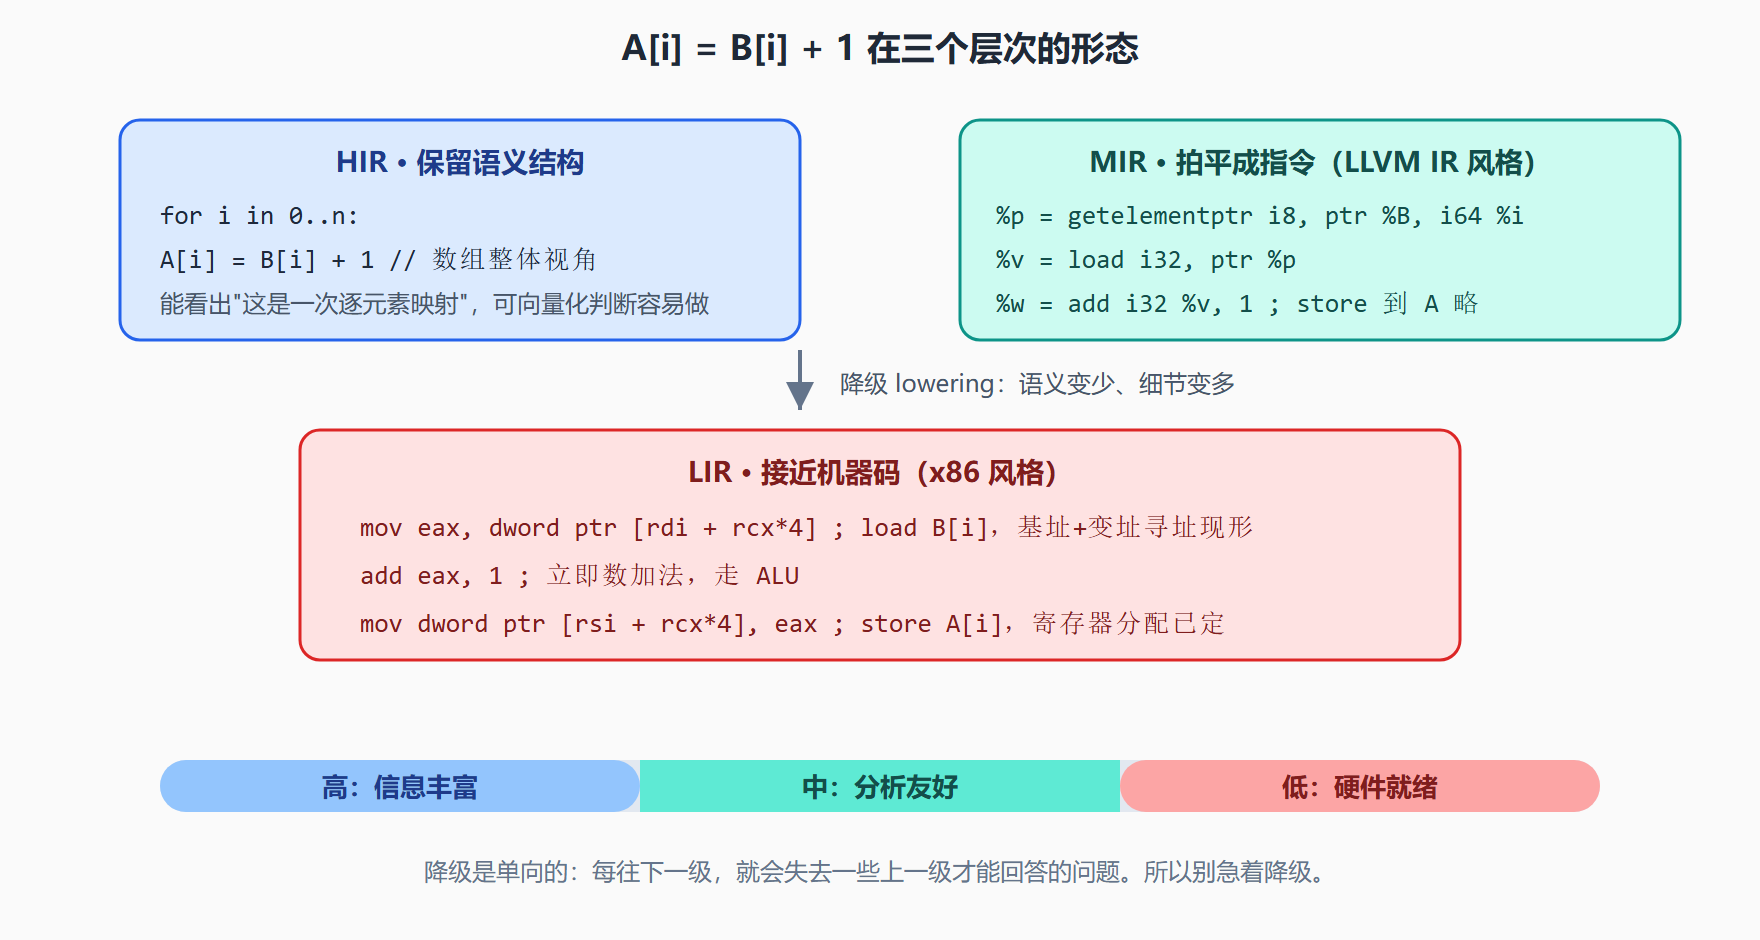
上一节说 IR 要"与硬件保持可翻译距离"——这个距离可长可短。同一个 A[i] = B[i] + 1,在高层次是"对数组做逐元素运算"(张量方言一句话),在中层是"取地址、加载、相加、存储"(LLVM IR 若干行),在低层是"寄存器寻址、带位移的 load、立即数加法"(机器指令)。哪个才是"真正的" IR?都对,它们是同一计算在不同抽象高度上的投影。
一、三个层次,三种天职
**高层表示(HIR,High-level IR)**尽量保留源程序的形状:控制结构、数组整体运算、类型构造器都还在。它的用户不是后端,而是"懂领域语义的优化"——数组边界检查消除、循环自动向量化、函数式程序的融合变换。语法树稍作整理(补上类型、消掉语法糖)通常就被当作 HIR 使用。
**中层表示(MIR,Middle-level IR)**是优化主力战场。它把控制流显式化为基本块和边,把计算拍平成一条条简单指令,同时仍然保留类型和"机器无关"的中立性。三地址码、控制流图、SSA 都属于这一层。本册第3到5章的所有内容都发生在中层。
**低层表示(LIR,Low-level IR)**开始出现寄存器名或虚拟寄存器、指令选择后的目标运算、调用约定细节。它离汇编只差最后一步编码。寄存器分配(第6章)在 LIR 上进行,因为只有到了这一层,"哪些值同时活着、机器到底有几个寄存器"才成为可回答的问题。
图:同一计算的三个抽象层次投影
二、为什么"分层"而不是"一层"
理论上可以设计一个万能 IR,让所有优化都在它上面做。实践上这条路走不通,原因有二。
其一,优化的信息需求不同。判断"这两个循环能不能融合"需要数组布局信息,这在 MIR 的 load/store 海洋里早已淹没;而寄存器分配需要的活性信息,在 HIR 里因为变量还没被拆成临时值,粒度又太粗。优化跑在它信息最全的那一层,是效率使然。
其二,降级是不可逆的。从 MIR 降到 LIR 之后再想问"这两个数组访问会不会重叠",答案已经不存在了。所以工程顺序固定为:在高层做完高层的事,再降级;在中层做完中层的事,再降级。每一次降级都是一道单向门。
⚠️ 初学者常犯的错是"一步到位":写玩具编译器时直接从语法树生成汇编,结果想做常量传播时发现优化要重写整个代码生成器。正确姿势是先老老实实设计一个中层 IR——哪怕只有十种指令——把前端和后端解耦,优化才有地方安放。
三、层次的两个极端样本
一个极端是 GCC 的 RTL:历史上它让中层优化(Web 与循环优化)直接跑在很低的表示上,导致这些优化不得不包含大量目标机特判。GCC 后来引入 GIMPLE(一个规整的中层表示,支持 SSA)承载大部分优化,RTL 退守后端——这次架构手术的实质,就是把层次切干净。
另一个极端是 MLIR:它把"层次"本身变成了可编程概念。任何团队都可以定义自己的方言(相当于自定义层次),写清从本方言到下一层的降级规则,剩下的基础设施全部复用。第8章会看到 linalg(高层)→ affine/scf(中层)→ llvm(低层)的完整降级链,那就是本节光谱的具体化。
本节要点回顾:
- IR 是光谱不是点:HIR 保语义、MIR 承优化、LIR 接硬件;
- 降级(lowering)是单向门:信息逐层减少,优化必须安排在它信息最全的层次;
- 分层的动机:不同优化需要不同粒度的信息,一层打不了所有仗;
- 历史注脚:GIMPLE 手术与 MLIR 的方言机制,分别是"把层次切干净"与"把层次做成产品"的两次实践。
变式演练:给五段代码定档
拿一把具体的尺子练手——判断下面每个片段大致落在哪一档:
t1 = a * a; t2 = t1 + a——纯三地址码,无类型修饰、无控制结构,MIR 档;Call foo(x).Add(y).Chain(z)式的方法链与虚调用——对象语义还在,HIR 档;%x = phi i32 [0, %entry], [%i, %body]——SSA 与 phi 显式在场,寄存器级 MIR 档;mov eax, [rbx + rax*4]带寻址模式的机器指令——物理寄存器、真实指令编码,LIR 档;C = matmul(A, B) /* 张量形状 1024x1024 */——矩阵乘还是原语,领域 HIR 档(第8章的主角)。
判档的两个有用问句:这段表示还知道多少"程序意图"?又知道了多少"机器事实"?前者越多越靠 HIR,后者越多越靠 LIR。同一个编译器在不同 pass 之间,同一段代码的档位是流动的——第5章优化在 MIR 做,第6章落地时逐级降到 LIR,第8章会看到"层次流动"被制度化为显式的降级链。
再补两个判档的边角案例。带调试信息的 MIR 算哪档?主表示还是 MIR——调试信息是旁挂的注脚,不改变主档位,正如 1.3 说的"IR 可以丢信息,但要另存"。带类型修饰的三地址码呢?类型已经写进每个值(add i32 a, b),但值还不知道自己住哪个寄存器——它在 MIR 靠上的位置,正是"类型系统的遗产已入账、寄存器的现实还没登场"的过渡带。这两例的共性:档位看的是主表示携带什么,不看旁路信息带了什么。
最后回答一个自然的疑问:层次越多,转换开销是不是越大?会,但层次间转换是"一次性便宜"的——把高阶结构摊平是机械动作;层次内优化是"反复昂贵"的——每轮分析都是真正的计算。多付一点转换费,换每一层的优化都站在更合适的表示上,这笔账在真实编译器里几乎总是划算的。MLIR(第8章)把这笔账算得更极致:层次本身成了产品。
有了层次坐标,下一章先补齐语义分析与符号表——那是语法树变成可用 IR 之前的最后一道检查,然后我们正式进入中层表示的核心:三地址码与 SSA。