4.1 数据流分析框架
4.1 数据流分析框架
本节摘要:数据流分析框架把一切"值在程序点上怎么流动"的问题统一成同一副骨架:一个值域(通常是格)、一组传递函数、一个交算符,求一组数据流方程的不动点。分析的正确性由不动点定理兜底,分析的质量由格的精度与传递函数的单调性决定。本节把格、单调函数、不动点这三个概念一次讲清,并给出"前向/后向 × may/must"的四方分类。读完你应当能对一个新分析问题快速判断它是否落在这个框架里,以及它收敛到的是最精确解还是过近似解。
上一章结尾留下的问题是"SSA 还原之后做什么分析"。本章的回答从抽象开始:与其逐个背几十种经典分析,不如先掌握它们的公共形状——之后每遇到一个新分析,都是往这个形状里填三个空。
一、把"分析"压缩成三个填空
任何一条经典数据流分析,都在回答同一类问题:在每个程序点 n 上,某种抽象信息 IN[n] / OUT[n] 是什么?信息沿控制流传播:经过一条指令时被"加工"(传递函数),在控制流分岔/汇合时被"合并"(交算符)。于是整个分析只剩三个填空:
- 值域 L 是什么:到达定值用"定值集合"(位向量);活跃变量用"变量集合";常量传播用"变量到格值的映射";
- 方向是什么:信息随控制流走叫前向(到达定值),逆着走叫后向(活跃变量);
- 交算符 ∧ 是什么:多条边汇合时信息怎么合并——"路径上可能成立"取并(may),"所有路径都成立"取交(must)。
填完三个空,方程就是现成的。前向方程:IN[n] = ∧ OUT[p](p 遍历 n 的前驱),OUT[n] = f_n(IN[n])。后向方程把 IN/OUT 互换、前驱换后继。所谓"学习一种新分析",实为"识别它的三个填空"。
二、格:合并的数学
交算符不能乱取,否则迭代可能来回振荡或不收敛。格(半序集 + 最小上界 + 最大下界)正是为"合并"准备的结构。以到达定值为例:值域是全体定值集合的幂集,偏序取包含 ⊆,交算符取并 ∪。并之所以是"并",因为"可能到达"的语义本就允许多条路径的并集。
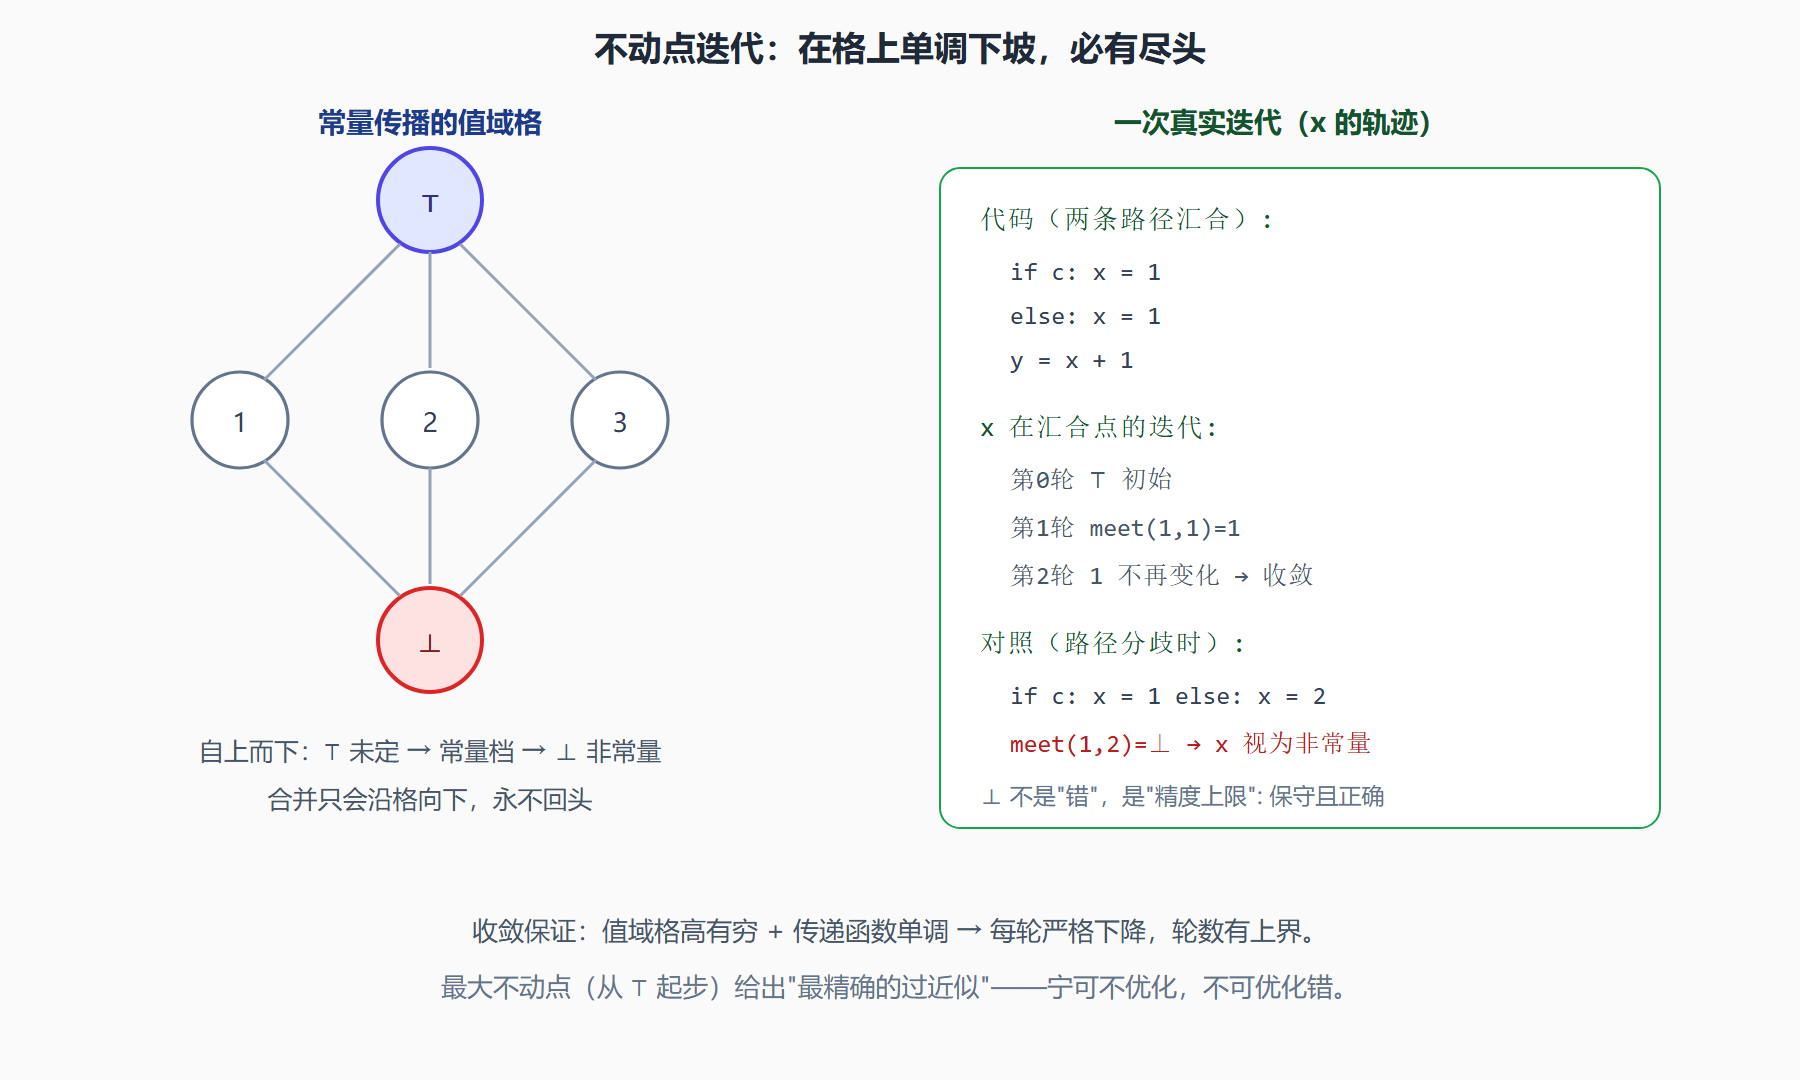
最值得琢磨的是常量传播的值域,它演示了"格的高度决定精度":
⊤ (未定:尚不知道,可能是任何值) / | \ 1 2 3 ... (每个常量一档,互相不可比) \ | / ⊥ (非常量:路径合并后不再可信) 合并规则: meet(⊤, c) = c 首次见到 meet(c, c) = c 两条路径一致 meet(c, c') = ⊥ 分歧 → 判为非常量 meet(⊥, ·) = ⊥ 污染不逆转
注意格高有穷是收敛的关键:每次合并要么不变要么沿格下降/上升一格,而有穷格不允许无限下降——这是不动点定理给工程的第一份保险。
图:格与不动点迭代——从 ⊤ 一路走到解
三、传递函数与单调性:分析正确性的全部家当
传递函数 f_n 描述"穿过指令 n 时信息怎么变"。对位向量分析它通常是 gen/kill 的并交组合:OUT = (IN − kill) ∪ gen(到达定值),IN = (OUT − def) ∪ use(活跃变量)。这类函数显然单调:输入集合越大输出越大。
一般地,框架只要求两件事:f 单调、∧ 由格的半序诱导。两者凑齐,Kleene/塔斯基的不动点定理保证迭代收敛到最精确的不动点。工程实现(4.2 的工作表算法)从不显式检查这两个条件——它们是设计者的证明义务,写进 pass 的注释与测试里。
四个象限的例子可以对号入座:到达定值(前向 may)、可用表达式(前向 must,交算符取交)、活跃变量(后向 may)、非常忙表达式(后向 must)。把任意一种分析塞进象限,它的方程、初值、初边值全部自动确定——这就是"框架"一词的实际含金量。
四、精度、复杂度与工程取舍
- 迭代次数的上界:粗略估计是"格高 × 节点数"。位向量分析格高最多是定值个数,实际程序 2–5 轮就收敛(逆后序遍历 CFG 能把轮数压到接近环数 +1);常量传播格高 3,但映射的规模是变量数。
- 过近似的方向性:may 分析从 ⊥ 起步会算出"过强的可能集"(错误优化),must 从 ⊤ 起步失之过弱(漏优化)。起点选错不是慢,是错——这是初学者最该死记的一条。
- 精度换不了的成本:想让常量传播跨过
⊥把meet(1,2)细分成"1 或 2"?那要换值域(路径分裂、条件常量传播),不是调参数。格的形状一旦定下,精度上限就定下了。
💡 关键直觉:数据流分析的每一步都"宁可信其无"。分析说"x 可能到达"时 x 未必真到达,但分析说"不可能到达"时 x 一定不在——优化的合法性全押在第二个方向上。
本节要点回顾:
- 三个填空:值域、方向、交算符——识别它们等于理解一种分析;
- 格:合并的数学,格高有穷保证收敛;常量传播的 ⊤/常量/⊥ 三层是范本;
- 单调传递函数 + 半序交算符 → 不动点定理兜底,迭代收敛到最精确过近似;
- 四象限:前向/后向 × may/must,四个经典分析各占一格;
- 起点纪律:may 从 ⊥、must 从 ⊤,方向错了不是慢而是错。
下一节把框架落到两个最常用的分析上,从初值到收敛手算一遍——理论第一次在纸上跑起来。
再进一步:框架视野下的三类延伸
前向还是后向,看信息的出生地。一个判断口诀:信息随"值的生产"流动就用前向(定值发生在前、使用在后),随"值的需求"回溯就用后向(使用点的需求反向通知定义点)。判断错了方向,方程照写、迭代照收敛,只是收敛到无意义的不动点——框架不替你做语义检查,方向是设计者的语义承诺。
位向量之外,还有宽窄之分。到达定值的值域是"定值集合",元素个数有限,位向量天然合身;常量传播的值域每变量三档(⊤/常量/⊥),映射的规模是变量数乘三——仍是"窄"值域。而指针分析(4.5)的值域是指向图,图的组合爆炸让"精确求解"彻底出局——那类问题在框架里只能选更粗糙的格。格的高度与宽度,直接预言了一个分析的可负担性:这是在选择值域时最值得先画的草图。
抽象解释:框架的理论名号。本章这套"格 + 单调函数 + 不动点"的体系,在学术语境里叫抽象解释——用抽象值域上的计算去"近似解释"程序的具体语义。它同时解释了静态分析为什么注定不完美:可判定性的墙立在那里,格的精度就是折衷的刻度。往下读 4.2 与 4.5 时留意:同一个框架,位向量跑得飞快,指向图走一步看一步——刻度不同的折衷,成本曲线完全不同。