4.5 指针分析与别名分析
4.5 指针分析与别名分析
本节摘要:指针分析与别名分析回答同一个问题的两面:指针 p 可能指向哪些内存对象(points-to 集),两个访问会不会摸到同一块内存(alias 判定)。它是 4.1 框架的又一次落地——值域从位向量换成指向图——但难度陡增:别名问题不可判定,任何分析都是近似;且近似质量的优劣直接决定 Memory SSA(3.4)、死存储删除、并行化这些下游优化敢不敢下手。本节讲 Andersen 与 Steensgaard 两大经典算法的建边规则与复杂度差异,说明流不敏感/上下文不敏感各丢了什么,并给出工程上的调档思路。读完你应当能为一段指针密集的代码手算 Andersen 分析,并能解释"为什么指针分析做不准,一切内存优化都虚"。
数据流分析的前两次落地(到达定值、活跃变量)都假设变量是名字可辨的标量。一旦指针入场,"x 是谁"本身成了问题——本节的分析对象从"值"变成了"指向关系"。
一、问题与不可判定性:为什么只能近似
先看指针分析的输出长什么样。对这段代码:
int a = 1, b = 2; int *p = &a; // p -> {a} int **q = &p; // q -> {p} *q = &b; // 经过 q 写:p -> {a, b} ← 间接写改变了 p 的指向 int r = *p; // 读 *p:可能读到 a 或 b 的值
别名判定从指向集直接导出:*q 与 p 是否别名?是——*q 写的就是 p。"两个表达式是否指向同一对象"这个判定喂给下游的每个内存优化:死存储删除需要确认两次写撞在同一地址,读提升需要确认 load 与 store 同址,向量化需要确认数组区间不交。判定错了方向,优化就是错的。
坏消息先说:别名问题是不可判定的(能归约到停机问题)。所以指针分析的全部家族都在做同一件事:选一个近似方向——只准多报("可能别名"),不准漏报。"p 可能指向 x"报多了,优化变得保守(性能损失);报少了,优化变得错误(正确性事故)。这个不对称性是本领域一切设计的出发点。
二、Andersen 分析:包含式,约束求解的胜利
Andersen(1994)把指针分析写成约束系统,逐条规则把赋值翻译成包含约束,解到不动点:
| 源语句 | 建的约束 | 读法 |
|---|---|---|
p = &x |
x ∈ pts(p) | x 直接进入 p 的指向集 |
p = q |
pts(p) ⊇ pts(q) | q 指的 p 都得指 |
p = *q |
对 q 指的每个 o:pts(p) ⊇ pts(o) | 解引用取内容 |
*q = p |
对 q 指的每个 o:pts(o) ⊇ pts(p) | 经过 q 间接写 |
求解就是把这些约束迭代到指向集不再增长。手算上面四行代码:初始 pts(p)={a}、pts(q)={p};*q = &b 触发"对 q 指的每个 o"——o 是 p,于是 pts(p) ⊇ {b},p 的指向集涨到 {a,b};p 的增长又让 q = &p 后所有"经过 p"的约束重算。注意约束的**级联**:一个指向集变大会激活一批新约束,这正是 4.2 工作表算法的形状——只是"变化的传播"发生在指向图上而非 CFG 上。
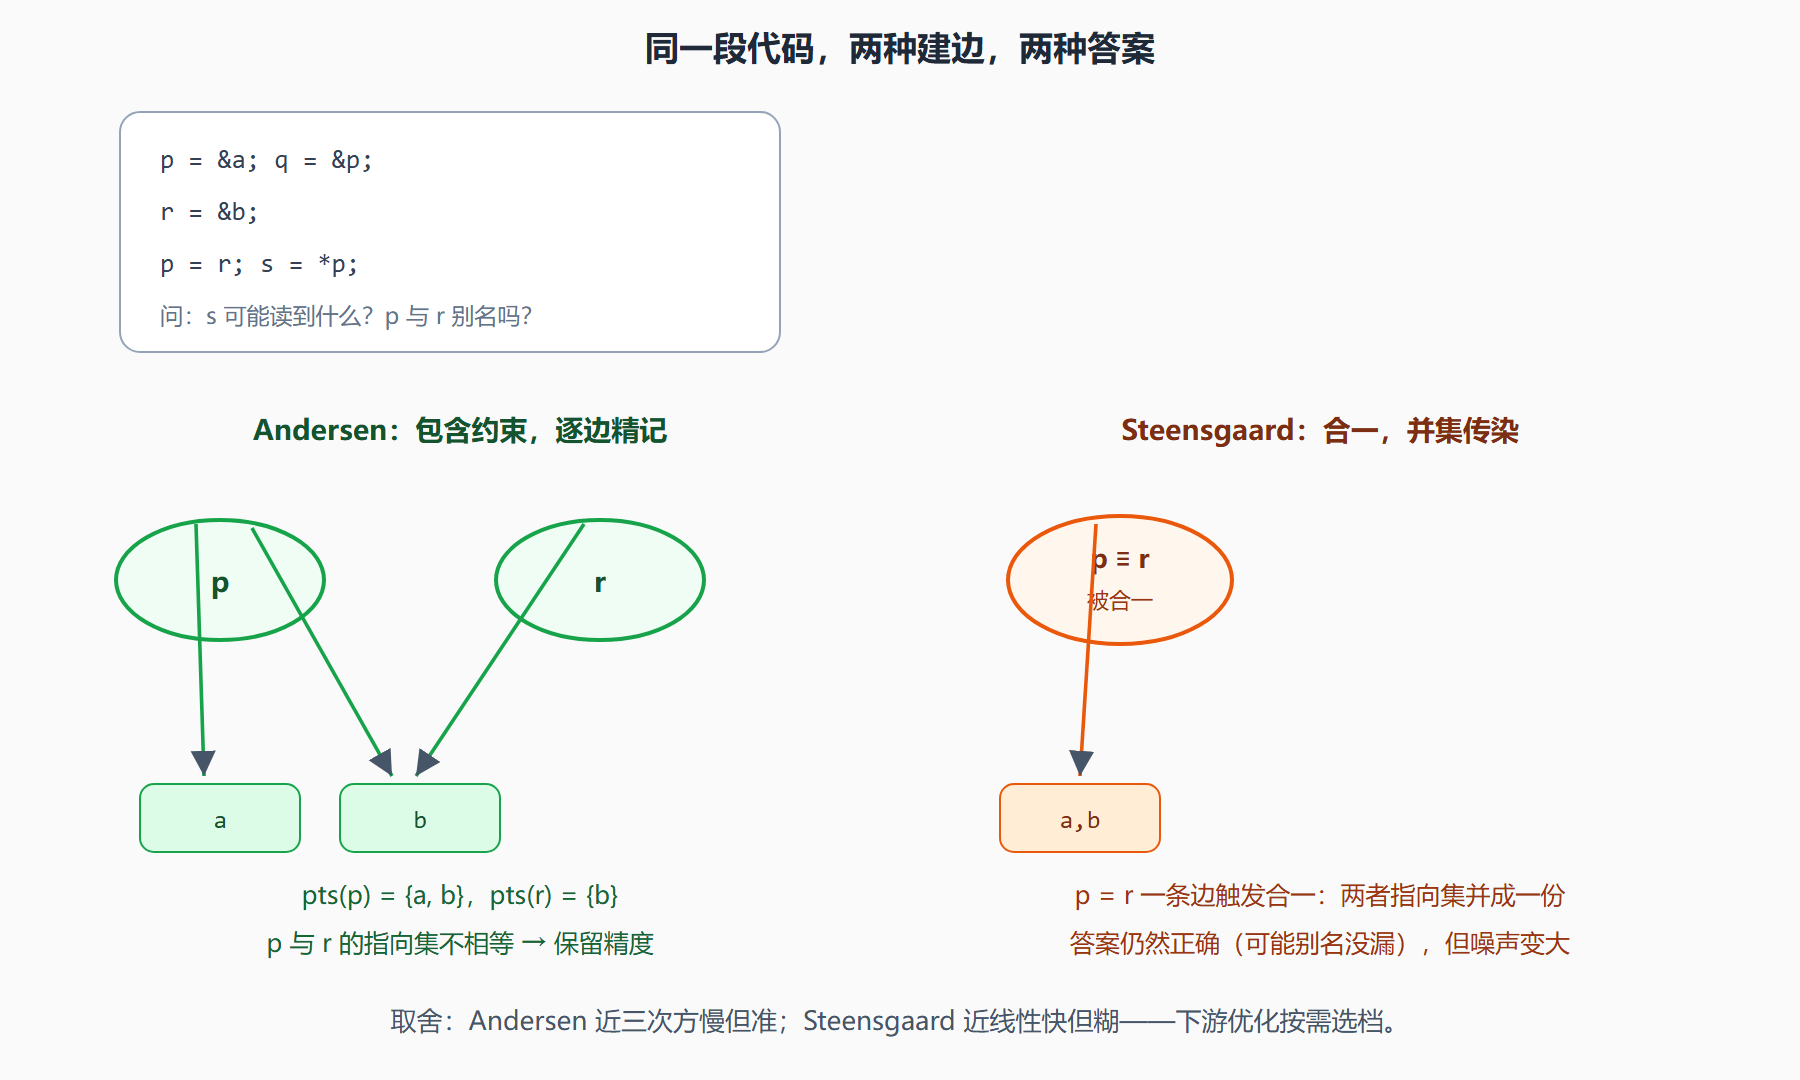
Andersen 的精度口碑来自包含式建模:p = q 不迫使 p、q 指向集相等,只要求单边包含,合并的噪声单向可控。代价是复杂度 O(n³)(n 为语句数),大规模程序要做批处理式的离线优化(约束图化简、场敏感)才压得住。
图:指向图上的两种建边——Andersen 与 Steensgaard
三、Steensgaard 与两大近似的取舍
Steensgaard(1996)把规则改成合一(unification):p = q 直接把 p、q 的等价类合并,指向集取并。合并可以用并查集实现,整体近乎线性——代价在上图看得一清二楚:一次 p = r 让两者的指向集永久绑定,此后所有经过 p 或 r 的推理共享同一份噪声。
| 维度 | Andersen | Steensgaard |
|---|---|---|
| 建边语义 | 包含(单边) | 合一(等价类) |
| 复杂度 | 近 O(n³) | 近线性 O(n·α) |
| 精度 | 高(噪声单向) | 低(并集互相污染) |
| 典型用途 | 编译器优化、安全审计 | IDE 即时提示、超大规模快速扫描 |
比"选哪个算法"更影响精度的是两把"钝刀":流不敏感(忽略语句顺序:无论赋值出现在哪个分支,指向集都进同一份全局答案——上面 r 的两条边在真实执行中可能永不共存,分析仍然合并)与上下文不敏感(函数 f 被两处调用,形参指向集取并——同一个 f 的两次调用互相污染)。恢复流敏感要把分析搬回 4.1 的 CFG 不动点框架(指向图作为格元素,代价翻几个数量级);恢复上下文敏感用调用串(call-string)或对象克隆,工程上常做"敏感 2 层封顶"的折中。
⚠️ 易错点:把"流敏感"当默认。多数产品编译器(包括 LLVM 的基础别名分析)默认配置是流不敏感的——看到
p = r后就断言"此后 p 与 r 必别名"是过度推理;正确读法是"可能别名"。把 may 当 must 用,是内存优化引入错误的头号来源。
四、接回主线:指向图如何喂饱下游
本节开头说指针分析是框架的又一次落地,现在闭环。值域:指向图的集合;方向:工程实现多为流不敏感,敏感版即前向数据流;合并:指向集取并(may 语义)。它产出的"可能别名"判定,就是 3.4 Memory SSA 版本链上每个 phi 的仲裁依据:别名分析说"这两个 store 地址必不同",版本链才敢把后一个写标成前一个写的"杀";说"可能相同",phi 就得保守地挂在那里。第5章的循环优化里,"两个数组访问是否别名"更是自动并行化的生死判定——指向图的精度,最终兑换成循环能不能变成 SIMD 指令。
本节要点回顾:
- 别名问题不可判定:一切指针分析都是"只多报不漏报"的 may 近似;
- Andersen:包含约束 + 工作表求解,精度高、近三次方复杂度;
- Steensgaard:合一 + 并查集,近线性、指向集互相污染;
- 两把钝刀:流不敏感丢顺序、上下文不敏感丢调用点,恢复任一都要付数量级代价;
- 下游接口:指向集 → 别名判定 → Memory SSA 的杀/留 → 死存储删除、读提升、并行化的合法性。
至此分析侧武器库齐备:格上不动点、位向量、支配树、指向图。下一章换成消费者视角——这些分析结果如何被一座座优化改写成更快的 IR。